
DFlash 2: ein 3.43×-Drafter, der unter Last auf 1.45× fällt
Veröffentlicht am 22. September 2026
Ein Drafter, der den ganzen Block auf einmal rät
Speculative Decoding hat überall dieselbe Form: Ein kleines Modell schlägt Tokens vor, das große Modell prüft sie in einem Durchgang, und was übersteht, wird behalten. Der Vorschlagsschritt ist dabei autoregressiv geblieben — ein Token, dann das nächste. DFlash 2 macht daraus einen einzigen Durchgang:
the entire block, every position, predicted in parallel.
— Inco AI
Ein leichtgewichtiger Selektor verfolgt anschließend einen kohärenten Pfad durch die Kandidaten, die an jeder Position übrig geblieben sind, und Two-Tap-Dynamic-Convolutions verhindern, dass der Draft zum Blockende hin abbaut. Der Hersteller beziffert den Preis der gesamten Konstruktion mit über 20% mehr Output pro Verifikationsdurchgang für rund 1% zusätzlicher Zykluslatenz. Die Convolutions sind dabei der günstige Teil: Sie fügen dem Draft-Verify-Zyklus 0.7% hinzu, während die zehn zusätzlichen Transformer-Layer, die eine vergleichbare Genauigkeit kosten würden, 15.2% hinzufügen.
Nichts davon soll verändern, was das Modell sagt:
Decoding is lossless: greedy output matches the target model exactly, and sampling preserves its distribution.
Der Pitch ist also sauber. Derselbe Text, weniger Sekunden. Die Frage ist, wie viel weniger — und unter welcher Last.
Fünf Wochen alt, und erst jetzt diskussionswürdig
Nichts davon ist diese Woche erschienen. Inco AI hat am 18. August zwei DFlash-2-Drafter veröffentlicht, einen für Qwen3.8-27B und einen für Muse Glimmer, und die Zahl, mit der man voranging, war eine Einzelanfrage-Zahl:
SGLang serves at 2.7–3.4× the throughput of autoregressive decoding at batch size 1
— Inco AI
Der Drafter ist am 17. September in unseren Feed gelangt, was eine Tatsache über den Feed ist und keine über das Projekt. Verändert hat sich das Intervall. Die vLLM-Implementierung der Methode wurde am 21. August gemerged — der Quick Start der Model Card verweist immer noch auf die Installation aus jenem Pull Request, #52816, was eher die Card datiert als das Ökosystem. Und ein Drafter, der für Qwen3.8-27B trainiert wurde, konnte nicht unter Last getestet werden, bevor er existierte, sodass jede Lastmessung, die es gibt — einschließlich der weiter unten beschriebenen Reproduktion bei concurrency 8 — nach dem Release entstanden ist.
Eine Sache, die der Hersteller beim Release getan hat, verdient es, benannt zu werden. Er hat die Tabellen für concurrency 8 und concurrency 32 selbst veröffentlicht, auf der Model Card, direkt unter der Schlagzeile. Die meisten Hersteller hätten das nicht getan. Deshalb geht es bei der Auseinandersetzung darum, wie man die Zahlen liest, und nicht darum, ob es die Zahlen überhaupt gibt.
Der Streit beginnt in den eigenen Tabellen des Herstellers
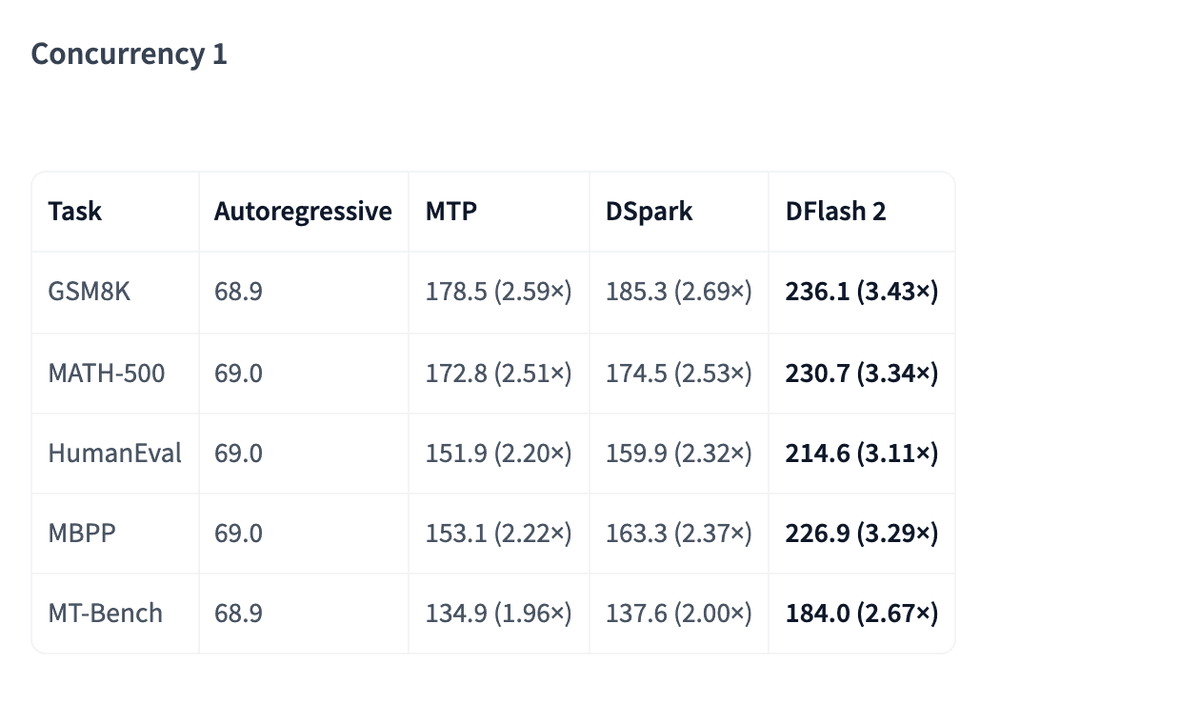
Jede Zahl auf der Model Card stammt aus einer einzigen Konfiguration: SGLang auf einem einzelnen NVIDIA H200, FlashAttention 3 sowohl für Target- als auch für Draft-Attention, Speculation-Blockgröße 8. Darunter liest sich die GSM8K-Kurve als 3.43× bei concurrency 1, 2.84× bei concurrency 8 und 1.45× bei concurrency 32.
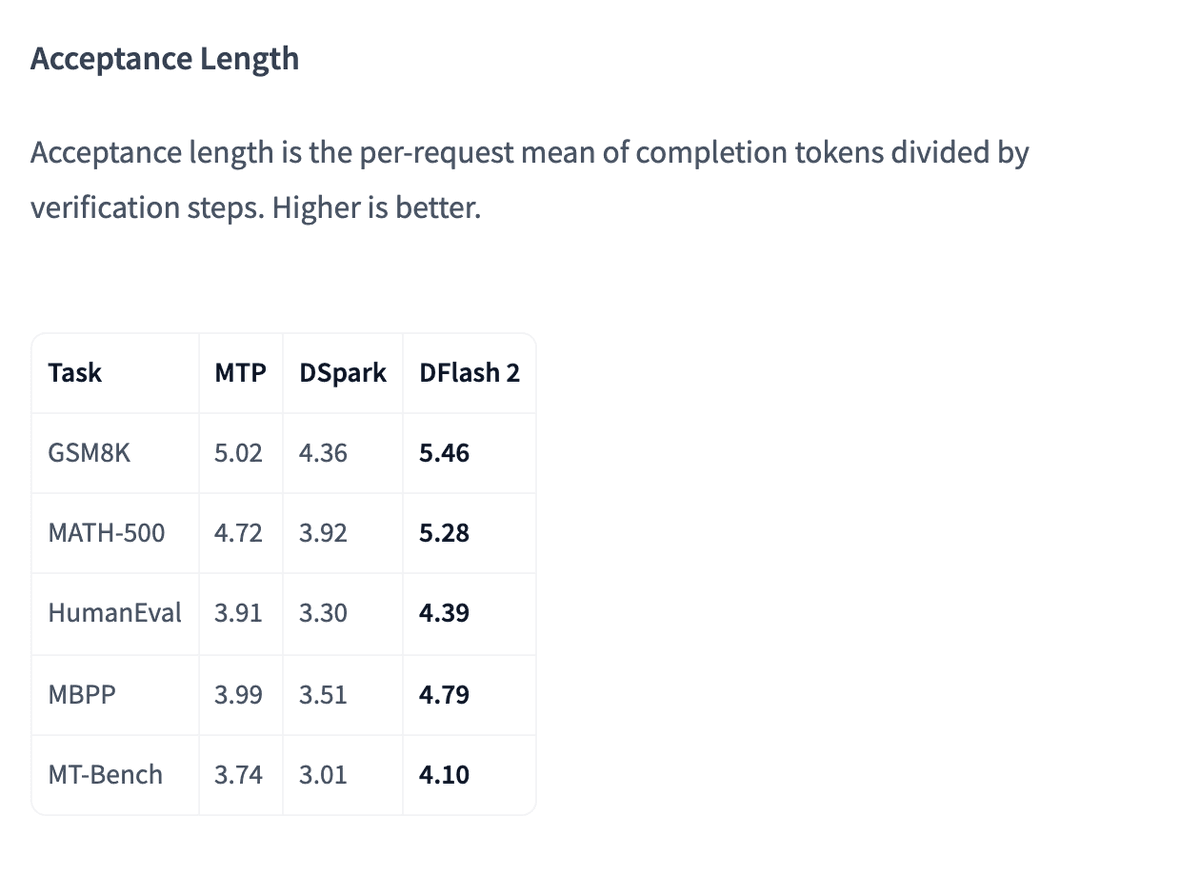
Der Aufgabentyp verschiebt das Ergebnis fast so stark wie die Last, und der Grund steht in der Tabelle oben auf dieser Seite. Acceptance Length — Completion-Tokens geteilt durch Verifikationsschritte — liegt bei 5.46 auf GSM8K und bei 4.10 auf MT-Bench. Bei offenem Chat überleben weniger gedraftete Tokens jeden Verifikationsschritt, es gibt also weniger zu gewinnen; MT-Bench landet folgerichtig bei 1.01×, während GSM8K 1.45× hält.
Der Abfall über die Last hat eine eigene Ursache, und es ist kein Bug. Das Erzeugen eines Tokens bewegt weit mehr Gewichtsdaten, als es Arithmetik verlangt, sodass die Multiplizierer einer GPU dabei größtenteils ungenutzt bleiben. Spekulation ist eine Möglichkeit, diese ungenutzte Kapazität zu verbrauchen. Batching ist eine andere — und es gibt nur einen gemeinsamen Pool.
The batch and the draft are drawing on the same account.
Diese Messung wurde auf AMD RDNA4 vorgenommen, nicht auf einem H200, und die Arithmetik ist spezifisch dafür: Draft-Kapazität pro Agent von (24 − batch_size) / batch_size, was etwa 23 Tokens Spekulation für einen einzelnen Agenten ergibt und etwa 2 pro Agent, sobald acht laufen. Andere Hardware, dieselbe Form — und es ist genau die Form, die auch die eigenen Tabellen der Model Card zeichnen.
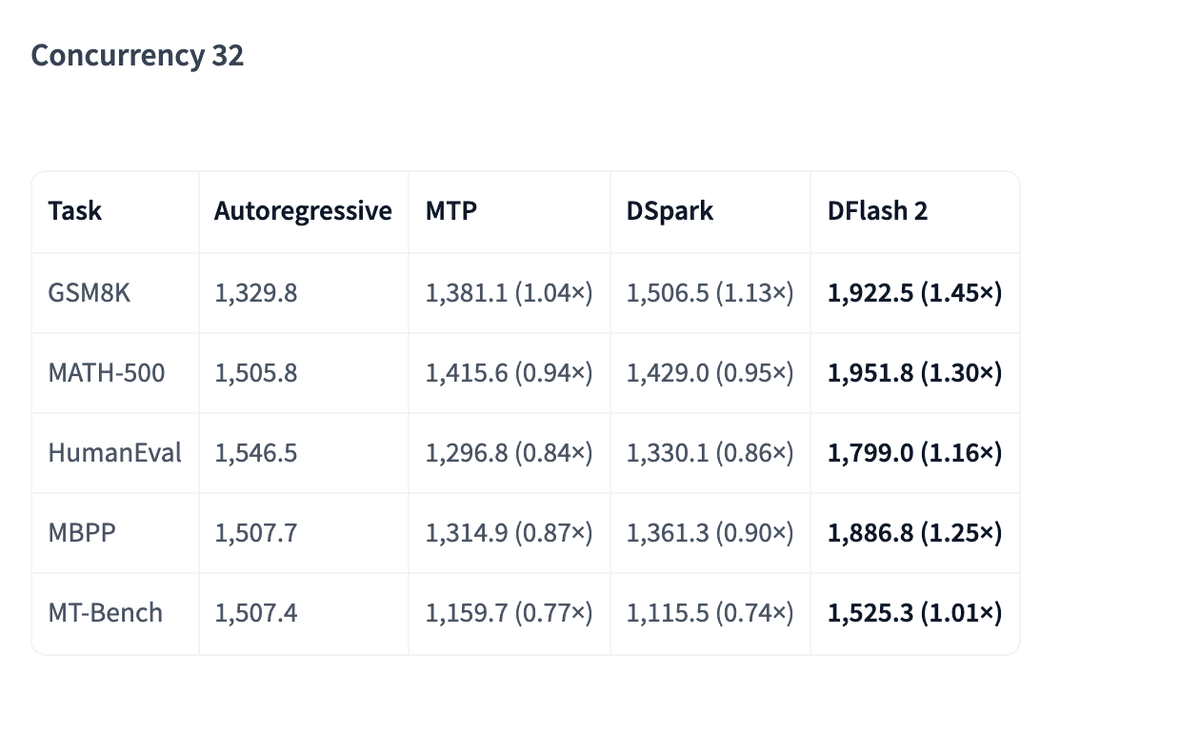
Sehen Sie sich an, was den Nachbarn in diesem Bild passiert. Bei concurrency 32 liegen MTP und DSpark bei MATH-500, HumanEval, MBPP und MT-Bench unter 1.00×. Spekulation hilft dort nicht bloß nicht — sie nimmt Throughput weg. DFlash 2 bleibt bei allen fünf Aufgaben über Wasser, was ein reales Ergebnis ist — nur eben nicht das Ergebnis, das jemand zitiert.
Der Fehlermodus, den das in der Praxis erzeugt, ist ein Planungsfehler, kein technischer:
sees 2.5x speedup, ships it — then observes 5% regressions in production where p50 concurrency is 16
— Tian Pan
Zweite Kostenstelle, und diese ist ein Correctness-Problem statt eines Performance-Problems. Mit der Cookbook-Konfiguration für DFlash 2 mit Qwen3.8-27B auf SGLang:
under high concurrent load, sometimes the last user message is appended to the wrong context
L3tum arbeitete auf einer RTX Pro 6000. Was es schwer macht, den Report abzutun, ist, dass eine zweite Person ihn auf anderer Hardware reproduziert und dann gemessen hat: gabrielbryk, auf einem DGX Spark gegen ein NVFP4-Target, protokollierte 7 falsche Antworten in 100 Anfragen bei concurrency 8, gegenüber 0 in 100 bei serieller Ausführung derselben Konfiguration und 0 in 304 bei ausgeschalteter Spekulation. Weitet man die betroffenen Fälle zu einer größeren Stichprobe aus, liegt die Fehlerrate innerhalb dieser Teilmenge bei 111 von 304 — das ist die Zahl, die zitiert wird, und nicht die Rate, die Ihr Traffic sehen würde. Innerhalb dieser erweiterten Menge senkte der Wechsel des Targets auf einen dichten BF16-lm_head die 111 Fehler auf 1, ohne sie zu eliminieren, was dafür spricht, dass die Abweichung im Verifikationspfad unter Batch-Zusammensetzung liegt und nicht in einem Quantisierungsartefakt. Das sind keine Abstürze. Es sind wohlgeformte Completions, die die Vorgaben korrekt wiederholen und dann eine andere Frage beantworten. Die Rückkehr zu MTP ließ sie aufhören. Es gibt keinen veröffentlichten Fix.
Drittens, Speicher. Die Model Card nennt 2B Parameter in BF16 für den Drafter und rechnet das nirgends in Gigabyte oder einen Anteil am Pool des H200 um.
Spec decode isn't free. You're paying VRAM for both models simultaneously.
Dieser Beitrag handelte von einem 4B-Draft-Modell, nicht von DFlash 2, und übertragbar ist die Buchhaltung, nicht die Zahlen: Beide Modelle liegen gleichzeitig im Speicher, der Serving-Stack allokiert im Voraus mehr, als man geschätzt hat, und die beiden angebotenen Fixes sind, den Draft zu verkleinern oder die Parallelität zu senken. Der Wechsel auf einen 0.6B-Draft gewann dort rund 2 GiB zurück. Beide Maßnahmen schmälern den Speedup, den man sich erkauft hat.
Zur Verteidigung des Herstellers: Er hat den Abfall veröffentlicht, er hat eine Definition von Acceptance Length veröffentlicht, gegen die man seine Tabellen prüfen kann, und er war ehrlich darüber, wie der Vergleich zustande kam.
We trained the DFlash and DSpark drafters ourselves under matched setups, while MTP ships with the model.
— Inco AI
Lesen Sie das zweimal. Es ist gleichzeitig ein Beleg guter Praxis und eine Warnung: Zwei der drei Baselines, die DFlash 2 schlägt, sind die eigenen Reimplementierungen des Herstellers.
Wo die Concurrency-Frage wieder auftaucht
Die meisten Leser werden nie die GPU besitzen, auf der der Drafter läuft. Was sie besitzen, ist die Orchestrierung davor, und für sie schrumpft die ganze Frage auf eine Zahl: Wall-Clock-Zeit auf den eigenen Prompts bei der eigenen Concurrency. Das lässt sich an einem Nachmittag bauen. Nehmen Sie die zwanzig oder dreißig Prompts, die Ihr Produkt tatsächlich verschickt, packen Sie sie in einen Latenode-Workflow, der zwei Endpunkte aus einem Katalog von rund 335 Modellen aufruft, und lassen Sie einen JavaScript-Node — der jede beliebige NPM-Bibliothek installieren kann — jeden Aufruf timen und das Paar loggen. Dann hören Sie auf, das nacheinander laufen zu lassen. Feuern Sie den Workflow parallel ab, um die Last zu reproduzieren, die Sie bedienen: Ein bezahlter Plan enthält 5 parallele Execution Worker, weitere sind als Add-on für $10 pro Worker und Monat erhältlich, sodass die Concurrency in Ihrem Test eine Zahl ist, die Sie selbst gewählt haben und neben dem Ergebnis nennen können — genau das, was die Herstellertabellen tun und die meisten internen Benchmarks nicht. Der Zähler spielt bei dem Experiment mit: Latenode berechnet die CPU-Sekunden, die ein Lauf tatsächlich verbraucht, nicht pro Node und nicht pro API-Aufruf, ohne Mindestzeit pro Ausführung, sodass ein Sweep aus ein paar Hundert kurzen Läufen die Sekunden kostet, die er braucht, statt einer Pauschale pro Lauf. Es gibt keine DFlash-2- oder SGLang-Integration in Latenode, und dieser Artikel behauptet auch keine; die Decoder-Geschwindigkeit bleibt das Problem des Anbieters. Übertragbar ist die Messung selbst, aufgenommen unter Ihrer eigenen Last statt unter der des Benchmarks.
Wer den Nachmittag investieren sollte
Setzen Sie es ein, wenn Ihre Workload wirklich wie der Benchmark aussieht: lange Generationen, wenige gleichzeitige Anfragen, eine Karte der H200-Klasse, ein Target aus der Qwen3.8-Familie und SGLang oder ein vLLM, das neu genug ist, um den August-Merge zu enthalten. Batch-Dokumentenverarbeitung über Nacht, ein Coding-Assistent für einen einzelnen Entwickler, ein interner Agent, hinter dem sich sonst niemand einreiht. In diesem Regime sind die Acceptance Lengths bei jeder gemessenen Aufgabe die besten der drei Drafter, und 3.43× ist real.
Setzen Sie es dieses Quartal nicht in einem geteilten Serving-Tier ein. Zwei Gründe, und der zweite ist der disqualifizierende. Das Throughput-Argument dünnt genau dort aus, wo Produktion stattfindet:
Above that, the gains from speculation are consumed by verification overhead at scale.
— Tian Pan
Und dass sieben von hundert Anfragen bei concurrency 8 eine selbstsichere falsche Antwort liefern, während dieselbe Konfiguration mit ausgeschalteter Spekulation keine einzige liefert, ist kein Tuning-Parameter. Bis dieses Issue geschlossen ist, lautet die ehrliche Position: DFlash 2 ist ein guter Drafter mit einem ungelösten Integrationsbug in genau dem Stack, auf dem das eigene Cookbook zum Betrieb rät.
Wenn Sie trotzdem evaluieren, messen Sie zwei Dinge, die die Card Ihnen nicht liefert: den residenten Speicher mit geladenem Drafter und Ihren echten KV-Cache-Einstellungen, und die Antwortgenauigkeit bei Ihrer p50-Concurrency statt bei einer einzigen Anfrage. Beide sind günstig zu messen. Beide sind die Zahlen, die den Ausschlag geben.
So war der Stand am 22. September 2026. Projekte entwickeln sich schnell – prüfen Sie die Quelle, bevor Sie sich darauf verlassen.
Häufige Fragen
- Wovon hängen die veröffentlichten Zahlen außer vom H200 noch ab?
Die Blockgröße ist 8, das heißt sieben Draft-Tokens pro Verifikationsschritt; das Sampling folgt Qwen3.8s empfohlener Temperature 1.0, Top-p 0.95, Top-k 20; und der Output ist auf 4,096 Tokens gedeckelt. Jede Throughput- und Acceptance-Length-Zahl auf der Card wurde unter genau dieser Kombination erzeugt, sodass ein Deployment, das in irgendeinem dieser Punkte abweicht, erst nach eigener Nachmessung vergleichbar ist.
- Läuft das auch auf vLLM?
Die vLLM-Implementierung wurde am 21. August 2026 gemerged, die Methode existiert also upstream dort ebenso wie in SGLang. Die Card ist nicht auf dem aktuellen Stand: Ihr Quick Start verweist weiterhin auf die Installation aus Pull Request #52816, der noch nicht gemerged war, als die Card veröffentlicht wurde. Prüfen Sie Ihre vLLM-Version gegen den Merge-Zeitpunkt, statt sich auf die Card zu verlassen. Beachten Sie außerdem, dass die Correctness-Reports bei concurrency 8 gegen SGLang erstellt wurden – vLLMs Verhalten unter derselben Last ist damit öffentlich ungemessen und nicht etwa sauber.
- Funktioniert DFlash 2 nur mit Qwen3.8-27B?
Ein DFlash-2-Drafter wird gegen ein einziges Target trainiert, und es wurden zwei veröffentlicht: dieser hier und ein Drafter für Muse Glimmer, für den der Hersteller 3.1–4.6× statt 2.7–3.4× angibt. Das August-Release deckte genau diese zwei Targets ab und keine weiteren, und die veröffentlichten Messungen des Herstellers decken nur den H200 ab. Den Drafter mit einem Target zu koppeln, gegen das er nicht trainiert wurde, ist keine Konfigurationsoption.
- Ist der Output wirklich identisch zum Basismodell?
Das ist die mathematische Behauptung, und die Mathematik selbst steht nicht infrage: Greedy Decoding trifft das Target exakt, und Sampling erhält dessen Verteilung. Ob die Implementierungen sich daran halten, ist offen. Die falschen Antworten bei concurrency 8 sehen nach einem Serving-Integrationsfehler aus, einer Divergenz im Verifikationspfad unter Batch-Zusammensetzung — aber die Person, die sie gemessen hat, verweist auf einen zweiten Report, z-lab/dflash issue 159, über Greedy-Divergenz gegenüber reinem autoregressivem Decoding in MLX, ganz ohne SGLang, und räumt ein, dass ein Teil davon im Verifikationsvertrag selbst liegen könnte. So oder so zählt die Unterscheidung für die Leute, die es reparieren, und überhaupt nicht für die Leute, die die falsche Antwort bekommen.
- Warum berichten manche von Acceptance Lengths weit unter den 5.46 der Card?
Weil Acceptance Length eine Eigenschaft des gesamten Deployments ist, nicht des Drafters allein. Ein offener Report im DFlash-Tracker, z-lab/dflash issue 170, nennt rund 3 auf llama.cpp gegenüber rund 5.5 auf vLLM — aber die Runtime ist nicht das Einzige, was hier abweicht. Die Targets sind unterschiedliche Checkpoints, ein Q6_K-GGUF gegenüber einem AWQ-MXFP4-Build, und auch die beiden Drafter sind unterschiedlich quantisiert. Die naheliegendste Hypothese des Reporters, so im Issue-Titel formuliert, ist die Target-Paarung und nicht die Engine. Prüfen Sie die Checkpoints, bevor Sie der Runtime die Schuld geben, und lesen Sie 5.46 als Zahl, die eine bestimmte Konfiguration hervorgebracht hat, nicht als Ziel, das Ihr Deployment verfehlt hätte.