
Jev Ultrafast: Der Browser-Agent, der das Schreiben aufgab
Veröffentlicht am 22. September 2026
Ein Browser-Agent ohne Text-Generierung
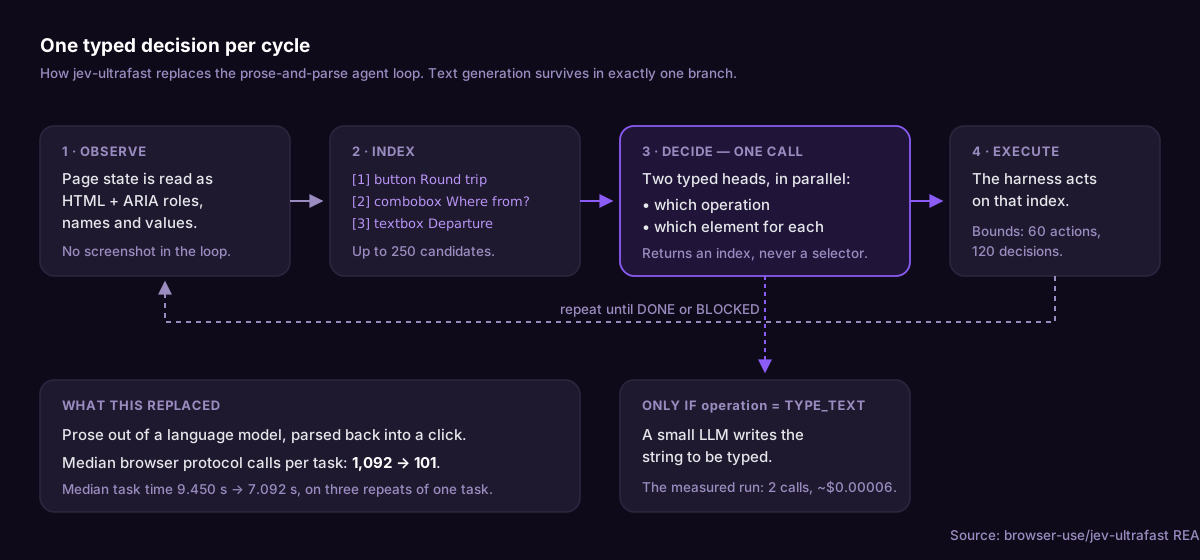
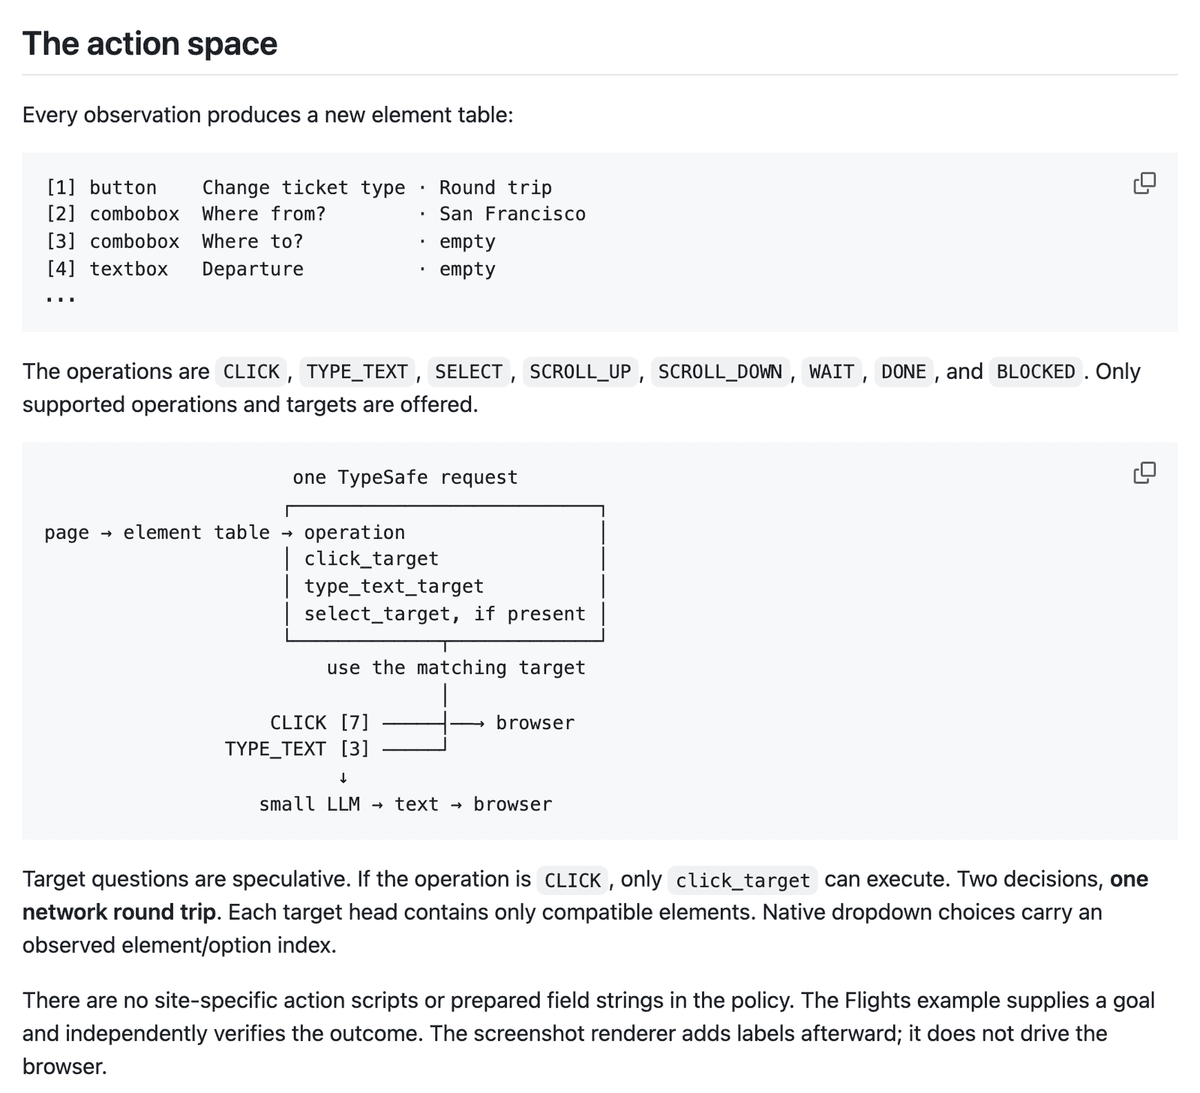
Die meisten Browser-Agenten fragen ein Sprachmodell in Prosa, was als Nächstes zu tun ist, und parsen die Prosa anschließend zurück in einen Klick. browser-use/jev-ultrafast tut das nicht. Bei jeder Beobachtung baut es eine indexierte Tabelle der zugänglichen Elemente der Seite und stellt dann TypeSafes Jev-Modell zwei getypte Fragen auf einmal: welche Operation und welches Element für jede angebotene Operation.
One request per decision cycle. Operation and target heads share the same observed state.
— browser-use/jev-ultrafast README
Das Operationsvokabular umfasst acht Einträge: CLICK, TYPE_TEXT, SELECT, SCROLL_UP, SCROLL_DOWN, WAIT, DONE, BLOCKED. Angeboten werden nur die Operationen, die der jeweilige Seitenzustand unterstützt. Nichts, was das Modell zurückgibt, wird je zu einem Selektor, einer Koordinate oder ausführbarem JavaScript — es liefert einen Index in eine Tabelle, die das Harness gebaut hat.
Sprachgenerierung überlebt an genau einer Stelle:
A small LLM writes text only when the operation is TYPE_TEXT.
— browser-use/jev-ultrafast README
Das ist das gesamte Design. Ein schneller Klassifikator entscheidet, ein kleines Modell tippt, und ein deterministischer Executor validiert das Ziel — Dokumentaktualität, Geometrie, Klick-Verdeckung — bevor er irgendetwas berührt.
Warum es diese Woche auftauchte
TypeSafe öffnete Jev am 20. September für die Öffentlichkeit, fünf Tage nach der Ankündigung. jev-ultrafast war das sichtbarste Projekt, das darauf aufgebaut wurde: rund 17.000 Stars innerhalb einer Woche, und das Token jev tauchte im selben Sieben-Tage-Feed in 74 verschiedenen Eintragsnamen auf. Das ist nicht ein einzelnes trendendes Projekt. Es ist ein Ökosystem, das sich um ein Modell bildet, das mit einem ungewöhnlichen Pitch auf den Markt kam:
Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out.
Der Agent ist der Beweis, dass der Pitch den Kontakt mit etwas Unordentlichem übersteht. Die eigene Messdatei des Projekts berichtet, dass eine Suche von Zürich nach London auf Google Flights insgesamt 7,1 Sekunden dauerte, einschließlich Seitenaufrufen und dem Text, den das Modell in die Felder tippte. Im Vergleich zur bisherigen Architektur des Projekts:
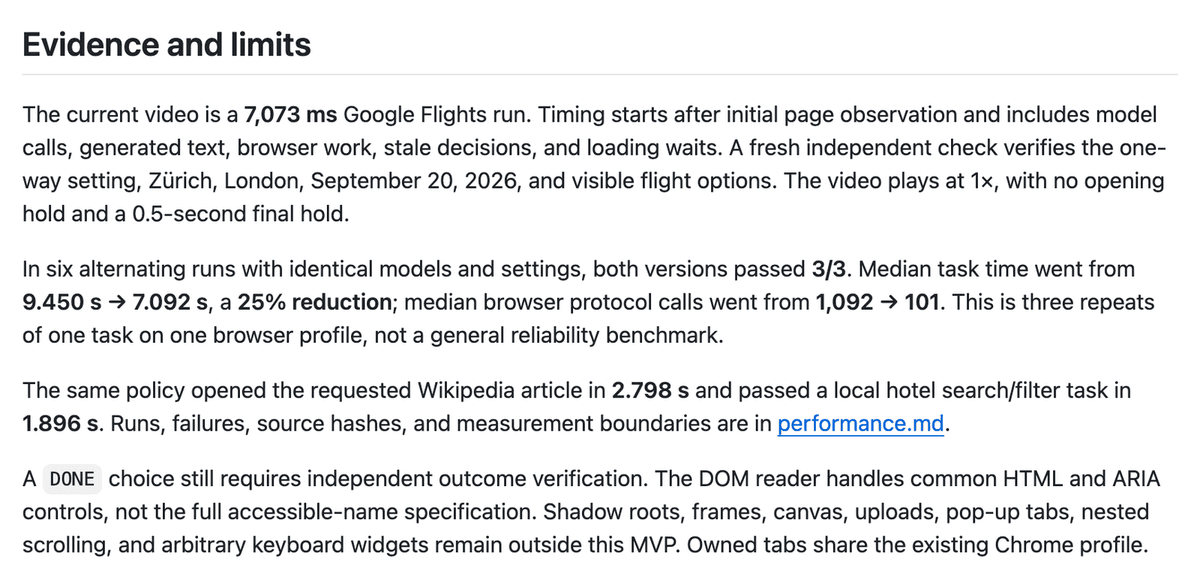
Median task time went from 9.450 s → 7.092 s, a 25% reduction; median browser protocol calls went from 1,092 → 101.
— browser-use/jev-ultrafast README
Die 25 % sind die Schlagzeile. Der zehnfache Rückgang bei den Browser-Protokollaufrufen ist die interessante Zahl, denn das ist der Teil, der skaliert: Weniger Round-Trips pro Entscheidung bedeuten, dass die Kosten für hundert parallel laufende Sitzungen entsprechend sinken.
Worüber tatsächlich gestritten wird
Niemand hat bisher eine Kritik an diesem Agenten veröffentlicht. Er tauchte am 16. September im Feed dieser Woche auf, hat einen einzigen Contributor, keine veröffentlichten Releases und fünf Tage alte Commits, und die einzigen öffentlichen Messungen dazu stammen vom Projekt selbst. Ehrlich berichtet: Die eigentliche Uneinigkeit liegt eine Ebene tiefer, beim Modell, auf dem der Agent aufbaut — und das meiste davon überträgt sich.
Das Projekt ist ungewöhnlich offen über die Grenzen seiner eigenen Zahlen:
This is three repeats of one task on one browser profile, not a general reliability benchmark.
— browser-use/jev-ultrafast README
TypeSafes Ankündigung stellt eine starke Behauptung über die Architektur auf: Weil Jev vollständig auf String-Generierung verzichtet und stattdessen einen Wert aus einem Schema zurückgibt, könne es nicht halluzinieren. Die eigenen Diagramme des Anbieters weisen dafür bei beiden Fehlermessungen null aus:
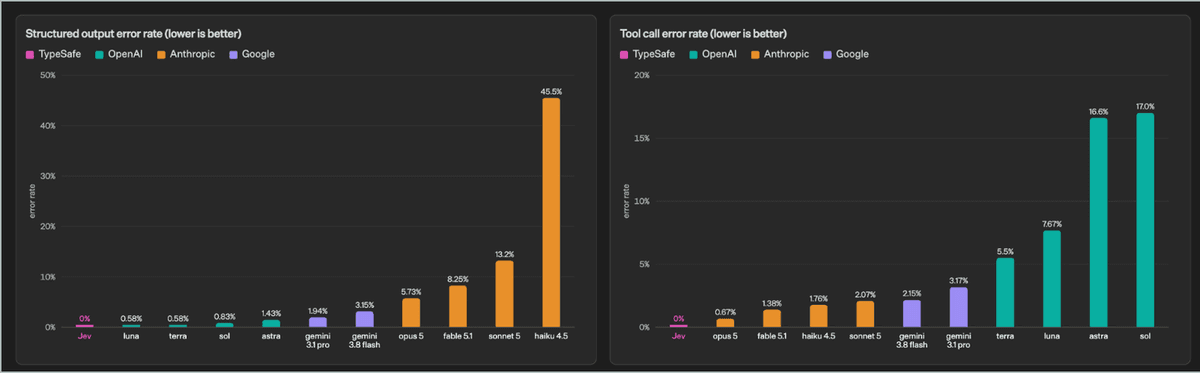
Der schärfste Einwand gegen Jev betrifft, was diese Garantie tatsächlich wert ist:
"Zero hallucination" = schema guarantee, not correctness guarantee — understand this distinction before building.
Das trifft den Agenten unmittelbar. Seine DONE-Operation ist eine getypte Entscheidung wie jede andere, und das README räumt ein, dass eine DONE-Entscheidung weiterhin eine unabhängige Ergebnisprüfung erfordert. Ein wohlgeformtes DONE, das falsch ist, sieht exakt so aus wie ein wohlgeformtes DONE, das richtig ist.
Unabhängiges Benchmarking von Jev steht noch ganz am Anfang. Das Projekt jev-capability-atlas ließ Jev und die Laya-Familie erstmals auf identischen Eingaben laufen und stellte fest, dass der Trade-off in beide Richtungen real ist:
Laya's fine-tuned specialist does beat Jev by 3 points on its own training distribution
— Zaious, jev-capability-atlas
— bei einem fünffachen Kalibrierungsfehler, und unterhalb einer eingabeblinden Baseline, sobald man von seiner eigenen Verteilung abweicht — dort fanden dieselben Tester Laya im Chinesischen weit abgeschlagen. Auch Jev hat sein eigenes Sprachproblem: TypeSafe gibt an, dass Jev bei CJK-Sprachen weniger genau ist, und der Atlas hat sich vorgenommen, das zu messen, statt es einfach zu glauben. Beim chinesischen Korrekturlesen erkannte es 67 % der falschen Zeichen bei einem Konfidenzschwellenwert von 0,5, mit einer Falschalarmquote von 12 % auf dem SIGHAN-Datensatz. Eine Anhebung der Schwelle auf 0,7 senkte die Falschalarme auf 5 % und die Trefferquote auf 38 %. Und es gibt einen kommerziellen Vorbehalt zum Kostenargument, von dem die Wirtschaftlichkeit des Agenten abhängt:
vendor says it can't prove the price isn't subsidized — treat it as today's price.
Ein weiterer Einwand stammt nicht von diesem Projekt selbst, sondern von einem Schwesterprojekt: Ein Tester bei jaredpalmer/kev fand ein getyptes Entscheidungsmodell, das Schwellenwertvergleiche und Ordinalzuordnungen korrekt handhabte, aber zwei Daten nicht voneinander subtrahieren konnte, und behob das, indem er die Anzahl der Tage in den Zustand legte, statt sie zu erfragen. Anderes Modell, gleiche Lektion: Getypte Entscheidungen sind nur so gut wie das, was man ihnen mitgibt.
Wo das in eine Pipeline passt
Das Muster, das sich zu stehlen lohnt, ist nicht das Modell. Es ist die Aufteilung: die deterministische Arbeit deterministisch erledigen und einen Modellaufruf nur für den einen Schritt ausgeben, der wirklich Urteilsvermögen braucht. Deshalb sank die Zahl der Protokollaufrufe um eine Größenordnung — das meiste, was eine Agentenschleife tut, war nie ein Reasoning-Problem.
Diese Form lässt sich schon heute in Latenode bauen, ganz ohne die oben genannten Bausteine. Der Cloud-Headless-Browser bietet vollständiges Puppeteer, sodass Navigation, Wartezeiten, Formularausfüllung und Extraktion Code sind, der bei jedem Lauf dasselbe tut, auf Browsern, die man weder installieren noch patchen noch am Laufen halten muss. Wie viele dieser Läufe gleichzeitig ablaufen, ist eine Obergrenze, für die man plant, keine freie Variable: Die Größe heißt max execution workers, die Anzahl der Workflow-Läufe, die ein Workspace gleichzeitig verarbeiten kann. Ein kostenpflichtiger Plan enthält fünf, und darüber hinaus ist Parallelität ein Reserved-Worker-Add-on für 10 $ pro Worker im Monat. Stapelt man tausend Seiten, reihen sie sich hinter dieser Zahl ein. Drumherum kümmert sich ein JavaScript-Node mit der NPM-Registry um Zustand und Validierung, und man ruft ein Modell — aus dem Katalog unter /ai-models — nur an der Verzweigung auf, an der die Seite wirklich mehrdeutig ist. Das Abrechnungsmodell belohnt dieselbe Aufteilung. Latenode misst die CPU-Sekunden, die ein Lauf tatsächlich verbraucht, ohne Mindestabrechnung pro Ausführung — eine Aufgabe, die in 7,1 statt 9,5 Sekunden fertig ist, kostet also wirklich weniger, und zwar proportional; über einen Batch hinweg summiert sich die Differenz. Der Mechanismus ist es wert, präzise benannt zu werden, weil man ihn leicht verkehrt herum versteht: Der Zähler bepreist Laufzeit, nicht Aufrufe. Tausend Browser-Round-Trips kosten auf einer Pro-Operation-Plattform tausend abrechenbare Operationen; hier kosten sie genau die Zeit, die sie brauchen, sodass eine geschwätzige Agentenschleife nur so teuer ist, wie sie langsam ist. Es gibt keine Jev-Integration in Latenode, und dieser Artikel behauptet auch keine; der nützliche Import ist die Architektur.
Wer sich damit beschäftigen sollte
Lesen Sie das Design-Dokument, wenn Sie Browser-Automatisierung bauen. Die Idee, dass der Aktionsraum vom Harness aufgezählt und vom Modell nur indiziert werden sollte, ist eine Stunde wert — ganz gleich, ob Sie je TypeSafe aufrufen oder nicht.
Setzen Sie es dieses Quartal nicht in Produktion ein. Die Liste der nicht unterstützten Fälle disqualifiziert es für die meisten echten Websites:
Shadow roots, frames, canvas, uploads, pop-up tabs, nested scrolling, and arbitrary keyboard widgets remain outside this MVP.
— browser-use/jev-ultrafast README
Alles hinter einem iFrame — Zahlungsformulare, eingebettete Picker, die meisten Consent-Flows — fällt raus. Ebenso jeder Upload. Rechnet man eine Single-Vendor-Abhängigkeit von einer Early-Access-API hinzu, deren Preise der eigene Anbieter nicht als final bezeichnet, dazu keine getaggten Releases und eine Erfolgsbilanz von drei Aufgaben, ist das Risiko offensichtlich.
Die Richtigen, um es jetzt schon einzusetzen, sind diejenigen, die es messen können: eine eigene Task-Suite, auf den eigenen Seiten, öffentlich berichtet. Das ist es, was dem Ökosystem fehlt, und es ist billig zu produzieren.
So war der Stand am 22. September 2026. Projekte entwickeln sich schnell – prüfen Sie die Quelle, bevor Sie sich darauf verlassen.
Häufige Fragen
- Brauche ich ein TypeSafe-Konto, um jev-ultrafast auszuführen?
Ja. Der Agent braucht TYPESAFE_API_KEY für das Entscheidungsmodell und einen separaten TEXT_MODEL_API_KEY für das kleine Schreibmodell. Die Beispielkonfiguration verweist beim zweiten Key auf OpenRouter und das Modell inception/mercury-2.5, mit deaktiviertem Reasoning, aber Gemini, GLM oder DeepSeek funktionieren über denselben OpenAI-kompatiblen Helper.
- Schaut sich der Agent Screenshots der Seite an?
Nicht in der Standardschleife. Er liest strukturierten Zustand - HTML sowie ARIA-Rollen, Namen, Werte und sichtbaren Text - und baut daraus eine indexierte Tabelle von Kandidatenelementen. Screenshots erscheinen im lokalen Inspector für Menschen, nicht im Entscheidungspfad.
- Wie lange kann ein einzelner Lauf dauern?
Sechzig Browser-Aktionen und 120 Entscheidungsanfragen, je nachdem, was zuerst eintritt. Pro Beobachtung werden bis zu 250 Aktionskandidaten vorgehalten, und alles, was darüber hinaus abgeschnitten wird, kann gar nicht ausgewählt werden - ein echter Fehlermodus bei sehr langen Seiten.
- Wie fixiere ich eine Version von etwas ohne Releases?
Sie fixieren einen Commit-Hash, was bedeutet, dass Sie die Upgrade-Entscheidung vollständig selbst verantworten. Es gibt keine Release Notes zu lesen, kein Semantic-Version-Signal dafür, dass eine Änderung breaking ist, und keinen Tag, zu dem man zurückrollen könnte - planen Sie also ein, den Diff bei jedem Wechsel selbst zu lesen, und vendoren Sie die Abhängigkeit, falls eine stille Upstream-Änderung schaden würde.
- Was kostet eine Entscheidung?
TypeSafe gibt Input mit 0,042 $ pro Million Tokens an, Output ist kostenlos. Der gemessene Google-Flights-Lauf verursachte zusätzlich rund 0,00006 $ für zwei Aufrufe des kleinen Textmodells - in dieser Größenordnung kostet die Browserzeit also mehr als die Inferenz.