
Laya auf der Neural Engine: 4.98 ms und 0.154 J pro Entscheidung
Veröffentlicht am 22. September 2026
Eine Entscheidung, bepreist in Millisekunden und Joule
mizorewww/laya-coreml nimmt Layas Typed-Decision-Checkpoints, konvertiert sie nach Core ML und lässt sie auf der Apple Neural Engine laufen. Das Ergebnis dieser Arbeit ist keine neue Fähigkeit. Es ist eine Preisliste.
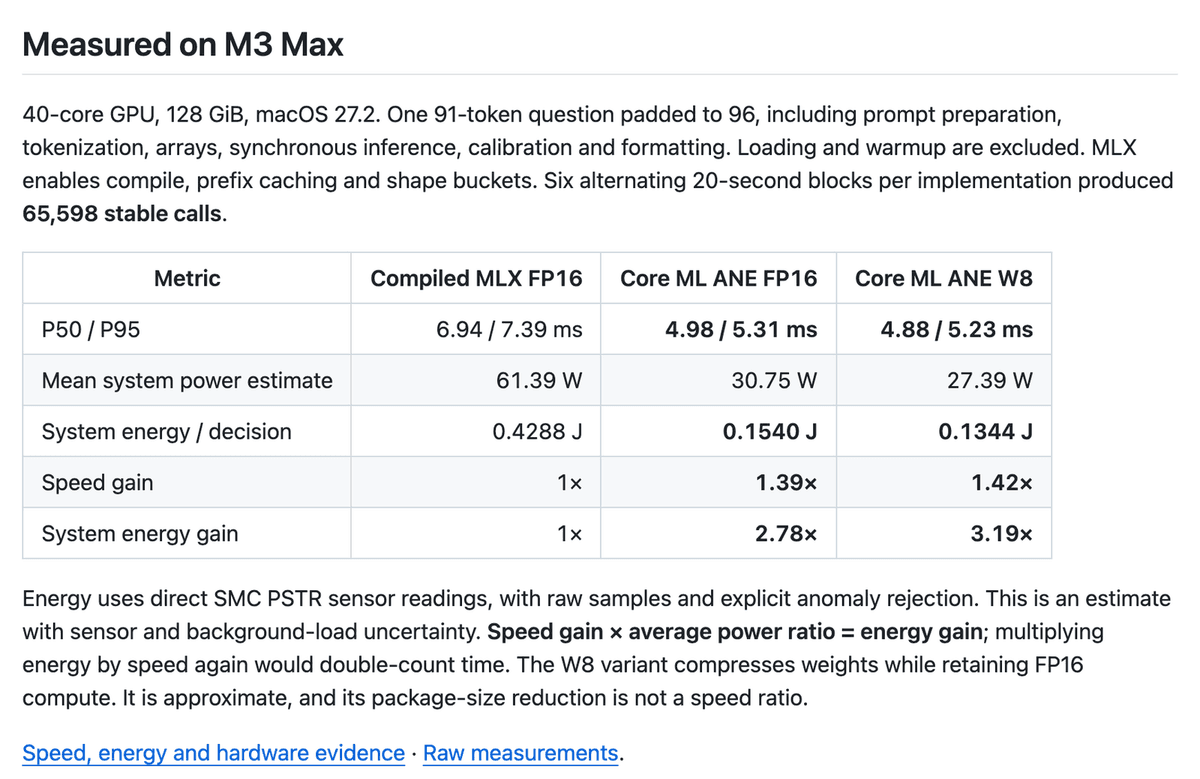
One short multilingual decision: 4.98 ms P50 / 5.31 ms P95 on M3 Max with ANE FP16.
Dieselbe Tabelle beziffert kompiliertes MLX FP16 mit 6.94 / 7.39 ms, und die Energie pro Entscheidung mit 0.1540 J für die ANE gegenüber 0.4288 J für MLX – eine Verbesserung um das 2.78-Fache über 65,598 stabile Aufrufe hinweg, wobei die Energie vom SMC-PSTR-Sensor gemessen und nicht modelliert wird. Zehntausend Entscheidungen auf der Neural Engine sind etwa 1.5 kJ, oder 0.43 Wh. Das ist eine Zahl, mit der sich budgetieren lässt, und sie ist der Grund, warum dieser Port existiert und nicht bloß ein weiterer Wrapper.
Lesen Sie die Testbedingungen, bevor Sie diese Zahl verplanen.
One 91-token question padded to 96, including prompt preparation, tokenization, arrays, synchronous inference, calibration and formatting.
Die Frage umfasst 91 Token; das Padding bringt den Tensor auf 96; und 96 ist das gesamte Budget. Das Gesamtlimit des ANE-Bundles liegt bei 96 Token, gezählt werden Frage, Optionen und jeglicher mitgeführter Zustand, und eine längere Anfrage löst einen Capacity-Fehler aus. Die Schlagzeile wird also mit vollständig ausgeschöpfter Box gemessen – die richtige Art, sie zu messen, und zugleich eine Warnung, dass später kein Spielraum mehr zu finden ist.
Was in der Box steckt, ist wichtiger als die Millisekunden, und das ist der Teil, den man prüfen sollte, bevor man irgendetwas portiert.
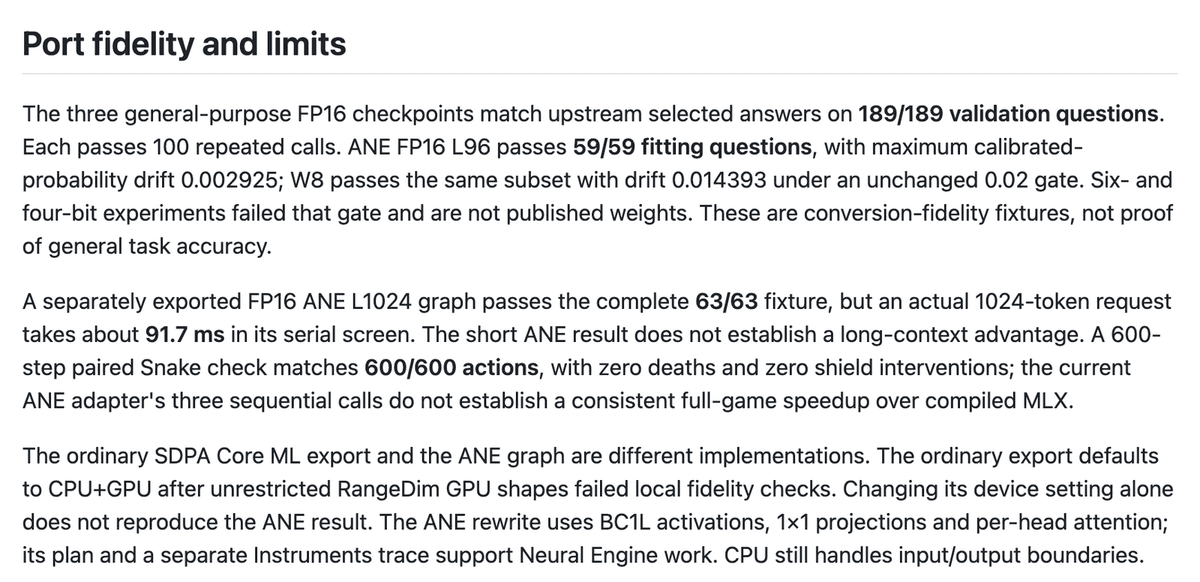
The three general-purpose FP16 checkpoints match upstream selected answers on 189/189 validation questions. Each passes 100 repeated calls.
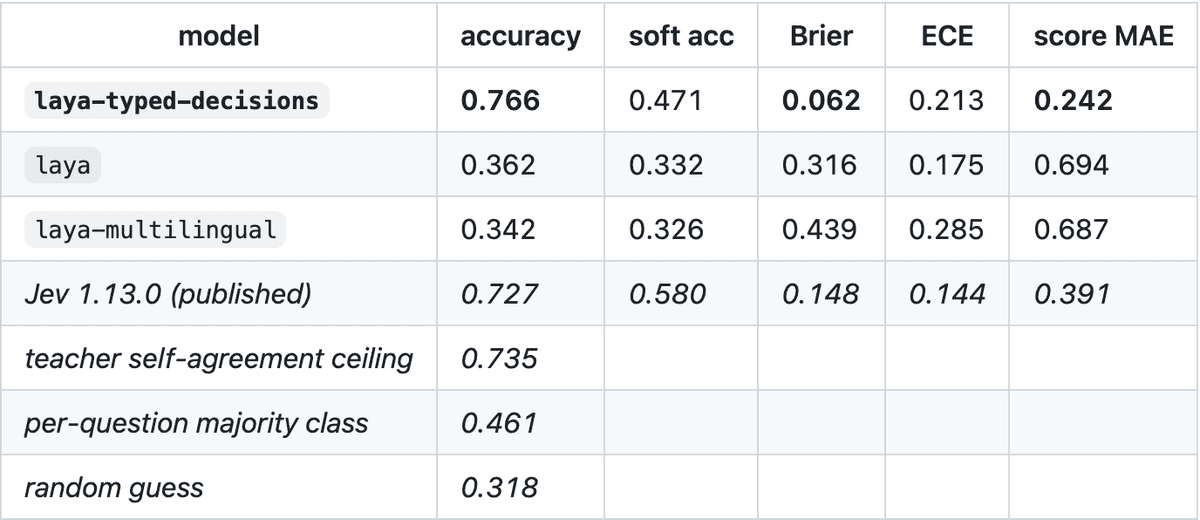
General-purpose ist das entscheidende Wort. Im Typed-Decisions-Benchmark von Upstream erreichen die General-Purpose-Checkpoints 0.362 und 0.342 – unterhalb der 0.461, die eine Mehrheitsklassen-Schätzung pro Frage erzielt; die 0.766, die Laya stark aussehen lässt, gehört zu einem aufgabenspezifischen Fine-Tune. Auf keiner der beiden Seiten ist eine Genauigkeitszahl für das Bundle dokumentiert, das die 4.98 ms erzeugt hat. Latenz wird pro Bundle gemessen; Genauigkeit pro Upstream-Checkpoint; niemand verbindet die beiden Spalten.
Die Schleife ist das, was billig sein muss
Acht Repositories tragen im Feed dieser Woche den Namen Laya, und die beiden mit angehängten Messungen sind Runtime-Ports desselben Autors: zuerst eine MLX-Runtime, dann dieser Core-ML-Port. Keiner der beiden fügt dem Modell eine Fähigkeit hinzu. Beide existieren, um eine Entscheidung billig genug zu machen, um in einer Schleife zu sitzen, die sie tausendfach ausführt – der End-to-End-Check des Ports selbst ist ein Snake-Spiel über 600 Schritte, Aktion für Aktion mit dem MLX-Build abgeglichen.
Das ist die Prämisse, auf der dieser Cluster handelt: dass ein Netzwerk-Roundtrip nicht in einen Frame passt. Es lohnt sich, das als Prämisse zu benennen, denn niemand hier hat ein Timing der gehosteten Alternative neben der eigenen veröffentlicht. Was laya-coreml tatsächlich veröffentlicht hat, ist die andere Hälfte des Budgets, die fast niemand misst.
A separately validated W8 palette variant reached 4.88 ms and 3.19× energy improvement.
Derselbe Absatz fügt hinzu, dass es sich um Ergebnisse zu einzelnen Fragen handelt und nicht um vollständige Snake-Frame-Zeiten, und dass die zehnfache Verbesserung, die man ursprünglich zu finden hoffte, nicht erreicht wurde. Zwei Entwickler, die denselben Schritt bei anderen Runtimes versucht haben, veröffentlichten anschließend Messungen auf einer völlig anderen Achse: nicht wie schnell das konvertierte Modell antwortet, sondern ob die Antwort und die daran hängende Konfidenz die Konvertierung überleben.
Paritäts-Fixtures beweisen, dass die Antwort sich nicht geändert hat – nicht, dass sie richtig war
Die Validierung des Ports ist gründlich und ungewöhnlich klar über ihren eigenen Geltungsbereich. Der ANE-FP16-Build besteht 59 von 59 Fitting-Fragen bei einer maximalen Drift kalibrierter Wahrscheinlichkeiten von 0.002925; W8 besteht dieselbe Teilmenge bei 0.014393, gegenüber einem unveränderten 0.02-Gate; die Sechs- und Vier-Bit-Experimente scheiterten an diesem Gate und wurden nie als Gewichte veröffentlicht. Und dann, im selben Absatz:
These are conversion-fidelity fixtures, not proof of general task accuracy.
Genau an dieser Unterscheidung setzen die Kritiker an. Auf Hugging Face berichtet der Autor eines quantisierten Web-Ports, was passiert, wenn man zur naheliegenden Kompression greift:
Ordinary dynamic INT8 destroys this model. onnxruntime.quantization.quantize_dynamic drops argmax agreement to 69% with a worst-case probability shift of 0.99.
— nvkudva, laya-web-q8 model card
Nur die MatMuls zu quantisieren ist katastrophal, während das alleinige Quantisieren der Embeddings überlebt – das deutet auf Aktivierungs-Ausreißer hin, nicht auf die Gewichtspräzision. Ein Entwickler, der an demselben Problem in einem Browser-Port arbeitete, brachte den Trade-off in einem Satz auf den Punkt:
The difference is the quantization scheme, not the checkpoint, and it is also where the twentyfold speed difference comes from.
— a-voronkov, laya-web-poc PR #16
Kalibrierung ist die zweite Lücke, und sie ist eher ein Sequencing-Problem als ein Quantisierungsfehler:
The shipped temperatures were fitted by the original author, not refitted after quantization.
— nvkudva, laya-web-q8 model card
Upstream stimmt in der Größenordnung zu, im eigenen README:
Refitting one temperature per (question type, option count) on held-out data moves mean ECE 0.466 -> 0.081 (laya) and 0.314 -> 0.106 (laya-multilingual).
Der Core-ML-Port hat bereits einen Fall erwischt, in dem das schiefgeht: eine ausgelieferte Temperatur von 0.1006 für den Bucket mit elf oder mehr Optionen, scharf genug, um einen Münzwurf als nahezu sicher auszuweisen, jetzt geclampt mit einer beim Laden benannten Warnung. Ein Fixture, das die Wahrscheinlichkeiten zweier Modelle vergleicht, kann einen Fehler nicht sehen, den beide erben.
Der dritte Einwand berührt die Hardware überhaupt nicht. Er trifft den Router, der auswählt, welchen Checkpoint die Hardware ausführt.
128/200 German utterances (64%) went to the English checkpoint.
Eine unentschiedene Sprachschätzung wird als Englisch behandelt, und die Übergabe von lang="de" stellt die volle Genauigkeit wieder her – das Modell ist also in Ordnung, das Routing nicht. Das ist ein Ausschlag von 20 Punkten bei kurzem lateinschriftlichem Text, entschieden von einer Heuristik, die volle Konfidenz meldet, während sie danebenliegt.
Was niemand vorgelegt hat, ist der Vergleich, den die meisten Leser wollen:
Accuracy and calibration claims for laya-mlx haven't been independently verified against a shared benchmark like JevBench; the published numbers cover latency, throughput, and memory only.
Man beachte, was dabei fehlt. Jede Messung oben ist lokal gegen lokal – Neural Engine gegen kompiliertes MLX auf demselben Laptop, eine Frage nach der anderen. Niemand hat einen gehosteten Roundtrip daneben gemessen veröffentlicht, sodass „schneller als die API“ immer noch die Prämisse ist, von der diese Projekte ausgehen, statt ein Ergebnis, das eines von ihnen berichtet.
Wie es in etwas Ausgeliefertes passt
Die 5-ms-Zahl gilt für kurze Entscheidungen mit fester Form und hört auf zu gelten, sobald man die Box verlässt:
A separately exported FP16 ANE L1024 graph passes the complete 63/63 fixture, but an actual 1024-token request takes about 91.7 ms in its serial screen.
Die achtzehnfache Latenz. Das Projekt zieht die Schlussfolgerung selbst:
The short ANE result does not establish a long-context advantage.
Die einsatzfähige Version ist also ein kleiner fester Prompt, eine kurze Optionsliste, explizite Sprachauswahl statt Auto-Routing, und Temperaturen, die man selbst auf eigenen gelabelten Daten nach der Konvertierung angepasst hat. Budgetieren Sie das Labeling. Das ist der eigentliche Integrationsaufwand, nicht der Export.
Die Form, die dem allen zugrunde liegt, ist ein Gate: Eine getypte Entscheidung ist ein Klassifikator, und ein Klassifikator verdient sich seinen Platz, indem er vor langsamerer Arbeit steht, sodass die meisten Eingaben nie den Modellaufruf, den Scrape oder die Person erreichen. Auf einem Laptop ist das Gate das Core-ML-Bundle, und die Ersparnis besteht darin, dass die teure Sache nie gefragt wird. In einer gehosteten Pipeline ist das Gate stattdessen der erste Schritt innerhalb des Laufs, und das ist eine Form, zu der Latenodes Zähler passt: Er zählt die CPU-Sekunden, die ein Lauf tatsächlich verbraucht – Laufzeit, nicht die Anzahl der Nodes oder API-Aufrufe – und es gibt keine Mindestgebühr pro Ausführung, sodass ein Lauf, der am Gate endet, für die verbrauchten Sekunden abgerechnet wird statt für eine ganze Ausführung. Der Schritt, der das Gating übernimmt, ist ein gewöhnlicher Node: eines der rund 335 Modelle im Katalog, oder ein JavaScript-Node, der jede beliebige NPM-Bibliothek installieren kann. Der kostenlose Tarif umfasst 10,000 CPU-Sekunden pro Monat und fünf aktive Workflows. Nichts davon führt das ANE-Bundle aus, das auf dem Laptop bleibt; was zwischen beiden wandert, ist die Form, nicht das Artefakt.
Wer diese Woche portieren sollte
Portieren Sie es, wenn Sie eine feste Entscheidung mit geringer Kardinalität in einer Schleife auf Apple Silicon haben, Ihr Prompt und Ihre Optionen in 96 Token passen, Sie die Sprache angeben können statt sie vom Router raten zu lassen, und Sie gelabelte Beispiele haben, um die Kalibrierung neu anzupassen. Prüfen Sie, welchen Upstream-Checkpoint Ihr Bundle trägt, bevor Sie irgendjemandem eine Genauigkeitszahl versprechen – der Port sagt ausdrücklich, dass er die General-Purpose-Familie konvertiert hat, und die General-Purpose-Familie ist nicht die Zeile, die den Lehrer schlägt. Für diese Leser sind die Geschwindigkeits- und Energiezahlen real und reproduzierbar, was mehr ist, als die meisten On-Device-Behauptungen leisten: 4.98 ms, 0.154 J, sensorgemessen, mit 65,598 Aufrufen dahinter.
Lassen Sie es sein, wenn Sie gehofft hatten, damit einen gehosteten Decision-Endpoint zu ersetzen und alles andere gleich zu lassen. Die veröffentlichte Arbeit stützt diesen Tausch nicht – es gibt keinen Vergleich mit einem gemeinsamen Benchmark, die ausgelieferten Wahrscheinlichkeiten sind fehlkalibriert, bis Sie sie korrigieren, und Auto-Routing kostet still 20 Punkte bei kurzem lateinschriftlichem, nicht-englischem Text. Es gibt außerdem eine Obergrenze dafür, wie viele Labels Sie verlangen können:
I've found they start to fail the more classifications you have, long before your typical ML classifier.
Wenn Sie das als Architektur bewerten und nicht als Paket, ist die ehrliche Lesart enger, als die Star-Zahlen nahelegen: Die Evidenz stützt, eine einzelne kleine, gut spezifizierte Entscheidung zu einem bekannten Preis pro Aufruf auf die Neural Engine zu legen, und sie stützt noch nicht, Ihr Urteilsvermögen dort abzulegen.
So war der Stand am 22. September 2026. Projekte entwickeln sich schnell – prüfen Sie die Quelle, bevor Sie sich darauf verlassen.
Häufige Fragen
- Ist laya-coreml eine offizielle Veröffentlichung von Apple oder Convai?
Nein. Das README beschreibt es als unabhängigen Port unter Apache-2.0 und stellt unmissverständlich klar, dass es keine offizielle Veröffentlichung von Convai Innovations oder Apple ist. Behandeln Sie die Gewichte und das Benchmark-Harness als Community-Arbeit mit einer NOTICE-Datei, nicht als Vendor-SDK mit Support-Kanal.
- Macht die W8-Variante das Modell spürbar schneller?
Kaum. Sie meldet 4.88 ms P50 gegenüber 4.98 ms bei FP16 – 1.42× gegenüber 1.39× im Vergleich zu kompiliertem MLX. Der Gewinn liegt bei der Leistungsaufnahme, 27.39 W gegenüber 30.75 W mittlerem Systemverbrauch, und bei der Paketgröße. Das README warnt, dass die Reduktion der Paketgröße kein Geschwindigkeitsverhältnis ist, weil W8 die Gewichte komprimiert, während die Berechnung bei FP16 bleibt.
- Läuft der Long-Context-Export ebenfalls auf der Neural Engine?
Nicht standardmäßig. Der gewöhnliche SDPA-Core-ML-Export und der ANE-Graph sind unterschiedliche Implementierungen, und der gewöhnliche greift standardmäßig auf CPU+GPU zurück, nachdem uneingeschränkte RangeDim-GPU-Shapes die projektinternen Fidelity-Checks nicht bestanden haben. Das Umstellen seiner Device-Einstellung reproduziert das ANE-Ergebnis nicht – der ANE-Pfad ist eine Neufassung mit BC1L-Aktivierungen, 1x1-Projektionen und Per-Head-Attention.
- Was brauche ich tatsächlich, um die Kalibrierung neu anzupassen?
Gelabelte Beispiele aus dem eigenen Traffic, gruppiert nach Fragetyp und Optionsanzahl, mit einer Temperatur, die pro Bucket nach der Konvertierung angepasst wird, nicht davor. Nichts im Port erledigt das für Sie. Zwei Dinge helfen dabei: Die ungeclampten Werte bleiben als agent.temperature_raw und agent.temperature_by_options_raw erreichbar, und eine RuntimeWarning beim Laden benennt jeden Bucket, den der Port clampen musste.
- Bedeutet 0.154 J, dass der Chip 0.154 Joule verbraucht?
Nein. Es handelt sich um eine Gesamtsystem-Schätzung aus direkten SMC-PSTR-Sensormessungen, die also alles einschließt, was der Laptop sonst noch getan hat, und das README weist auf Unsicherheiten durch Sensor und Hintergrundlast hin. Laden und Warmup sind aus der Pro-Entscheidung-Zahl ausgenommen, was relevant ist, wenn Ihr Prozess nur kurz läuft.
- Kann ich unter 8-Bit komprimieren, um auf ein kleineres Gerät zu passen?
Nicht mit veröffentlichten Gewichten. Die Sechs- und Vier-Bit-Experimente des Ports sind am 0.02-Drift-Gate für kalibrierte Wahrscheinlichkeiten gescheitert und wurden nie veröffentlicht; W8, mit einer Drift von 0.014393, ist die Untergrenze, die man bereit war auszuliefern. Beachten Sie, dass W8 die Gewichte komprimiert, während die Berechnung bei FP16 bleibt – das ist nicht dieselbe Operation wie die Quantisierung von Aktivierungen, woran die anderen Runtimes gescheitert sind.