
Nimble: Mit 2,676 Beispielen bis auf drei Punkte an Jev heran
Veröffentlicht am 22. September 2026
Ein Rezept, kein weiterer Endpunkt
Bespoke Labs veröffentlichte nimble am 18. September: ein LoRA-Adapter, der Qwen3.5-9B in ein typisiertes Entscheidungsmodell verwandelt — wähle einen dieser Kandidaten, wende diese Richtlinie an, bewerte dies anhand dieser Rubrik — und, nützlicher noch, die gesamte Pipeline, die ihn hervorgebracht hat. Kurationscode, Trainingskonfiguration, Evaluierungs-Harness, alles Apache 2.0. Der Adapter selbst ist etwa 165 MiB groß und braucht das 18-GB-Basismodell an seiner Seite.
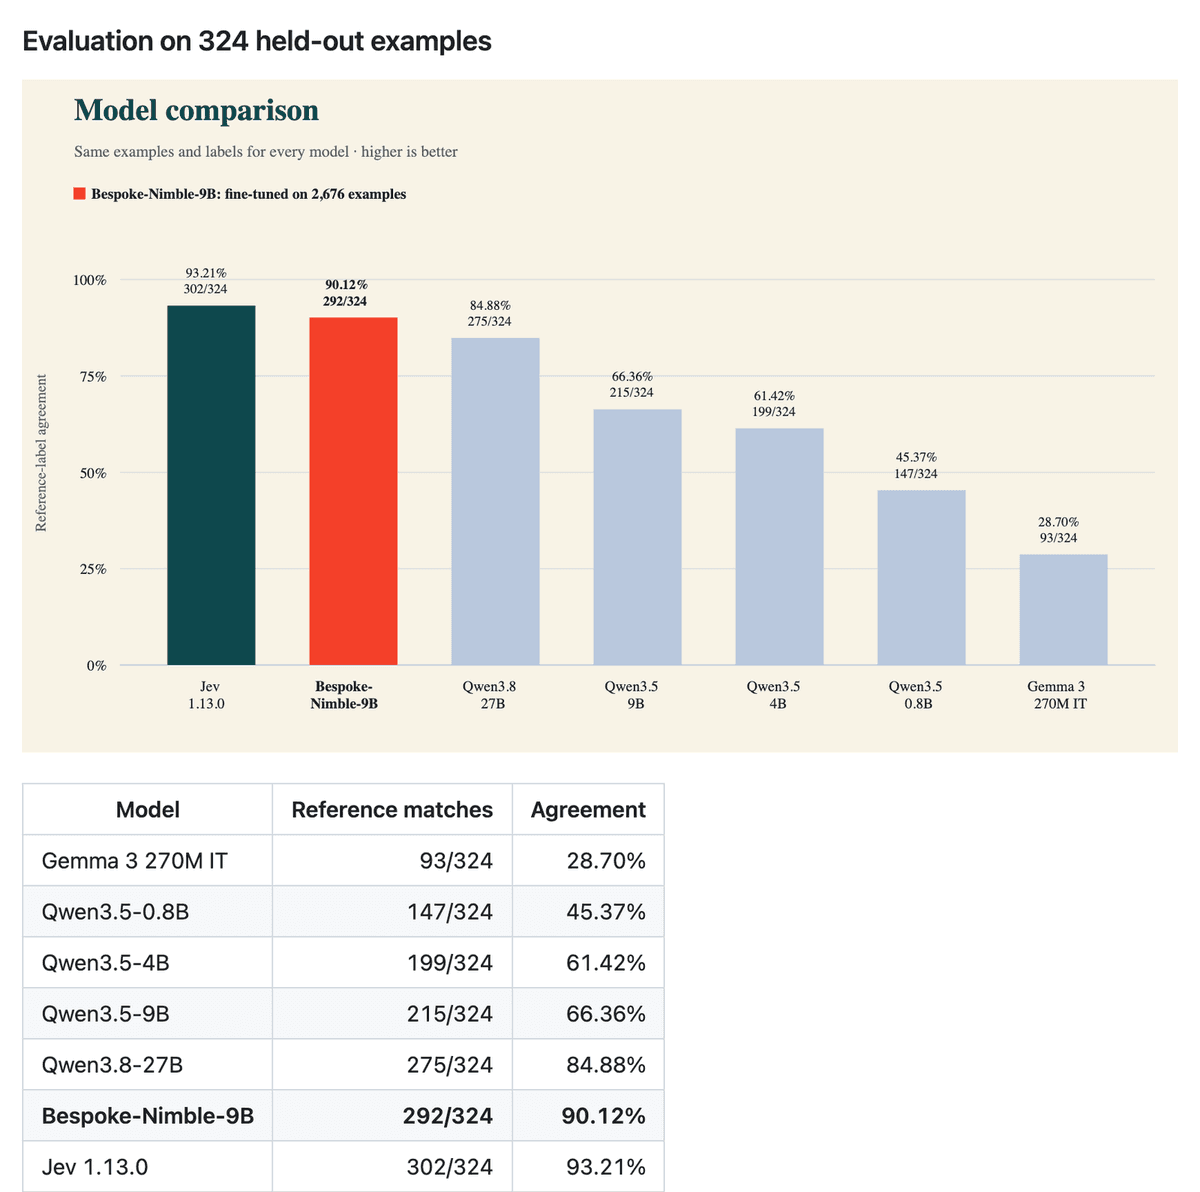
Was sich für die Lesenden dadurch ändert, ist die Rechnung zu einer Frage, über die bisher ohne Zahlen gestritten wurde: was es kostet, aufzuhören, das Entscheidungsmodell eines anderen anzurufen. Auf dem eingefrorenen Held-out-Set des Projekts mit 324 Beispielen stimmt das Fine-Tune in 90.12% der Fälle mit dem Referenzlabel überein. TypeSafes Jev 1.13.0 erreicht 93.21% auf denselben Beispielen. Das ungetunte Basismodell erreicht 66.36%. Das LoRA schließt damit den größten Teil einer Lücke von 26.85 Punkten und lässt drei Punkte liegen.
Note that we did not distill from Jev.
Dieser Satz leistet echte Arbeit. Er bedeutet, dass das Rezept ein Rezept ist und keine Kopie, und er bedeutet, dass die drei Punkte die Kosten dafür sind, die Trainingsdaten selbst zu bauen — nicht die Kosten einer verlustbehafteten Nachahmung.
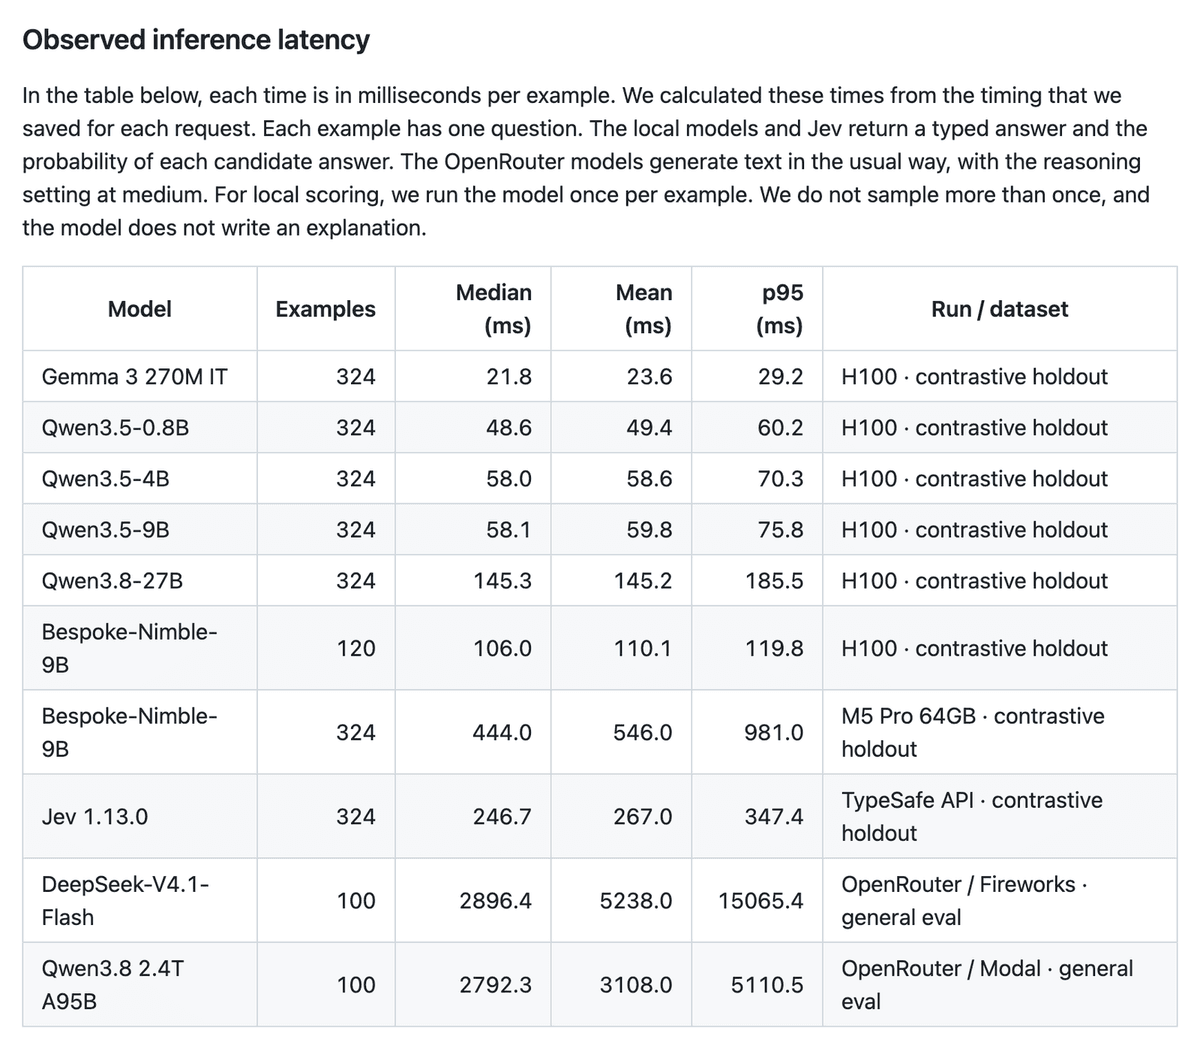
Lokal ist es außerdem schneller als der Aufruf, den es ersetzt — mit dem Vorbehalt, der in derselben Tabelle steht. Median 106.0 ms pro Beispiel auf einem H100 gegen 246.7 ms über die TypeSafe-API. Auf einem M5 Pro 64GB braucht derselbe Adapter 444.0 ms Median, 546.0 Mittelwert, 981.0 bei p95 — damit endet die Laptop-Version des Pitches. Weiter oben in derselben Tabelle läuft das ungetunte Qwen3.5-9B-Basismodell mit 58.1 ms über alle 324 Beispiele, und das Repository erklärt nicht, was der Adapter dazu beiträgt. Auch die schnelle Zahl beruht nicht auf derselben Stichprobe wie alles, womit sie verglichen wird.
Their recorded times are also not from a controlled serving test.
Der Teil der Welle, der seine Arbeit offenlegte
Jev erschien closed, und der September füllte sich mit Nachahmern — ein AINews-Rückblick dieser Woche katalogisierte sechs davon und riet bei den Architekturen, weil Raten alles war, was jemand tun konnte. Fast alle veröffentlichten eine Geschwindigkeitszahl und einen Endpunkt.
a lot of demos emphasized speed more than quality, and there is still no standard benchmark for this category.
Nimble ist der Eintrag, der stattdessen den teuren Schritt offenlegte: wie die Trainingsdaten entstanden sind. Bespoke nennt die Methode contrastive data curation. Man schreibt zwei Beispiele, die sich fast gleichen.
They differ in one relevant fact, and this difference changes the correct answer.
Das dokumentierte Beispiel ist eine Rückerstattungsrichtlinie, bei der nur Mira Rückerstattungen auf einem Konto autorisieren darf; die gepaarte Version tauscht den Namen auf der unterschriebenen Autorisierung gegen Noah, und die korrekte Antwort kippt von wahr zu falsch. Alles andere — die Frage, die Richtlinie, die Formulierung — bleibt unverändert. Die Pipeline erzwingt das mit einer mechanischen Lokalitätsprüfung: Jedes vorgeschlagene Paar darf einen Satz und höchstens acht durch Leerzeichen getrennte Wörter ändern, gemessen per Token-Diff. Separate Modellaufrufe verifizieren anschließend die Fakten in jedem Beispiel, und ein Löschtest bestätigt, dass das Entfernen eines der beiden Belegsätze die Kernaussage tatsächlich unbestimmbar macht.
Daraus entstanden 2,676 Beispiele über zehn Themenkategorien, generiert mit GPT-5.6 Terra und geprüft mit GPT-5.6 Sol, danach eine einzige Trainingsepoche mit LoRA — 335 Optimizer-Updates bei effektiver Batch-Größe 8. Das Tuning lief auf L40S; der finale Fit lief auf einem H100. Das Ganze entstand im Tempo, in dem sich die Woche bewegte.
We built Nimble in one day, so expect some rough edges.
Wo es verliert, ist nützlicher als um wie viel
Die README verweist auf einen externen Vergleich: dreizehn öffentliche, von Menschen gelabelte Subsets außerhalb der Trainingskategorien, beide Modelle bewertet auf denselben Datensätzen.
That is a gap of 1.2 macro points in Jev's favour across tasks that are all outside Nimble's training categories.
— Nimble public benchmarks guide
74.8% Makro gegen 76.0%. Diese Lücke ist die Zahl, die zitiert werden wird, und sie ist die am wenigsten aussagekräftige Zeile auf der Seite.
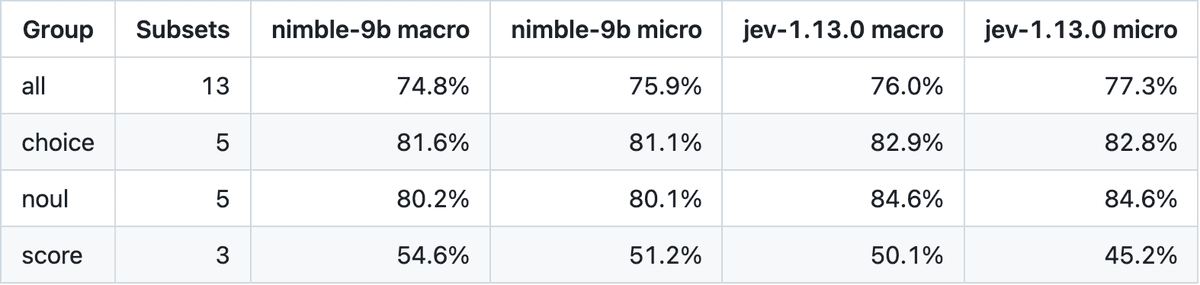
Nach Gruppen aufgeschlüsselt verliert das Fine-Tune choice mit 81.6 zu 82.9 und verliert noul mit 80.2 zu 84.6, gewinnt aber score mit 54.6 zu 50.1, wobei die Mikro-Werte mit 51.2 gegen 45.2 noch weiter auseinanderliegen. Als drei Einzelergebnisse gelesen heißt das: Ein Modell, das auf 2,676 selbst erstellten Beispielen trainiert wurde, schlägt den Anbieter bei der Rubrik-Bewertung und liegt bei der Klassifikation zurück. Die Pro-Subset-Genauigkeitstabelle über diesen Durchschnittswerten sagt etwas Engeres und Nützlicheres, weil sie in jeder Zeile einen McNemar-p-Wert führt. Der Score-Sieg reicht nur einen Datensatz tief: summeval-relevance mit 49.2 gegen 35.0, p=0.0004, während helpsteer2 mit 4.9 Punkten Abstand bei p=0.3232 liegt, was nicht signifikant ist, und das Fine-Tune den dritten Score-Subset, summeval-consistency, mit 75.7 zu 81.2 verliert. Das Defizit von 1.3 Punkten bei der Gruppe choice wiederum mittelt zwei signifikante Niederlagen — massive-de-DE bei p=0.0169, vitaminc-dev bei p=0.0125 — gegen einen Sieg, der nicht signifikant ist. Die ehrliche Version der Aufschlüsselung lautet also nicht „gewinnt bei der Rubrik-Bewertung“: Ein einziger Summarisierungs-Datensatz trägt den einzigen eindeutigen Sieg, und die Niederlagen, die einen Signifikanztest überstehen, verteilen sich über die Klassifikationssubsets.
Die Aufschlüsselung desselben Trainingssets nach Aufgabentyp in der README legt eher eine Ursache als einen Zufall nahe. Score ist mit 932 Beispielen der größte Block, gegenüber 888 bei Noul und 856 bei Choice. Das Modell ist im Vergleich zum Anbieter dort am stärksten, wo es am meisten von diesem Aufgabentyp gesehen hat.
Eine Zeile verdient es, ganz aus den Durchschnittswerten herausgehoben zu werden. paws ist das achte der dreizehn Subsets: adversariales Wort-Scrambling, bei dem zwei Sätze die meisten Wörter teilen, aber Verschiedenes bedeuten. Typ noul, 250 Datensätze. Das Fine-Tune erreicht 82.8%, Jev 89.2%, und die Seite markiert den Unterschied als signifikant bei p=0.0025. Diese Lücke von 6.4 Punkten ist größer als jeder der Gruppendurchschnitte, und sie liegt bei einer Aufgabe, die genau so gebaut ist wie die Trainingsdaten: minimal unterschiedliche Satzpaare, die Verschiedenes bedeuten. PAWS ist die eigene Idee der contrastive curation, geschrieben als adversarialer Test von anderen Leuten. Die charakteristischste Behauptung der Methode ist ausgerechnet bei der Aufgabe am schwächsten, für die die Methode existiert.
Die Autoren sind unverblümt, wo die Grenzen davon liegen.
We trained Bespoke-Nimble-9B on 2,676 examples that we curated. So it's performance will depend on this data and the domains it comes from.
(Die Tippfehler stammen von ihnen — das englische „it's“ statt „its“ ist der Ein-Tage-Build, der durchscheint.) Die Domänen-Reichweite ist noch enger, als dieser Satz nahelegt, und die README druckt den Grund als Tabelle: eine Trainingsanzahl und eine Held-out-Anzahl für jede der zehn Kategorien.
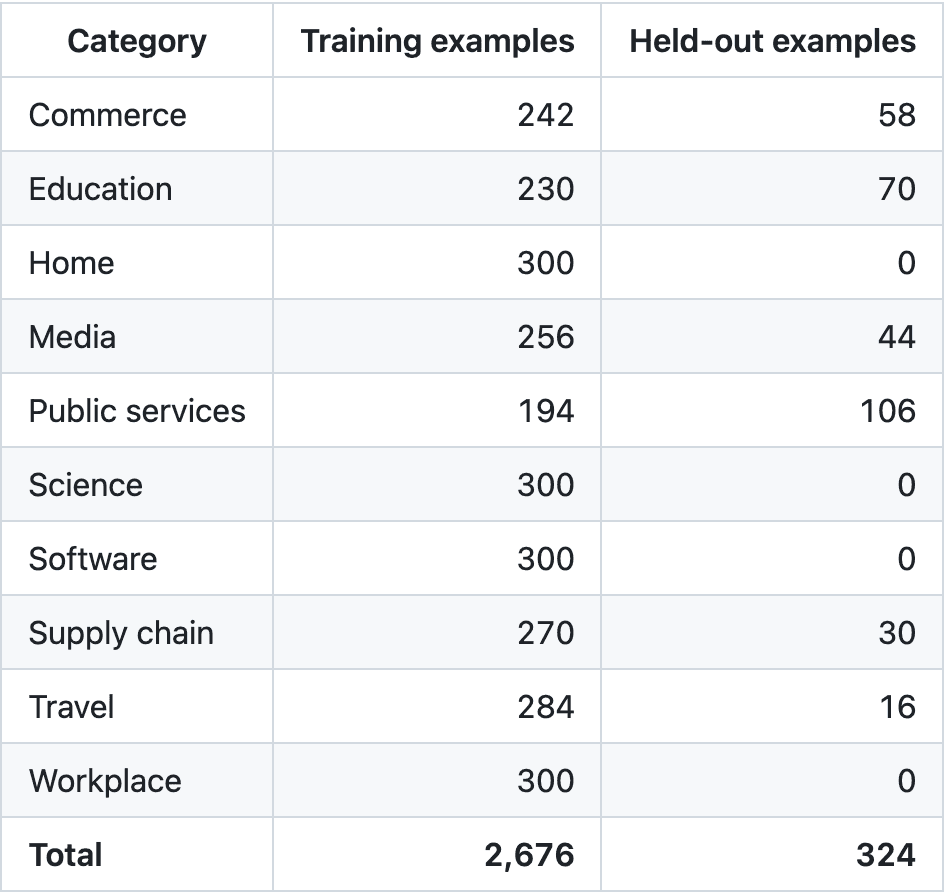
Vier der zehn Held-out-Werte sind null: Home, Science, Software und Workplace, mit je 300 Trainingsbeispielen. Die gesamte Auswertung mit 324 Beispielen stammt aus den anderen sechs — Public services 106, Education 70, Commerce 58, Media 44, Supply chain 30, Travel 16. Die 90.12% sind also über sechs Zehntel der Fläche gemessen, für die das Modell trainiert wurde, und die vier ungemessenen Zehntel sind die vier größten Trainingsblöcke im Set. Nicht schwach: nicht ausgewiesen.
Außerhalb des Projekts richtet sich die Kritik grundsätzlich dagegen, woher die Labels überhaupt kamen.
Of course, not enough people are talking about the data side, which is acknowledged to be 100% synthetic.
„Acknowledged“ ist das richtige Wort, und das Eingeständnis ist ungewöhnlich klarsichtig:
All of the labels are synthetic: a model checked them, and no person has reviewed them.
Die README ergänzt, warum das schmerzhaft ist: Separate Aufrufe desselben Modells können denselben Fehler machen, sodass die Prüfung übersehen kann, was der Generator falsch gemacht hat. Trainings- und Auswertungsdaten wurden von derselben Generator-Familie erzeugt, was bedeutet, dass ein geteilter blinder Fleck den Score gleichzeitig anheben und die Genauigkeit senken würde — und nichts im Repository würde das zeigen.
Das Held-out-Set ist auf eine zweite Art klein, die nichts mit Kategorien zu tun hat. Seine 324 Beispiele sind 162 eng verwandte Paare, und die README zählt, woher sie stammen:
All of them come from only six source families, so this is a narrow test.
Ob diese sechs Familien dieselben sechs Kategorien sind, die das Held-out-Set abdeckt, sagt die README nicht, und der Benchmarks-Guide verwendet „Familien“ an anderer Stelle in einem anderen Sinn — als Anzahl der Quelldokumente hinter einem Subset, etwa 31 hinter den 299 Datensätzen von squad2. So oder so ist das Wort der Autoren dafür das richtige: eng.
Zwei unabhängige Kritikpunkte schärfen das zu etwas, das sich konkret prüfen lässt. Ein Engineer, der Jev in einem Agent-Harness benchmarkte, fand den Fehlermodus, den eine Schema-Garantie nicht abfangen kann:
High confidence means the model is sure it applied your definition — including your mistakes
— Benchmarking Jev in an agent harness, DEV Community
Sie berichten von falschen Routings, die mit Confidence 1.0 ankommen. Treue zu Ihrem Schema ist nicht dasselbe wie Korrektheit, und ein Fine-Tune übernimmt Ihre Definitionen wörtlicher, als ein Anbietermodell das täte. Unabhängig davon maß eine Gruppe der Johns Hopkins University, was ein reiner Label-Vergleich verdeckt: Über 588 Ergebnisse hinweg war jedes finale Label korrekt, während 581 nachgelagerte Ausgaben exakt waren.
the workflow can return the expected verdict while passing an incorrect quantity to subsequent analysis.
Übereinstimmung mit einem Referenzlabel ist genau das: ein reiner Label-Score. Beide Kennzahlen, mit denen Nimble wirbt, sind von dieser Art.
Der letzte Einwand kommt zurück zu paws, und zwar von jemandem, der selbst im Rennen ist. Im Issue-Tracker des Projekts stellt ein Kommentator unter dem Namen m0at eigene zero-weight edge discriminators gegen Nimble-9B und Jev, auf einer selbst rekonstruierten 324-Beispiele-Suite aus BoolQ, MultiNLI und PAWS, und berichtet, dass die eigene Implementierung 100% bei Sub-Millisekunden-Latenz erreicht. Einen selbst durchgeführten Vergleich auf einer selbst nachgebauten Suite sollte man mit der Skepsis behandeln, die er verdient. Der mechanische Teil des Arguments hält stand, egal wer ihn vorbringt:
Base small models struggle significantly on PAWS (Gemma 3 at 41.2%, Qwen 3.5 at 45.4%)
— m0at, bespokelabsai/nimble issue #3
Als Grund wird genannt, dass die Unigram-Überlappung zwischen den beiden Sätzen über 85% liegt, sodass ein Modell, das Wörter statt ihrer Reihenfolge gewichtet, kaum etwas zum Ansetzen hat. Das ist eine Aussage über die Form der Aufgabe, nicht über irgendjemandes Produkt, und sie zeigt auf genau das Subset, bei dem Bespokes eigene Suite die signifikante Niederlage des Fine-Tunes verzeichnet.
Using n-gram order sensitivity (specifically trigram Jaccard divergence) reliably discriminates semantic flips without requiring generative rollouts.
— m0at, bespokelabsai/nimble issue #3
Wenn eine gewichtslose Trigram-Statistik die Fälle trennen kann, bei denen ein feingetuntes 9B-Modell falschliegt, dann ist die interessante Frage nicht, ob man das Modell selbst besitzen sollte. Sie lautet, welche Ihrer Entscheidungen überhaupt ein Modell gebraucht hätten.
Wo ein Modell wie dieses seinen Platz verdient
Ein typisiertes Entscheidungsmodell ist ein Klassifikator, und Klassifikatoren sind am nützlichsten als Routing-Schritt vor langsamerer Arbeit: erst entscheiden, dann ausgeben. Die Rückerstattungsfrage von oben ist das Musterbeispiel — klären Sie „ist das autorisiert“ in einem einzigen typisierten Aufruf, und lassen Sie den Zweig, der Dokumente liest, in ein Ledger schreibt oder einen Menschen alarmiert, nur dann laufen, wenn die Antwort das verlangt.
Nimbles Zahlen verändern die Form der Build-or-buy-Entscheidung, statt sie zu klären. Wenn Ihr Traffic einer der sechs Kategorien ähnelt, die das Held-out-Set abdeckt, haben Sie eine veröffentlichte Zahl, auf die Sie sich stützen können. Wenn er eher wie Home, Science, Software oder Workplace aussieht, hat niemand eine Zahl veröffentlicht — nicht einmal die, die auf genau diesen Kategorien trainiert haben —, und Ihre erste Aufgabe ist ein eigenes Held-out-Set, gelabelt von jemandem, der dafür geradestehen muss, wenn es falsch ist. Die Kurationsmethode überträgt sich sauber. Die Labels übertragen sich überhaupt nicht.
Welches Modell am Ende die Entscheidung trifft, der Workflow drumherum bleibt derselbe, und es lohnt sich, ihn so zu bauen, dass der günstige Pfad günstig bleibt. Auf Latenode lässt sich das unkompliziert kalkulieren, weil der Meter die CPU-Sekunden zählt, die ein Lauf tatsächlich verbraucht, statt Nodes oder API-Aufrufe, und es kein Minimum pro Ausführung gibt — ein Lauf, der klassifiziert, den kurzen Zweig nimmt und beendet wird, kostet also proportional weniger als einer, der den langen Weg geht. Ein JavaScript-Node kann jede beliebige NPM-Bibliothek installieren, was die Arbeit rund um eine Entscheidung — Parsing, Validierung, den Zweig selbst — gewöhnlichen Code bleiben lässt statt Konfiguration. Die kostenlose Stufe umfasst 10,000 CPU-Sekunden pro Monat über 5 aktive Workflows. Wie weit das reicht, ist eine Frage Ihres Traffics, nicht des Meters.
Wer das klonen sollte, und wer nicht
Klonen Sie es, wenn Sie eine enge, stabile Entscheidungsfläche haben und den Mut, Daten zu labeln: Das übertragbare Gut hier ist die Kurationspipeline, nicht die Gewichte, und die Größenordnung, in der sie funktionierte, waren 2,676 Beispiele über zehn Kategorien und eine einzige Epoche mit 335 Optimizer-Updates. Was das an Stunden gekostet hat, sagt das Repository nicht. Klonen Sie es, wenn Ihre Aufgabe konkret der Bewertung von Summary-Relevanz gleicht, denn dort liegt der eine eindeutige Sieg — summeval-relevance, 49.2 gegen 35.0 bei p=0.0004 — und das ist ein einzelner Datensatz, keine Kategorie: Die anderen beiden Score-Subsets sind ein statistisches Unentschieden und eine Niederlage. Klonen Sie es, wenn Sie sehen wollen, wie ein Entscheidungsmodell mit sichtbarem Datenschritt aussieht, denn fast nichts sonst in dieser Welle zeigt das.
Lassen Sie es sein, wenn Sie nach einem Drop-in-Ersatz für Jev suchen. Es liegt drei Punkte zurück in den Domänen, für die es gebaut wurde, 6.4 Punkte zurück bei p=0.0025 auf paws, dem Adversarial-Paraphrase-Subset, das genauso gebaut ist wie die eigenen Trainingsdaten, und die Autoren sagen Ihnen unverblümt, dass Sie keine Generalisierung erwarten sollten. Lassen Sie es sein, wenn das Zielgerät ein Laptop ist: 444 ms Median und 981 ms bei p95 sind ein anderes Produkt als 106 ms auf einem H100, und die H100-Zahl wurde an 120 Beispielen gemessen, während alles, womit sie verglichen wird, an 324 gemessen wurde. Und lassen Sie es sein, wenn Sie keine eigenen gelabelten Daten haben, denn was die 90.12% erzeugt hat, waren 2,676 kuratierte Beispiele, kein LoRA-Rang.
Die Zahl, die man im Auge behalten sollte, ist nicht die Drei-Punkte-Lücke. Es ist, ob jemand dieses Rezept auf Daten anwendet, die tatsächlich ein Mensch gelesen hat, und berichtet, was sich dadurch ändert.
So war der Stand am 22. September 2026. Projekte entwickeln sich schnell – prüfen Sie die Quelle, bevor Sie sich darauf verlassen.
Häufige Fragen
- Unter welcher Lizenz steht Nimble, und was lade ich eigentlich herunter?
Apache 2.0. Die Veröffentlichung ist ein LoRA-Adapter von rund 165 MiB, dazu der Tokenizer, der Prompt-Builder und Referenz-Inferenzcode. Es ist kein eigenständiges Modell: Sie stellen Qwen3.5-9B selbst bereit, was weitere 18 GB oder mehr sind, und mergen den Adapter entweder oder laden ihn neben dem Basismodell.
- Welche Hardware und Einstellungen verwendet der veröffentlichte Lauf?
Eine NVIDIA-GPU mit BF16-Unterstützung; das Repository berichtet von Tests mit PyTorch 2.8.0 und CUDA 12.8. Bespoke tunte auf L40S und führte den finalen Fit sowie die Auswertung auf einem H100 durch. Die veröffentlichte Konfiguration ist LoRA mit Rang 16, Lernrate 5e-5, Batch-Größe 2 mit Gradientenakkumulation 4, einem Prompt-Limit von 2,048 Token und Zufalls-Seed 17; der Trainingsguide setzt die maximale Schrittzahl auf 1,005 bei 101 Warmup-Schritten.
- Kann ich Inferenz auf Apple Silicon ausführen?
Ja. Das Repository führt Apple Silicon über MLX neben dem CUDA-Pfad auf, und die veröffentlichte Auswertung umfasst einen vollständigen Lauf über 324 Beispiele auf einem M5 Pro 64GB. Die praktische Einschränkung ist der Speicher für das Basismodell, nicht der Adapter, der klein genug ist, um kaum ins Gewicht zu fallen.
- Kann ich die Kurationspipeline auf ein anderes Generator-Modell umstellen?
Ja. Die Standardwerte liegen im Modul für Kurationsprofile und werden pro Phase festgelegt, nicht global: Trainingskontraste und die Generierung der Auswertung verwenden standardmäßig unterschiedliche Modelle, mit niedrigem beziehungsweise mittlerem Reasoning. Um eines der beiden zu ändern, müssen Sie dieses Modul bearbeiten, und nichts im Repository beschreibt, was dann mit den veröffentlichten Zahlen passiert — ein Wechsel macht die Ergebnisse zu Ihrer eigenen Messaufgabe.
- Würde ein größeres, ungetuntes Modell denselben Job erledigen?
Bei diesem Test nicht. Auf denselben 324 Beispielen erreicht das ungetunte Qwen3.8-27B — dreimal so viele Parameter — 84.88%, das sind 5.25 Punkte weniger als das 9B-Fine-Tune, und darunter fällt die Leiter schnell ab: Qwen3.5-4B bei 61.42%, Qwen3.5-0.8B bei 45.37%, Gemma 3 270M IT bei 28.70%. In den Domänen, für die es trainiert wurde, bringen 2,676 kuratierte Beispiele mehr als das Dreifache der Gewichte — das ist das Argument für das Rezept, und es ist nur ein Argument für diese Domänen.
- Erklärt das Modell seine Antworten?
Nein, und das ist Absicht. Beim lokalen Scoring läuft das Modell einmal pro Beispiel, ohne wiederholtes Sampling und ohne geschriebene Begründung. Zurück kommt eine typisierte Antwort plus eine Wahrscheinlichkeit für jeden Kandidaten — das macht es günstig genug für einen Hot Path, und es bedeutet auch, dass Ihnen nichts zum Nachlesen bleibt, wenn es falsch liegt.