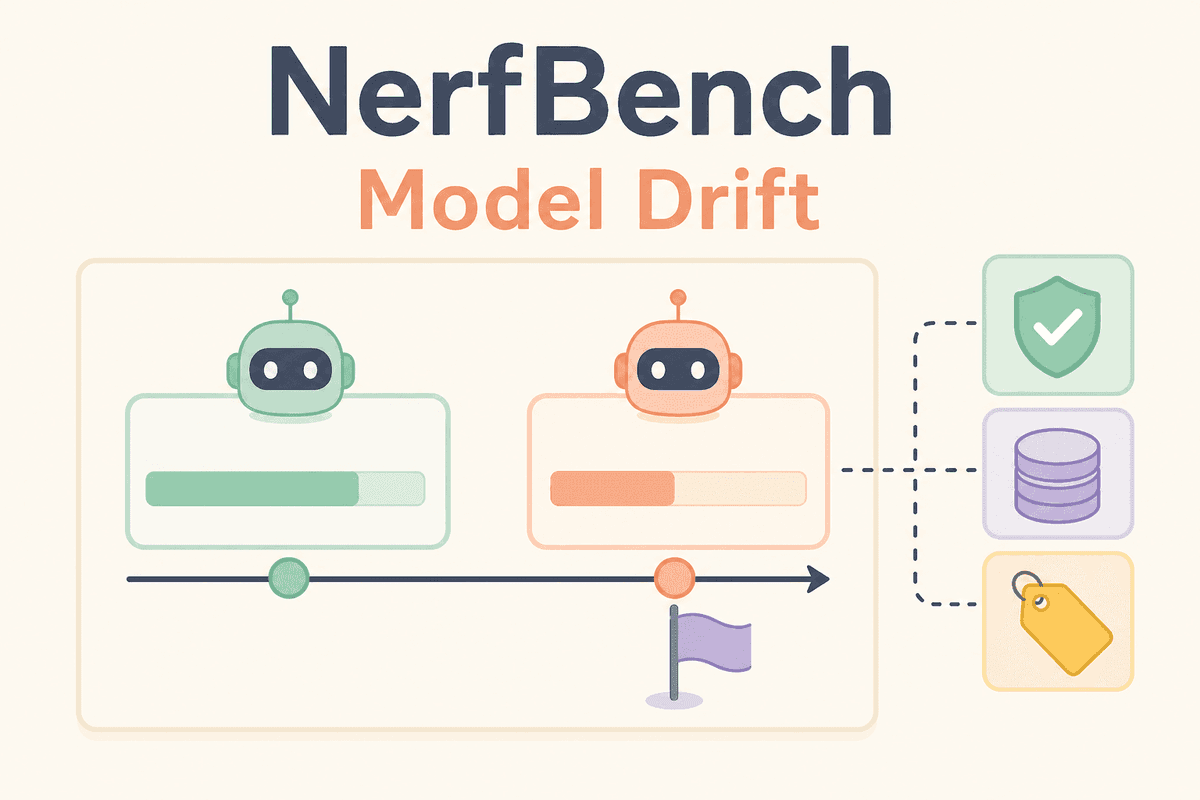
Am 2026-09-27 kündigte Bridgebench NerfBench an, ein Benchmarking-Projekt zur Prüfung, ob sich Modelle nach ihrer Veröffentlichung so verändern, dass Qualität oder Kosten betroffen sind. Laut Bridgebench erhält jedes Modell am Launch-Tag einen Benchmark, der als 100%-Referenzwert dient. Spätere Tests messen die Leistung zusammen mit dem Tokenverbrauch und den Kosten pro Aufgabe.
Bridgebench zufolge gelten Werte zwischen 90% und 110% als normale Schwankung, während Ergebnisse unter 90% als mögliche Verschlechterung markiert werden. Das Projekt erklärte außerdem, $10,000 zugesagt zu haben, um zu verfolgen, ob KI-Labore Modelle nach dem Launch „nerfen“.
Der Aufbau zeigt für sich genommen keine Absicht, bietet Teams jedoch eine wiederholbare Methode, anekdotische Beschwerden von gemessenen Regressionstests für Qualität, Tokenverbrauch und Stückkosten zu trennen.