
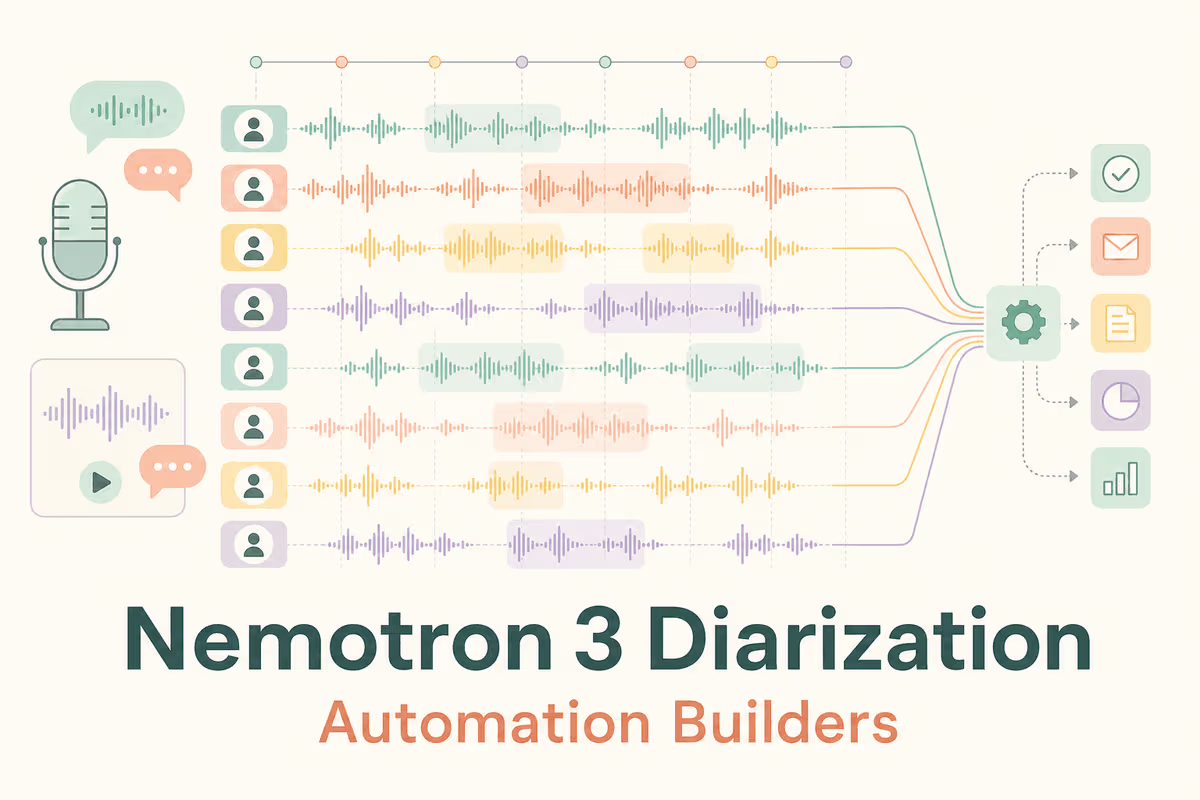
NVIDIA hat Nemotron 3 Diarization veröffentlicht, ein Audiomodell mit offenen Gewichten zur Verfolgung von Sprechern in Live- und aufgezeichneten Gesprächen. Der Checkpoint mit rund 100 Millionen Parametern kennzeichnet laut dem Veröffentlichungsbeitrag bis zu acht Sprecher, einschließlich überlappender Sprache.
Das Modell gibt Zeitstempel und anonyme Sprecherlabels statt Identitäten oder eigenständiger Transkripte zurück. Ein Checkpoint unterstützt sowohl Streaming als auch die Offline-Verarbeitung, während die Gewichte unter OpenMDW 1.1 auf Hugging Face verfügbar sind.
Teams können die Sprecherkanäle mit automatischer Spracherkennung für Besprechungsnotizen, Anrufanalysen und die Podcast-Verarbeitung kombinieren. Sie müssen Labels weiterhin bekannten Teilnehmenden zuordnen und die Genauigkeit mit verrauschten, domänenspezifischen Audiodaten testen.
Die frühere Nemotron-3-Veröffentlichung von NVIDIA behandelt die Sprachmodellfamilie; der Diarisierungsstart betrifft ein separates Audiomodell.