
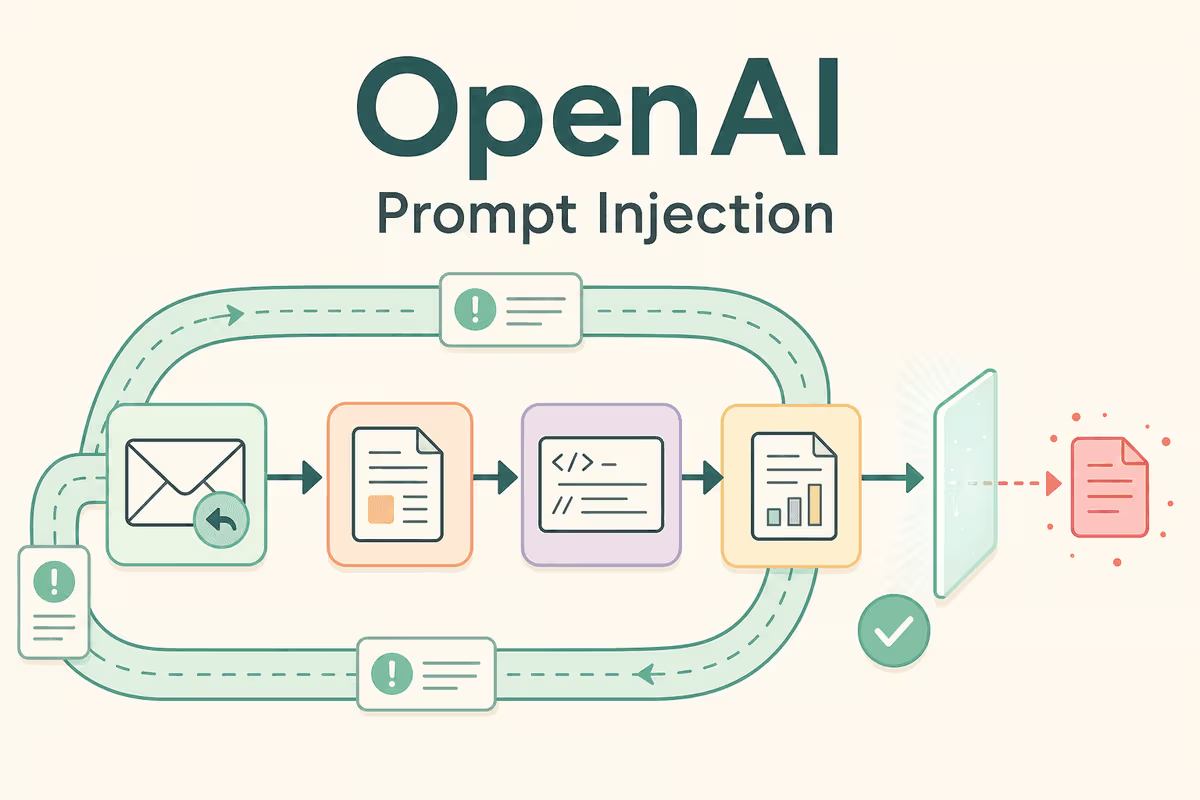
OpenAI hat eine selbstreplizierende Prompt-Injection offengelegt, die sich in simulierten Agenten-Workflows ausbreitete und sich über Ausgaben ähnlich wie ein Computerwurm kopierte.
Der OpenAI-Alignment-Bericht zeigt, wie sich eingeschleuste Anweisungen über E-Mail-Antworten, Dateisystemartefakte, Code-Kommentare und einen mehrstufigen Slack-Test verbreiteten. OpenAI erklärte, außerhalb simulierter Tool-Aufrufe in Training und Evaluierung keine Auswirkungen beobachtet zu haben. Es handelt sich daher nicht um einen gemeldeten realen Vorfall.
Das Unternehmen nimmt Selbstreproduktion nun in die Angreiferziele auf, wenn künftige Modelle gegen Prompt-Injection trainiert werden. Für Builder, die KI-Agenten einsetzen, liegt das praktische Risiko in der Persistenz: Eine in einem Schritt akzeptierte Anweisung kann in einer Datei, Nachricht oder Tool-Ausgabe bestehen bleiben und später im Workflow erneut auftauchen.