
DFlash 2: um drafter de 3.43× que cai a 1.45× sob carga
Publicado em 22 de setembro de 2026
Um drafter que adivinha o bloco inteiro de uma vez
A decodificação especulativa tem sempre a mesma forma: um modelo pequeno propõe tokens, o modelo grande os verifica numa única passada, e você fica com o que sobreviveu. A etapa de proposta permaneceu autorregressiva — um token, depois o próximo. O DFlash 2 transforma isso numa única passada:
the entire block, every position, predicted in parallel.
— Inco AI
Um seletor leve então traça um caminho coerente entre os candidatos mantidos em cada posição, e convoluções dinâmicas two-tap evitam que o rascunho se degrade perto do fim do bloco. O fornecedor precifica o arranjo inteiro em mais de 20% de saída extra por passada de verificação, por cerca de 1% de latência de ciclo adicional. As convoluções são a parte barata disso: elas acrescentam 0.7% ao ciclo de rascunho-verificação, enquanto as dez camadas extras de Transformer que comprariam precisão comparável acrescentam 15.2%.
Nada disso deveria mudar o que o modelo diz:
Decoding is lossless: greedy output matches the target model exactly, and sampling preserves its distribution.
Então o discurso é limpo. Mesmo texto, menos segundos. A questão é quantos segundos a menos, e sob qual carga.
Cinco semanas depois, e só agora vale a pena discutir
Nada aqui foi lançado nesta semana. A Inco AI lançou dois drafters DFlash 2 em 18 de agosto, um para o Qwen3.8-27B e um para o Muse Glimmer, e o número com que abriu foi um número de requisição única:
SGLang serves at 2.7–3.4× the throughput of autoregressive decoding at batch size 1
— Inco AI
O drafter entrou no nosso feed em 17 de setembro, o que é um fato sobre o feed, não sobre o projeto. O que mudou foi o intervalo. A implementação do método no vLLM foi mesclada em 21 de agosto — o quick start do model card ainda manda instalar a partir daquele pull request, o #52816, o que data o card, não o ecossistema. E um drafter treinado para o Qwen3.8-27B não podia ser testado sob carga antes de existir, então toda medição de carga que alguém tem, incluindo a reprodução em concorrência 8 mais adiante, é posterior ao lançamento.
Uma coisa que o fornecedor fez no lançamento merece ser nomeada. Ele mesmo publicou as tabelas de concorrência 8 e concorrência 32, no model card, logo abaixo do número de destaque. A maioria dos fornecedores não faria isso. É por isso que a discordância é sobre como ler os números, não sobre se os números existem.
A discordância começa nas próprias tabelas do fornecedor
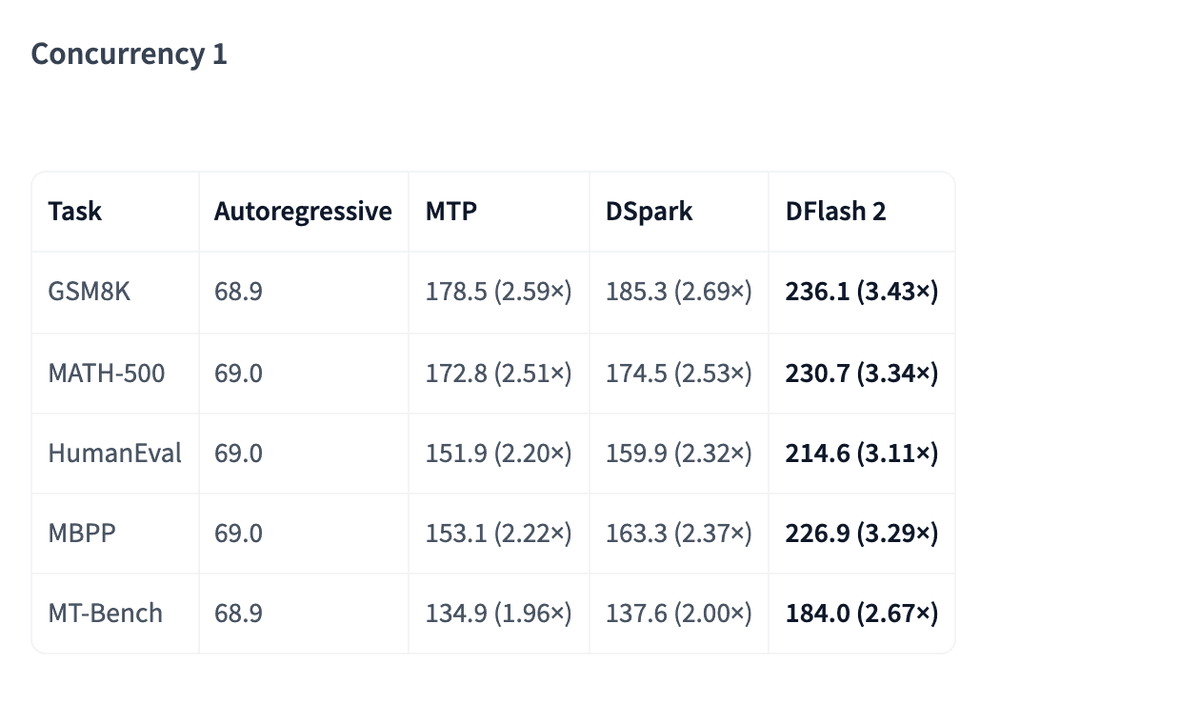
Toda cifra do model card vem de uma única configuração: SGLang numa única NVIDIA H200, FlashAttention 3 tanto para a atenção do alvo quanto para a do rascunho, block size de especulação 8. Sob ela, a curva do GSM8K marca 3.43× em concorrência 1, 2.84× em concorrência 8 e 1.45× em concorrência 32.
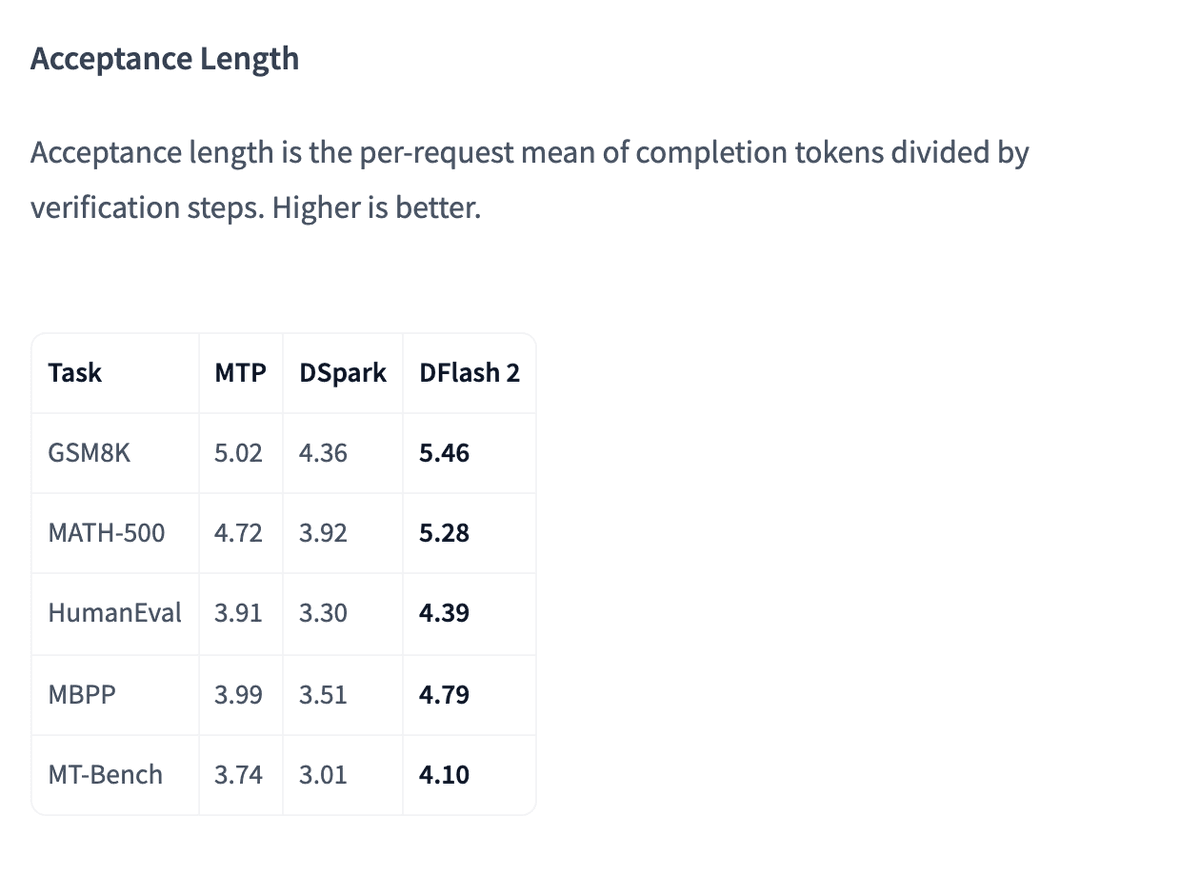
O tipo de tarefa move o resultado quase tanto quanto a carga, e o motivo está na tabela no topo desta página. O comprimento de aceitação — tokens de conclusão divididos pelas etapas de verificação — fica em 5.46 no GSM8K e 4.10 no MT-Bench. Menos tokens rascunhados sobrevivem a cada etapa de verificação num chat aberto, então há menos a ganhar; o MT-Bench termina, assim, em 1.01×, onde o GSM8K se mantém em 1.45×.
A degradação com a carga tem uma causa separada, e não é um bug. Produzir um token movimenta muito mais dados de peso do que aritmética, então os multiplicadores da GPU ficam em grande parte ociosos enquanto isso acontece. A especulação é uma forma de gastar essa capacidade ociosa. O batching é outra, e há apenas uma reserva.
The batch and the draft are drawing on the same account.
Essa medição foi feita em AMD RDNA4, não numa H200, e a aritmética é específica a ela: capacidade de rascunho por agente de (24 − batch_size) / batch_size, o que dá cerca de 23 tokens de especulação para um único agente e cerca de 2 para cada um quando oito estão rodando. Silício diferente, mesma forma — e é a forma que as próprias tabelas do model card traçam.
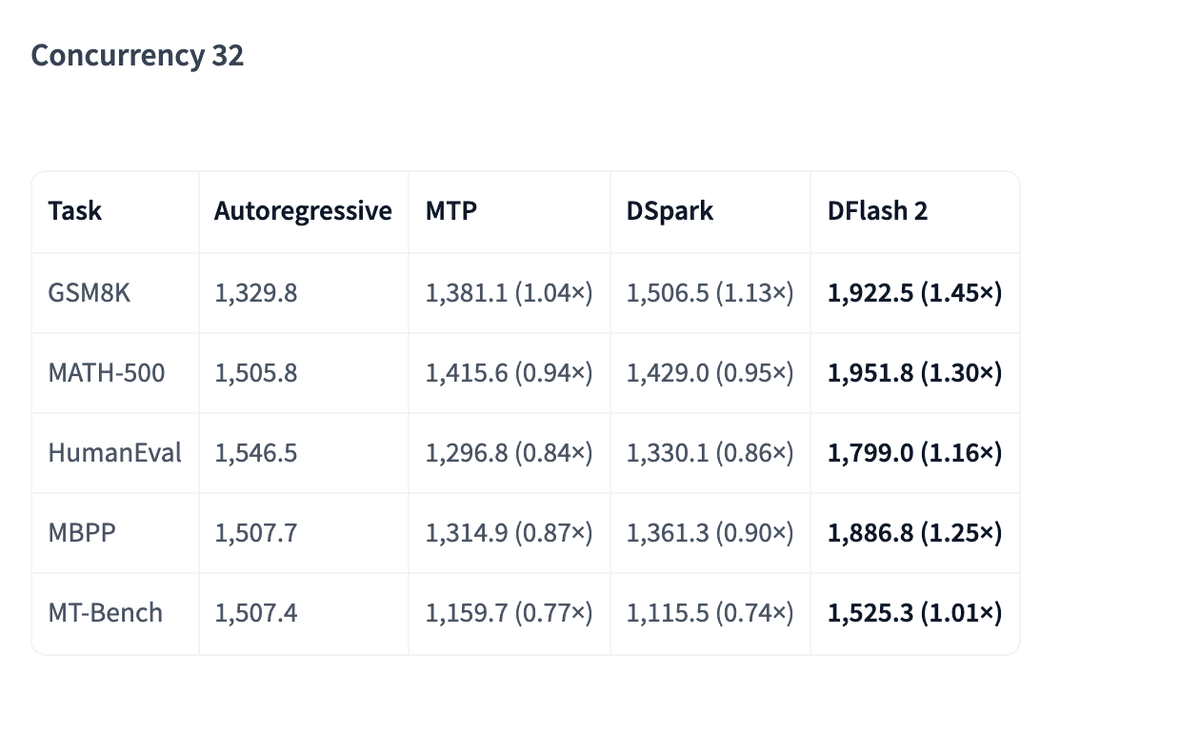
Veja o que acontece com os vizinhos nesse quadro. Em concorrência 32, MTP e DSpark marcam abaixo de 1.00× em MATH-500, HumanEval, MBPP e MT-Bench. Ali, a especulação não está apenas deixando de ajudar; está tirando throughput. O DFlash 2 se mantém acima da linha d'água nas cinco tarefas, o que é um resultado real — só não é o resultado que todo mundo cita.
O modo de falha que isso produz na prática é uma falha de planejamento, não técnica:
sees 2.5x speedup, ships it — then observes 5% regressions in production where p50 concurrency is 16
— Tian Pan
Segundo custo, e este é um problema de correção, não de performance. Rodando a configuração de cookbook do DFlash 2 com o Qwen3.8-27B no SGLang:
under high concurrent load, sometimes the last user message is appended to the wrong context
L3tum estava numa RTX Pro 6000. O que torna o relato difícil de descartar é que uma segunda pessoa reproduziu o problema em outro hardware e depois o mediu: gabrielbryk, numa DGX Spark contra um alvo NVFP4, registrou 7 respostas erradas em 100 requisições em concorrência 8, contra 0 em 100 rodando a mesma configuração de forma serial e 0 em 304 com a especulação desligada. Expandindo os casos afetados para uma amostra maior, a taxa de falha dentro desse subconjunto chegou a 111 de 304 — a cifra que as pessoas citam, e não a taxa que o seu tráfego veria. Dentro desse conjunto expandido, trocar o alvo para um lm_head denso em BF16 reduziu as 111 falhas a 1, sem eliminá-las, o que sugere que o desvio está no caminho de verificação sob composição de batch, e não num artefato de quantização. Isso não são travamentos. São conclusões bem formadas, que reafirmam as restrições corretamente e depois respondem a uma pergunta diferente. Voltar para o MTP fez isso parar. Nenhuma correção foi publicada.
Terceiro, memória. O model card declara 2B de parâmetros em BF16 para o drafter e nunca converte isso em gigabytes nem numa fração da reserva da H200.
Spec decode isn't free. You're paying VRAM for both models simultaneously.
Aquele texto era sobre um draft model de 4B, não sobre o DFlash 2, e a parte transferível é a contabilidade, não as cifras: os dois modelos ficam na memória ao mesmo tempo, a stack de serving pré-aloca mais do que você estimou, e as duas correções oferecidas são encolher o draft model ou cortar paralelismo. Reduzir para um draft de 0.6B recuperou cerca de 2 GiB naquele caso. As duas medidas encolhem o ganho de velocidade que você estava comprando.
Em defesa do fornecedor: ele publicou a degradação, publicou uma definição de comprimento de aceitação contra a qual dá para conferir suas próprias tabelas, e foi direto sobre como a comparação foi construída.
We trained the DFlash and DSpark drafters ourselves under matched setups, while MTP ships with the model.
— Inco AI
Leia isso duas vezes. É uma divulgação de boa prática e um alerta ao mesmo tempo: duas das três baselines que o DFlash 2 supera são reimplementações do próprio fornecedor.
Onde a questão da concorrência reaparece
A maioria de quem lê isto nunca vai ser dono da GPU em que o drafter roda. O que essas pessoas possuem é a orquestração na frente dela, e para elas a questão inteira se resume a um número: o tempo de relógio nos seus próprios prompts, na sua própria concorrência. Isso é algo que dá para construir numa tarde. Pegue os vinte ou trinta prompts que o seu produto de fato envia, coloque-os num workflow da Latenode que chama dois endpoints de um catálogo de cerca de 335 modelos, e deixe um nó de JavaScript — que pode instalar qualquer biblioteca do NPM — cronometrar cada chamada e registrar o par. Depois pare de rodar um de cada vez. Dispare o workflow em paralelo para reproduzir a carga que você atende: um plano pago inclui 5 workers de execução paralela, e mais workers são um add-on a $10 por worker por mês, então a concorrência do seu teste é um número que você escolheu e pode citar ao lado do resultado — exatamente o que as tabelas do fornecedor fazem, e o que a maioria dos benchmarks internos não faz. O medidor coopera com o experimento — a Latenode cobra pelos segundos de CPU que uma execução de fato consome, não por nó e não por chamada de API, sem mínimo por execução, então uma varredura de algumas centenas de execuções curtas custa os segundos que leva, e não uma tarifa fixa por execução. Não há integração com DFlash 2 ou SGLang na Latenode, e este artigo não está alegando isso; a velocidade do decoder continua sendo problema do provedor. A parte transferível é a medição, feita sob a sua carga, não sob a do benchmark.
Quem deveria gastar a tarde
Use se a sua carga de trabalho de fato se parece com o benchmark: gerações longas, poucas requisições em voo, uma placa de classe H200, um alvo da família Qwen3.8, e SGLang ou um vLLM recente o bastante para carregar o merge de agosto. Processamento de documentos em lote durante a noite, um assistente de código para um único desenvolvedor, um agente interno que ninguém mais está enfileirado atrás. Nesse regime, os comprimentos de aceitação são os melhores entre os três drafters em toda tarefa medida, e o 3.43× é real.
Não use isso numa camada de serving compartilhada neste trimestre. Dois motivos, e o segundo é o desclassificante. O argumento de throughput se esvazia exatamente onde a produção vive:
Above that, the gains from speculation are consumed by verification overhead at scale.
— Tian Pan
E sete requisições em cem retornando uma resposta errada com confiança em concorrência 8, quando a mesma configuração com a especulação desligada não retorna nenhuma, não é um parâmetro de ajuste. Até essa issue ser fechada, a posição honesta é que o DFlash 2 é um bom drafter com um bug de integração não resolvido justamente na stack que o próprio cookbook manda usar.
Se você vai avaliar mesmo assim, meça duas coisas que o card não entrega: a memória residente com o drafter carregado e as suas configurações reais de KV-cache, e a acurácia das respostas na sua concorrência de p50, não em concorrência 1. As duas são baratas. As duas são os números que decidem tudo.
Era assim que as coisas estavam em 22 de setembro de 2026. Projetos mudam rápido — confira a fonte antes de confiar nisso.
Perguntas frequentes
- Além da H200, de que mais os números publicados dependem?
O block size é 8, ou seja, sete tokens de rascunho por etapa de verificação; a amostragem segue a temperatura 1.0, top-p 0.95 e top-k 20 recomendados para o Qwen3.8; e a saída tem limite de 4,096 tokens. Toda cifra de throughput e de comprimento de aceitação no card foi produzida sob essa combinação exata, então um deployment que difira em qualquer um desses pontos não é comparável até você remedir.
- Dá para rodar no vLLM?
A implementação no vLLM foi mesclada em 21 de agosto de 2026, então o método já existe upstream ali, assim como no SGLang. O card não se atualizou: o quick start ainda manda instalar a partir do pull request #52816, que continuava sem merge quando o card foi publicado. Confira sua versão do vLLM contra a data do merge, em vez de seguir o card. Note também que os relatos de correção em concorrência 8 foram registrados contra o SGLang, o que significa que o comportamento do vLLM sob a mesma carga está sem medição pública, e não está limpo.
- O DFlash 2 só funciona com o Qwen3.8-27B?
Um drafter DFlash 2 é treinado contra um único alvo, e dois foram lançados: este e um drafter para o Muse Glimmer, para o qual o fornecedor relata 3.1–4.6× em vez de 2.7–3.4×. O lançamento de agosto cobriu esses dois alvos e nenhum outro, e as medições publicadas pelo fornecedor cobrem apenas a H200. Combinar o drafter com um alvo para o qual ele não foi treinado não é uma opção de configuração.
- A saída é mesmo idêntica à do modelo base?
Essa é a alegação matemática, e a matemática em si não está em disputa: a decodificação greedy bate exatamente com o alvo, e a amostragem preserva sua distribuição. O que fica em aberto é se as implementações a honram. As respostas erradas em concorrência 8 parecem uma falha de integração de serving, divergência no caminho de verificação sob composição de batch — mas quem mediu isso aponta para um segundo relato, z-lab/dflash issue 159, de divergência greedy em relação à decodificação autorregressiva simples em MLX, sem SGLang envolvido, e admite que parte disso pode estar no próprio contrato de verificação. De qualquer forma, a distinção importa para quem está corrigindo isso e não importa nada para quem recebe a resposta errada.
- Por que as pessoas relatam comprimentos de aceitação bem abaixo do 5.46 do card?
Porque o comprimento de aceitação é uma propriedade do deployment inteiro, não do drafter isolado. Um relato aberto no rastreador do DFlash, z-lab/dflash issue 170, registra cerca de 3 no llama.cpp contra cerca de 5.5 no vLLM — mas o runtime não é a única coisa que muda. Os alvos são checkpoints diferentes, um GGUF Q6_K contra um build AWQ MXFP4, e os dois drafters também são quantizações diferentes. A hipótese principal de quem relatou, declarada no próprio título da issue, é o pareamento de alvo, não o engine. Controle os checkpoints antes de culpar o runtime, e leia 5.46 como uma cifra produzida por uma configuração específica, não como uma meta que o seu deployment deixou de atingir.