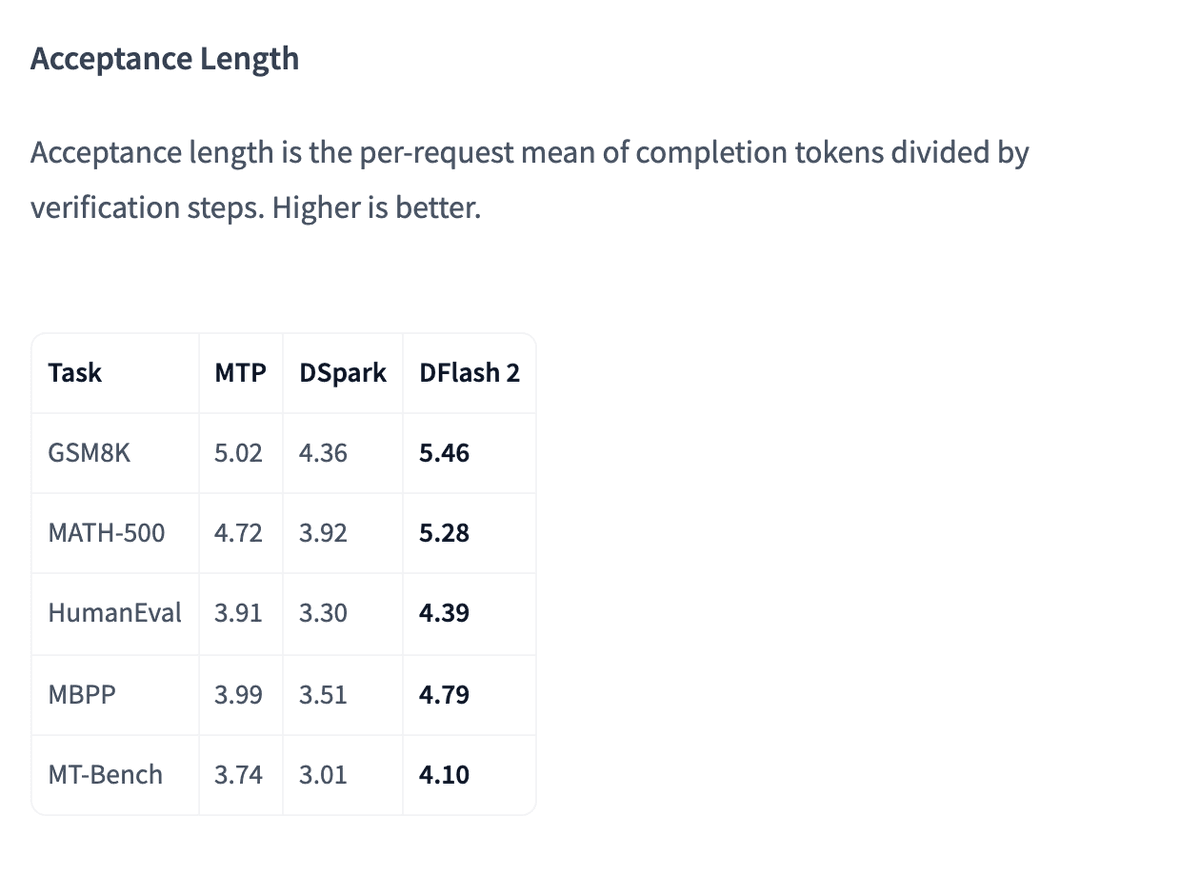
DFlash 2: um drafter de 3.43× que cai a 1.45× sob carga
O drafter de difusão em blocos da Inco AI chega a 3.43× no GSM8K com uma requisição e cai para 1.45× em concorrência 32. Veja o custo em memória e variância.

Todas as análises publicadas, das mais recentes para as mais antigas.
O drafter de difusão em blocos da Inco AI chega a 3.43× no GSM8K com uma requisição e cai para 1.45× em concorrência 32. Veja o custo em memória e variância.
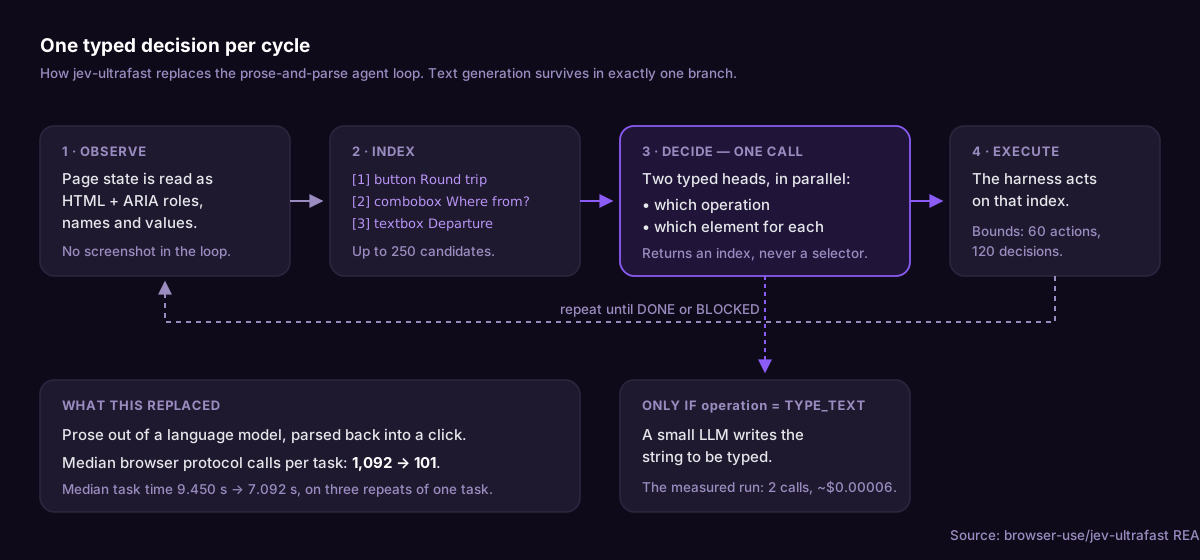
O jev-ultrafast, da browser-use, conclui uma busca no Google Flights em 7,1 segundos ao trocar o loop do agente por uma decisão tipada por ciclo. Eis a armadilha.
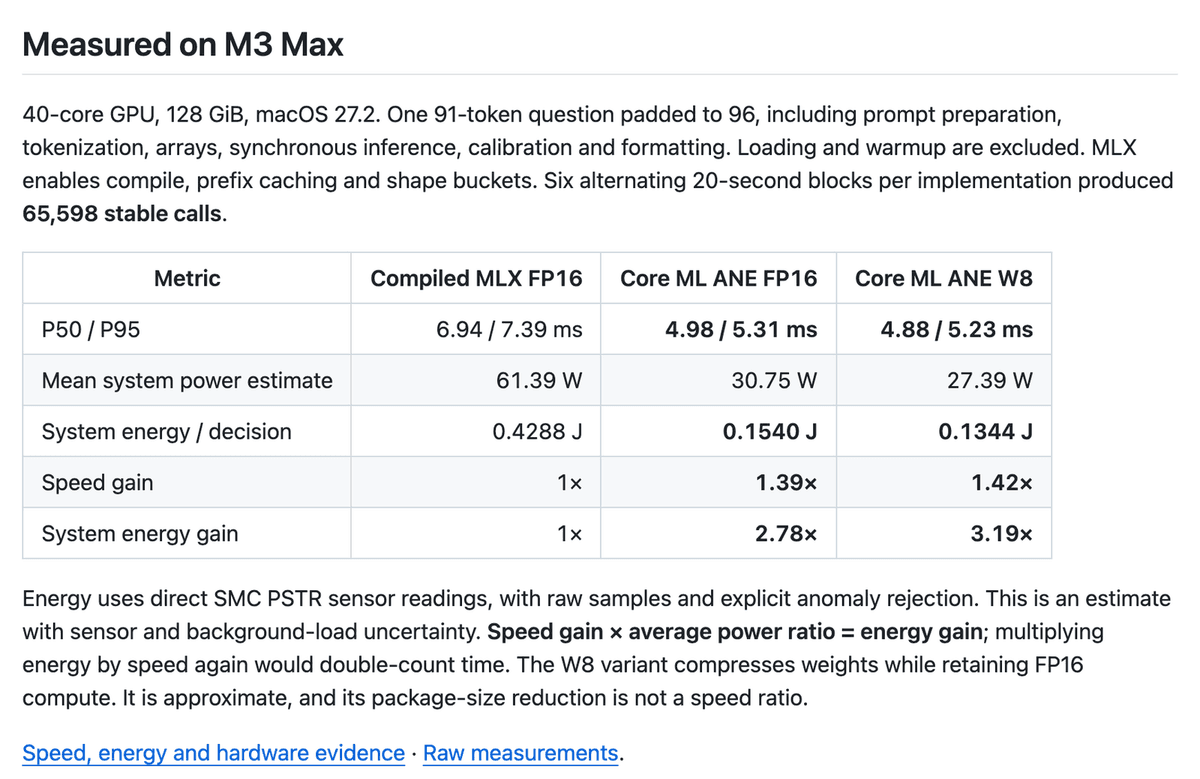
O port Core ML de mizorewww roda uma decisão tipada da Laya em 4.98 ms e 0.154 J num M3 Max. O que os testes de paridade provam, e o que não provam.
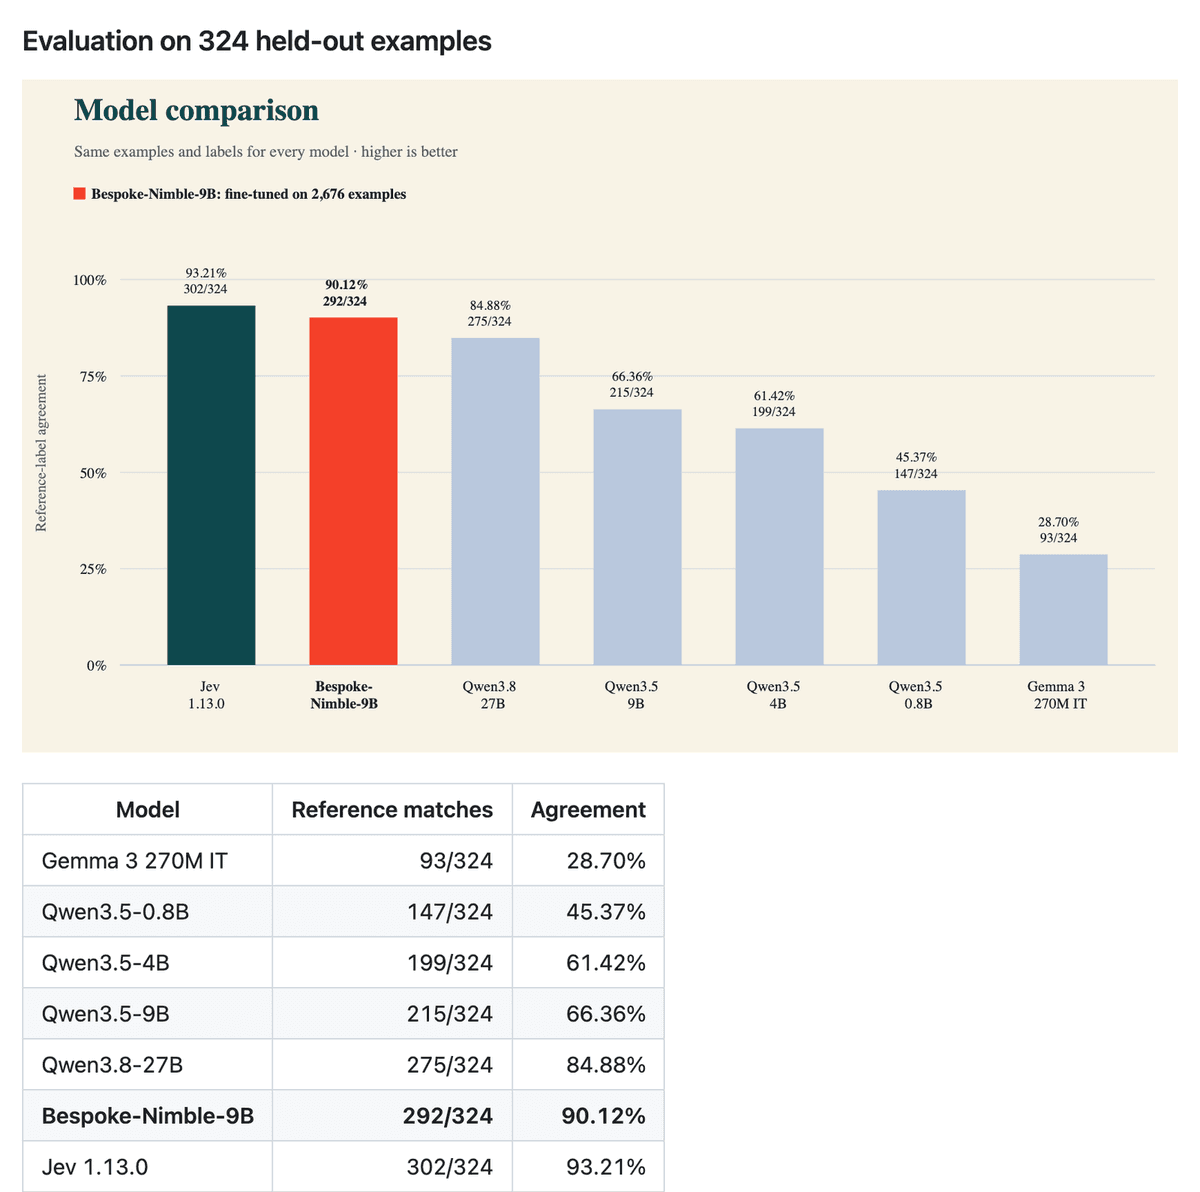
A Bespoke Labs ajustou o Qwen3.5-9B com 2,676 exemplos sintéticos. Atinge 90.12% contra 93.21% do Jev, com avaliação em seis dos dez domínios treinados.