
Jev Ultrafast: o agente que parou de escrever texto
Publicado em 22 de setembro de 2026
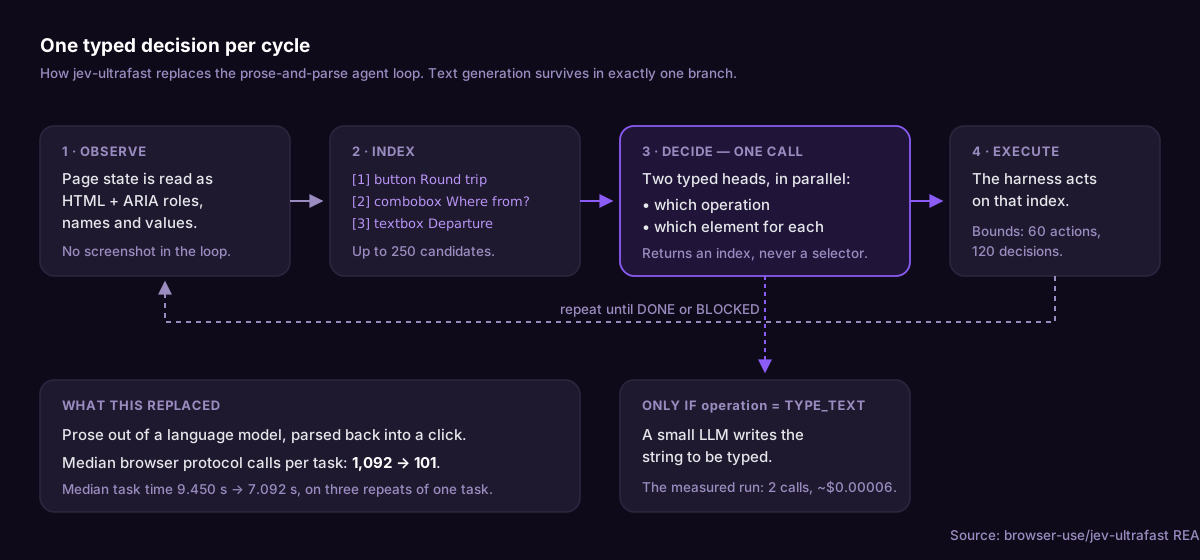
Um agente de navegador sem geração de texto
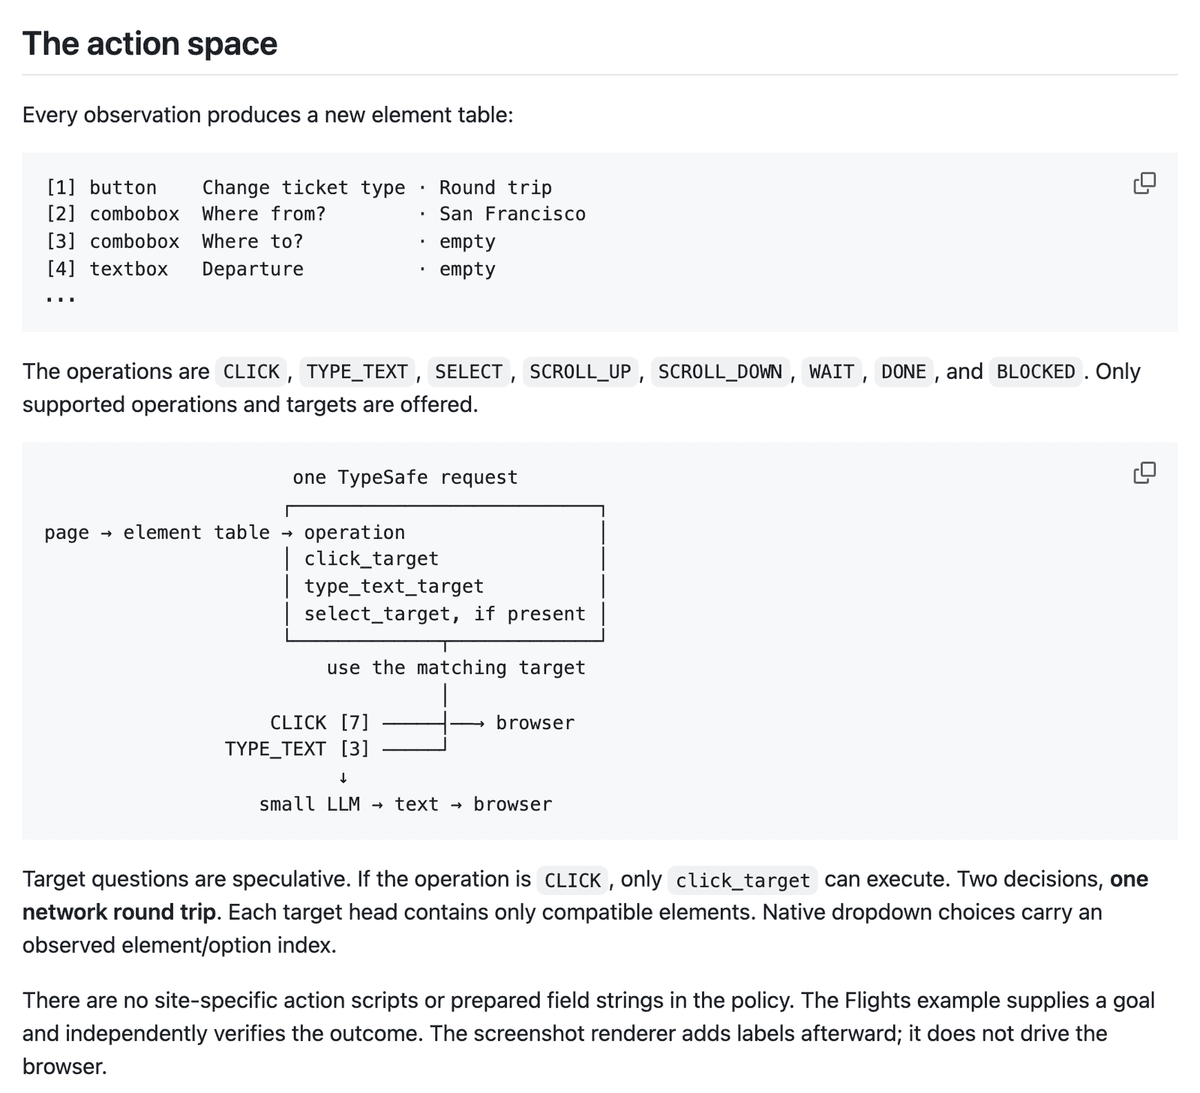
A maioria dos agentes de navegador funciona perguntando a um modelo de linguagem, em texto corrido, o que fazer a seguir, e depois convertendo esse texto de volta em um clique. O browser-use/jev-ultrafast não. A cada observação, ele monta uma tabela indexada dos elementos acessíveis da página e faz ao modelo Jev, da TypeSafe, duas perguntas tipadas de uma vez: qual operação e qual elemento para cada operação disponível.
One request per decision cycle. Operation and target heads share the same observed state.
— browser-use/jev-ultrafast README
O vocabulário de operações tem oito itens: CLICK, TYPE_TEXT, SELECT, SCROLL_UP, SCROLL_DOWN, WAIT, DONE, BLOCKED. Só são oferecidas as operações que o estado daquela página específica suporta. Nada do que o modelo retorna vira um seletor, uma coordenada ou JavaScript executável — ele retorna um índice em uma tabela construída pelo harness.
A geração de linguagem sobrevive em exatamente um lugar:
A small LLM writes text only when the operation is TYPE_TEXT.
— browser-use/jev-ultrafast README
Esse é o design inteiro. Um classificador rápido decide, um modelo pequeno digita, e um executor determinístico valida o alvo — atualidade do documento, geometria, oclusão de clique — antes de tocar em qualquer coisa.
Por que isso surgiu nesta semana
A TypeSafe abriu o Jev ao público em 20 de setembro, cinco dias depois de anunciá-lo. O jev-ultrafast foi a coisa mais visível construída em cima dele: cerca de 17.000 estrelas em uma semana, e o termo jev aparecendo em 74 nomes de itens diferentes no mesmo feed de sete dias. Isso não é um projeto isolado bombando. É um ecossistema se formando ao redor de um modelo que chegou com uma proposta incomum:
Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out.
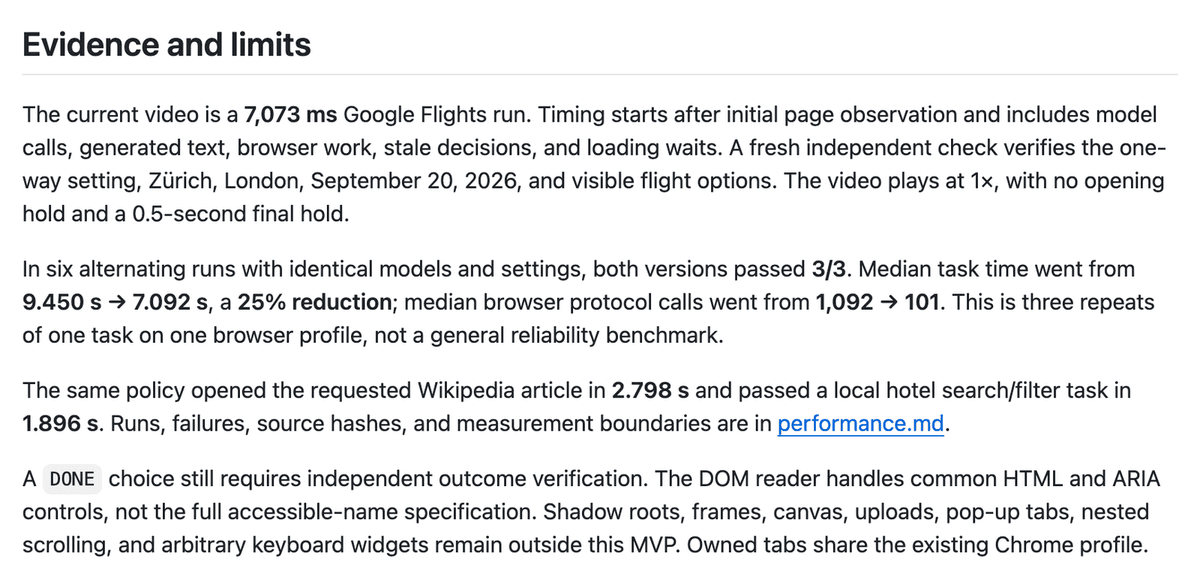
O agente é a demonstração de que a proposta sobrevive ao contato com algo bagunçado. O próprio arquivo de medições do projeto relata que uma busca de Zurique a Londres no Google Flights terminou em 7,1 segundos de ponta a ponta, incluindo carregamentos de página e o texto que o modelo digitou nos campos. Em comparação com a arquitetura anterior do projeto:
Median task time went from 9.450 s → 7.092 s, a 25% reduction; median browser protocol calls went from 1,092 → 101.
— browser-use/jev-ultrafast README
Os 25% são a manchete. A queda de dez vezes nas chamadas de protocolo do navegador é o número interessante, porque essa é a parte que escala: menos idas e vindas por decisão significa que o custo de rodar cem sessões em paralelo cai junto.
Sobre o que as pessoas estão realmente discutindo
Ninguém publicou uma crítica a esse agente. Ele entrou no feed desta semana em 16 de setembro, tem um único contribuidor, nenhum release publicado e commits de cinco dias atrás, e as únicas medições públicas sobre ele são as próprias. O honesto a relatar é que a divergência está uma camada abaixo, sobre o modelo em que o agente é construído — e que a maior parte dela se transfere.
O projeto é incomumente direto sobre os limites dos seus próprios números:
This is three repeats of one task on one browser profile, not a general reliability benchmark.
— browser-use/jev-ultrafast README
O anúncio da TypeSafe faz uma afirmação forte sobre a arquitetura: como o Jev abre mão totalmente da geração de strings e retorna um valor de um schema, ele não pode alucinar. Os próprios gráficos do fornecedor colocam isso em zero nas duas métricas de erro:
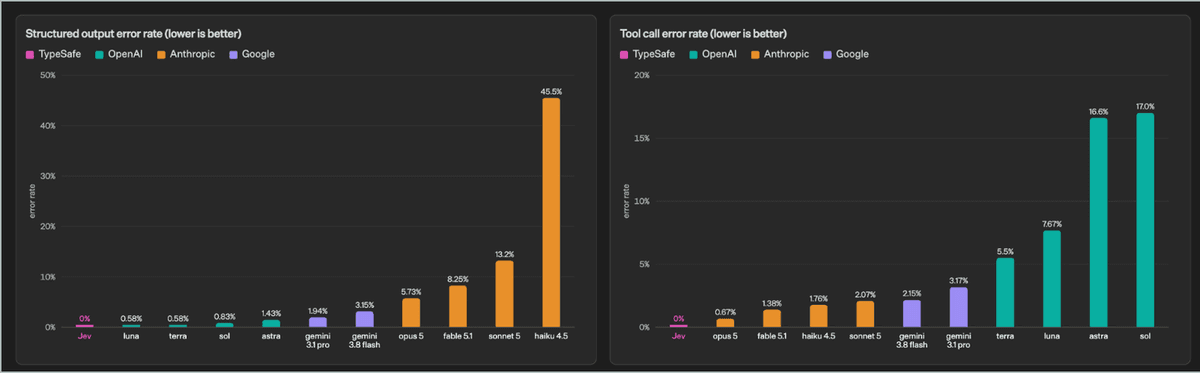
A objeção mais afiada ao Jev diz respeito ao que essa garantia realmente vale:
"Zero hallucination" = schema guarantee, not correctness guarantee — understand this distinction before building.
Isso recai diretamente sobre o agente. Sua operação DONE é uma decisão tipada como qualquer outra, e o README admite que uma escolha DONE ainda exige verificação independente do resultado. Um DONE bem formado e errado parece exatamente igual a um DONE bem formado e certo.
A avaliação independente do Jev mal começou. O projeto jev-capability-atlas rodou o Jev e a família Laya sobre entradas idênticas pela primeira vez e descobriu que a troca é real nas duas direções:
Laya's fine-tuned specialist does beat Jev by 3 points on its own training distribution
— Zaious, jev-capability-atlas
— só que com cinco vezes o erro de calibração, e abaixo de uma linha de base cega à entrada assim que sai da própria distribuição, onde os mesmos testadores encontraram a Laya muito atrás em chinês. O Jev tem seu próprio problema de idioma: a TypeSafe afirma que o Jev é menos preciso em CJK, e o atlas se propôs a medir isso em vez de aceitar por confiança. Na revisão de texto em chinês, ele capturou 67% dos caracteres errados com um limiar de confiança de 0,5, com uma taxa de falso alarme de 12% no conjunto SIGHAN. Elevar o limiar para 0,7 reduziu os falsos alarmes para 5% e a taxa de captura para 38%. E há uma ressalva comercial ligada ao argumento de custo do qual a economia do agente depende:
vendor says it can't prove the price isn't subsidized — treat it as today's price.
Uma última objeção vem de um projeto irmão, não deste: um testador do jaredpalmer/kev encontrou um modelo de decisão tipada que lidava corretamente com comparação de limiares e mapeamento ordinal, mas não conseguia subtrair duas datas, e resolveu o problema colocando a contagem de dias no estado em vez de pedir que o modelo calculasse. Modelo diferente, mesma lição. Decisões tipadas só são tão boas quanto o que você entrega a elas.
Onde isso se encaixa em um pipeline
Você pode construir esse formato hoje no Latenode sem nenhuma das peças acima. O navegador headless na nuvem oferece Puppeteer completo, então navegação, esperas, preenchimento de formulários e extração são código que faz a mesma coisa a cada execução, em navegadores que você não precisa instalar, corrigir ou manter ativos. Quantas dessas execuções rodam ao mesmo tempo é um teto que você dimensiona, não uma variável livre: a quantidade se chama max execution workers, o número de execuções de workflow que um workspace processa simultaneamente. Um plano pago inclui cinco, e além disso a concorrência é um complemento de worker reservado a US$ 10 por worker ao mês. Processe mil páginas em lote e elas ficam na fila atrás desse número. Ao redor disso, um node JavaScript com o registro NPM cuida de estado e validação, e você chama um modelo — do catálogo em /ai-models — só no ponto de decisão em que a página é genuinamente ambígua. O modelo de cobrança recompensa a mesma divisão. O Latenode mede os segundos de CPU que uma execução realmente consome, sem mínimo por execução, então uma tarefa que termina em 7,1 segundos em vez de 9,5 custa, sim, menos — proporcionalmente, e a diferença se acumula ao longo de um lote. Vale a pena explicitar o mecanismo com precisão, porque é fácil entender ao contrário: o medidor precifica tempo de execução, não chamadas. Mil idas e vindas do navegador custam mil operações faturáveis em uma plataforma por operação; aqui elas custam o tempo que levarem, então um loop de agente tagarela só fica caro na medida em que é lento. Não há integração com o Jev no Latenode, e este artigo não está afirmando que haja; o que vale a pena importar é a arquitetura.
Quem deveria dedicar tempo a isso
Leia o documento de design se você constrói automação de navegador. A ideia de que o espaço de ações deve ser enumerado pelo harness e apenas indexado pelo modelo vale uma hora do seu tempo, quer você chegue a chamar a TypeSafe ou não.
Não coloque isso em produção neste trimestre. A lista do que não é suportado desqualifica a maioria dos sites reais:
Shadow roots, frames, canvas, uploads, pop-up tabs, nested scrolling, and arbitrary keyboard widgets remain outside this MVP.
— browser-use/jev-ultrafast README
Qualquer coisa atrás de um iframe — formulários de pagamento, seletores incorporados, a maioria dos fluxos de consentimento — fica de fora. Uploads também. Some a isso uma dependência de fornecedor único em uma API de acesso antecipado cujo próprio fornecedor não chama de definitivo o preço, nenhum release marcado, e um histórico de sucesso de três tarefas, e o risco fica óbvio.
Quem deveria rodar isso agora são as pessoas capazes de medi-lo: uma suíte de tarefas própria, nas suas próprias páginas, relatada publicamente. É isso que falta ao ecossistema, e é barato de produzir.
Era assim que as coisas estavam em 22 de setembro de 2026. Projetos mudam rápido — confira a fonte antes de confiar nisso.
Perguntas frequentes
- Preciso de uma conta na TypeSafe para rodar o jev-ultrafast?
Sim. O agente precisa de TYPESAFE_API_KEY para o modelo de decisão e de uma TEXT_MODEL_API_KEY separada para o modelo pequeno que escreve o texto. A configuração de exemplo aponta a segunda chave para o OpenRouter e o modelo inception/mercury-2.5, com o raciocínio desativado, mas Gemini, GLM ou DeepSeek funcionam pelo mesmo helper compatível com a API da OpenAI.
- O agente olha para capturas de tela da página?
Não no loop padrão. Ele lê o estado estruturado - papéis ARIA e HTML, nomes, valores e texto visível - e monta uma tabela indexada de elementos candidatos. Capturas de tela aparecem no inspetor local para humanos, não no caminho de decisão.
- Por quanto tempo uma única execução pode durar?
Sessenta ações de navegador e 120 requisições de decisão, o que vier primeiro. Até 250 candidatos de ação são mantidos por observação, e qualquer coisa truncada além disso simplesmente não pode ser selecionada - o que é um modo de falha real em páginas muito longas.
- Como fixo a versão de algo que não tem releases?
Você fixa um hash de commit, o que significa que a decisão de atualizar é inteiramente sua. Não há notas de release para ler, nenhum sinal de versão semântica indicando que uma mudança quebra compatibilidade, e nenhuma tag para reverter - então reserve tempo para ler o diff você mesmo a cada atualização, e vendorize a dependência se uma mudança silenciosa upstream puder causar dano.
- Quanto custa uma decisão?
A TypeSafe lista a entrada a US$ 0,042 por milhão de tokens, com a saída gratuita. A execução medida no Google Flights também gastou cerca de US$ 0,00006 em duas chamadas ao modelo pequeno de texto, então nessa escala o tempo de navegador custa mais do que a inferência.