
Laya no Neural Engine: 4.98 ms e 0.154 J por decisão
Publicado em 22 de setembro de 2026
Uma decisão precificada em milissegundos e joules
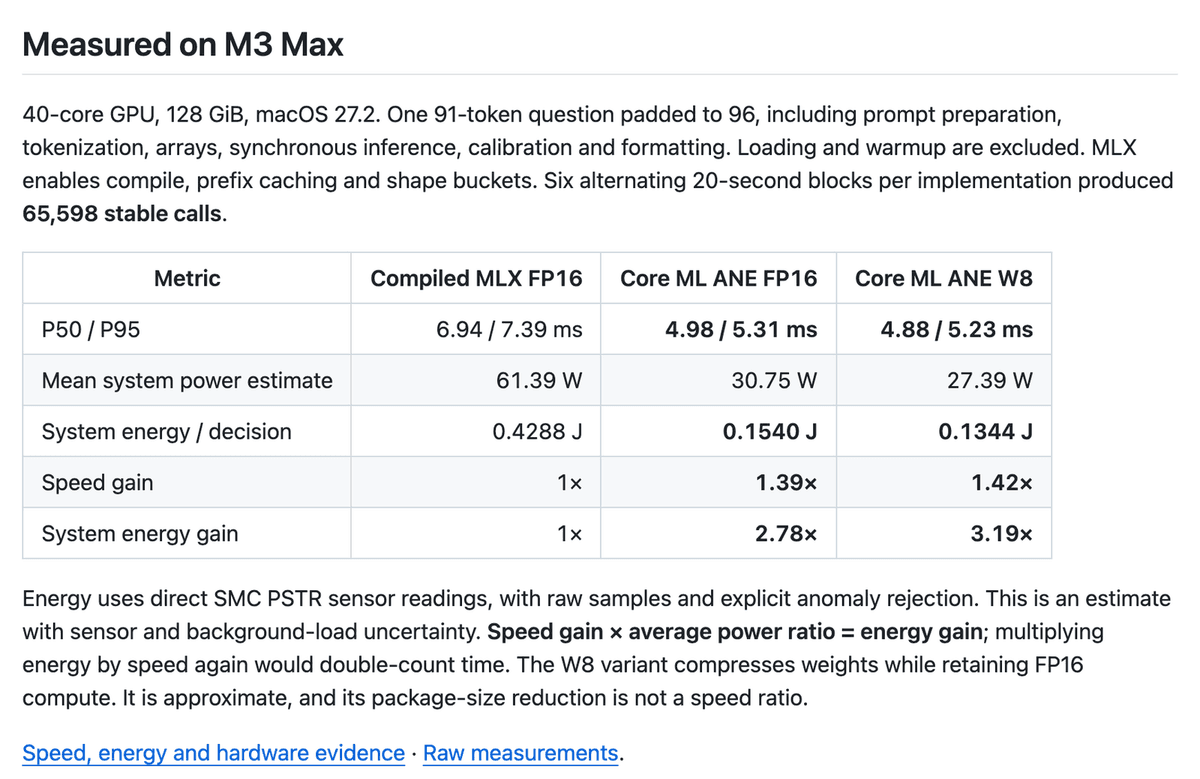
mizorewww/laya-coreml pega os checkpoints de decisão tipada da Laya, converte-os para Core ML e os roda no Apple Neural Engine. O resultado desse trabalho não é uma nova capacidade. É uma tabela de preços.
One short multilingual decision: 4.98 ms P50 / 5.31 ms P95 on M3 Max with ANE FP16.
A mesma tabela coloca o MLX FP16 compilado em 6.94 / 7.39 ms, e a energia por decisão em 0.1540 J para o ANE contra 0.4288 J para o MLX — uma melhoria de 2.78× ao longo de 65,598 chamadas estáveis, com a energia lida do sensor SMC PSTR em vez de modelada. Dez mil decisões no Neural Engine são cerca de 1.5 kJ, ou 0.43 Wh. É um número contra o qual dá para orçar, e é a razão de esse port existir em vez de mais um wrapper.
Antes de gastar esse orçamento, porém, leia as condições do teste.
One 91-token question padded to 96, including prompt preparation, tokenization, arrays, synchronous inference, calibration and formatting.
A pergunta tem 91 tokens; o padding leva o tensor a 96; e 96 é todo o orçamento. O limite total do bundle ANE é de 96 tokens, contando a pergunta, as opções e qualquer estado carregado, e uma requisição maior gera um erro de capacidade. Ou seja, o número principal é medido com a caixa cheia — a forma correta de medir, e também um aviso de que não há folga para encontrar depois.
O que está dentro da caixa importa mais do que os milissegundos, e é essa a parte a checar antes de portar qualquer coisa.
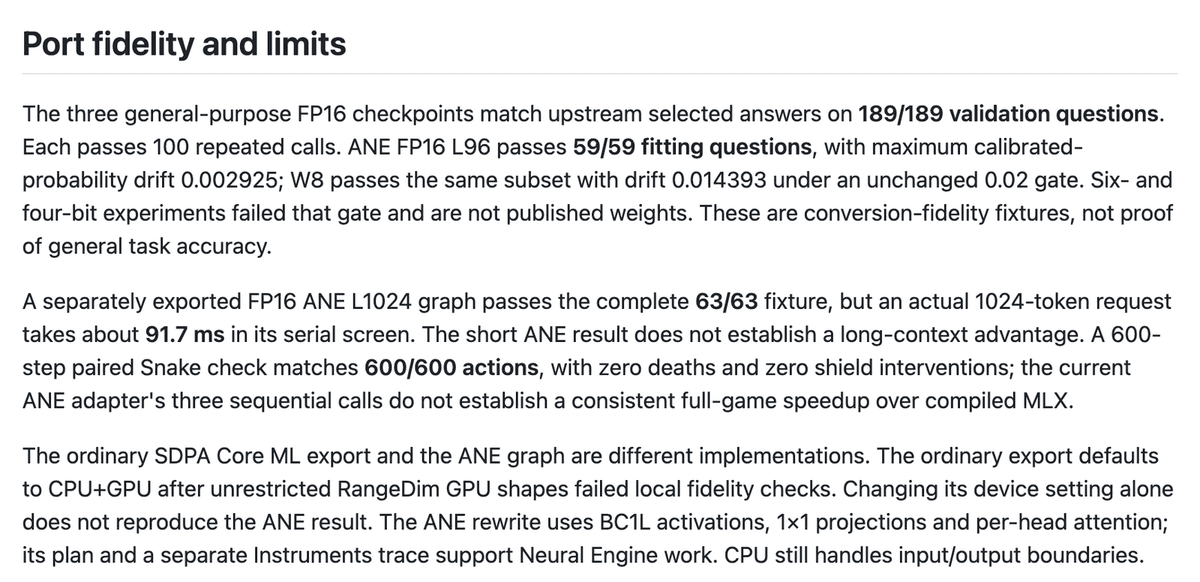
The three general-purpose FP16 checkpoints match upstream selected answers on 189/189 validation questions. Each passes 100 repeated calls.
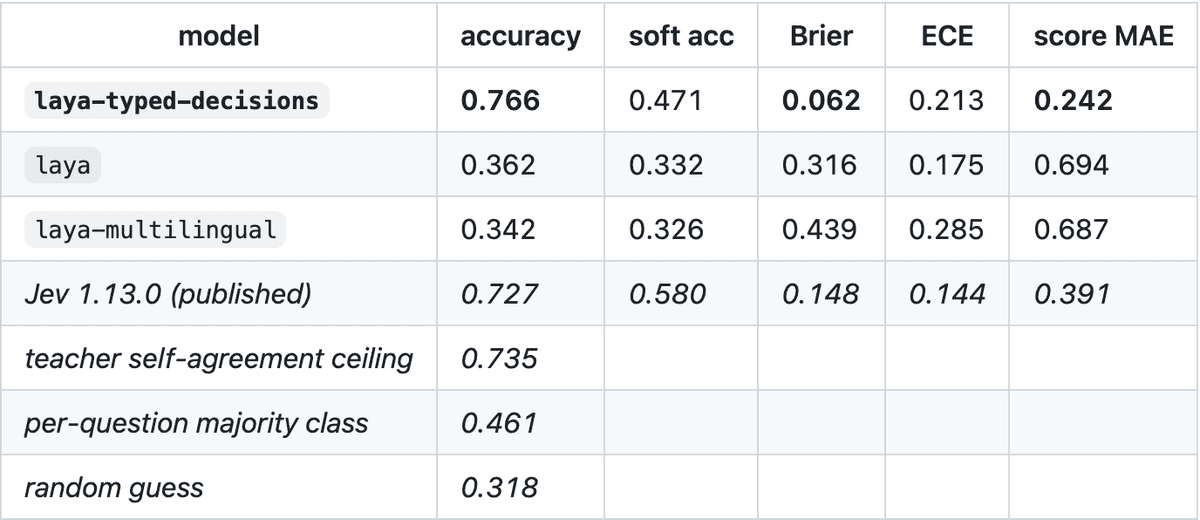
Propósito geral é a expressão-chave aqui. No benchmark de decisões tipadas do upstream, os checkpoints de propósito geral pontuam 0.362 e 0.342, abaixo do 0.461 que um palpite de classe majoritária por pergunta alcança; o 0.766 que faz a Laya parecer forte pertence a um fine-tune específico para a tarefa. O que nenhuma página, de nenhum dos dois lados, informa é um número de acurácia para o bundle que produziu os 4.98 ms. A latência é medida por bundle; a acurácia é medida por checkpoint do upstream; ninguém junta as duas colunas.
O loop é a coisa que precisa ser barata
Oito repositórios carregam o nome Laya no feed desta semana, e os dois com medições associadas são ports de runtime do mesmo autor: um runtime MLX, depois este de Core ML. Nenhum dos dois acrescenta uma capacidade ao modelo. Os dois existem para tornar uma decisão barata o suficiente para caber dentro de um loop que vai rodá-la milhares de vezes — o próprio teste ponta a ponta do port é um jogo de Snake de 600 passos, comparado ação a ação com a versão MLX.
Essa é a premissa sobre a qual o cluster está agindo: que uma ida e volta pela rede não cabe dentro de um frame. Vale nomear isso como premissa, porque ninguém aqui publicou uma medição da alternativa hospedada ao lado da própria. O que o laya-coreml publicou foi a outra metade do orçamento, que quase ninguém mede.
A separately validated W8 palette variant reached 4.88 ms and 3.19× energy improvement.
O mesmo parágrafo acrescenta que esses são resultados de uma única pergunta, não tempos de frame completo do Snake, e que a melhoria de dez vezes que o trabalho buscava não foi alcançada. Dois desenvolvedores que tentaram o mesmo movimento em outros runtimes publicaram então medições num eixo inteiramente diferente: não a velocidade com que o modelo convertido responde, mas se a resposta e a confiança atribuída a ela sobrevivem à conversão.
Fixtures de paridade provam que a resposta não mudou, não que ela estava certa
A validação do port é rigorosa e incomumente clara sobre o próprio escopo. A build ANE FP16 passa em 59 das 59 perguntas de ajuste com desvio máximo de probabilidade calibrada de 0.002925; o W8 passa no mesmo subconjunto com 0.014393, contra um limite inalterado de 0.02; os experimentos em seis e quatro bits falharam nesse limite e nunca foram publicados como pesos. E então, no mesmo parágrafo:
These are conversion-fidelity fixtures, not proof of general task accuracy.
É exatamente nessa distinção que os críticos se apoiam. No Hugging Face, o autor de um port web quantizado relata o que acontece quando você recorre à compressão óbvia:
Ordinary dynamic INT8 destroys this model. onnxruntime.quantization.quantize_dynamic drops argmax agreement to 69% with a worst-case probability shift of 0.99.
— nvkudva, laya-web-q8 model card
Quantizar apenas os MatMuls é catastrófico, enquanto quantizar apenas os embeddings sobrevive, o que aponta para outliers de ativação, não para a precisão dos pesos. Um desenvolvedor trabalhando no mesmo problema em um port para navegador resumiu o trade-off em uma linha:
The difference is the quantization scheme, not the checkpoint, and it is also where the twentyfold speed difference comes from.
— a-voronkov, laya-web-poc PR #16
A calibração é o segundo furo, e é um problema de sequenciamento, não um bug de quantização:
The shipped temperatures were fitted by the original author, not refitted after quantization.
— nvkudva, laya-web-q8 model card
O upstream concorda com a magnitude, no próprio README:
Refitting one temperature per (question type, option count) on held-out data moves mean ECE 0.466 -> 0.081 (laya) and 0.314 -> 0.106 (laya-multilingual).
O port Core ML já capturou uma instância disso dando errado: uma temperatura publicada de 0.1006 para o grupo de onze ou mais opções, afiada o suficiente para relatar uma moeda ao acaso como quase certeza, agora limitada com um aviso nomeado no carregamento. Uma fixture que compara as probabilidades de dois modelos não consegue enxergar um erro que os dois herdam.
A terceira objeção não toca no silício. Ela recai sobre o roteador que escolhe qual checkpoint o silício roda.
128/200 German utterances (64%) went to the English checkpoint.
Um palpite de idioma indeciso é tratado como inglês, e passar lang="de" recupera a acurácia total, então o modelo está bem e o roteamento não está. É uma oscilação de 20 pontos em texto curto de escrita latina, decidida por uma heurística que relata confiança total enquanto erra.
O que ninguém produziu é a comparação que a maioria dos leitores quer:
Accuracy and calibration claims for laya-mlx haven't been independently verified against a shared benchmark like JevBench; the published numbers cover latency, throughput, and memory only.
Repare no que isso deixa de fora. Toda medição acima é local contra local — Neural Engine contra MLX compilado no mesmo laptop, uma pergunta de cada vez. Ninguém publicou uma ida e volta hospedada medida ao lado disso, então "mais rápido que a API" ainda é a premissa da qual esses projetos partem, não um resultado que algum deles relata.
Encaixando isso em algo que vai para produção
O número de 5 ms se sustenta para decisões curtas e de formato fixo, e deixa de se sustentar no instante em que você sai da caixa:
A separately exported FP16 ANE L1024 graph passes the complete 63/63 fixture, but an actual 1024-token request takes about 91.7 ms in its serial screen.
Dezoito vezes a latência. O próprio projeto tira a conclusão:
The short ANE result does not establish a long-context advantage.
Então a versão implantável é um prompt pequeno e fixo, uma lista curta de opções, seleção explícita de idioma em vez de roteamento automático, e temperaturas que você mesmo ajustou nos seus próprios dados rotulados depois da conversão. Reserve orçamento para a rotulagem. Esse é o custo real de integração, não a exportação.
A estrutura por trás de tudo isso é um portão: uma decisão tipada é um classificador, e um classificador se paga quando fica na frente de um trabalho mais lento, de modo que a maioria das entradas nunca chega à chamada de modelo, ao scraping ou à pessoa. Num laptop, o portão é o bundle Core ML, e a economia é que a coisa cara nunca chega a ser pedida. Num pipeline hospedado, o portão é em vez disso o primeiro passo dentro da execução, e essa é uma forma que o medidor do Latenode atende bem: ele conta os segundos de CPU que uma execução realmente consome — tempo de execução, não o número de nodes ou de chamadas de API — e não há cobrança mínima por execução, então uma execução que termina no portão é cobrada pelos segundos que gastou, e não como uma execução inteira. O passo que faz essa triagem é um node comum: um dos cerca de 335 modelos do catálogo, ou um node JavaScript, que pode instalar qualquer biblioteca NPM. O plano gratuito inclui 10.000 segundos de CPU por mês e cinco workflows ativos. Nada disso roda o bundle ANE, que continua no laptop; o que se transfere de um para o outro é a forma, não o artefato.
Quem deveria portar isso nesta semana
Porte se você tem uma decisão fixa, de baixa cardinalidade, dentro de um loop em silício Apple, seu prompt e opções cabem em 96 tokens, você pode declarar o idioma em vez de deixar o roteador adivinhar, e você tem exemplos rotulados para reajustar a calibração. Verifique qual checkpoint do upstream o seu bundle carrega antes de prometer a alguém um número de acurácia — o port é explícito ao dizer que o que ele converteu é a família de propósito geral, e a família de propósito geral não é a linha que bate o professor. Para esse leitor, os números de velocidade e energia são reais e reprodutíveis, o que já é mais do que a maioria das afirmações on-device consegue entregar: 4.98 ms, 0.154 J, medidos por sensor, com 65,598 chamadas por trás.
Pule se você esperava trocar um endpoint de decisão hospedado por isso e manter tudo o mais igual. O trabalho publicado não sustenta essa troca — não existe comparação em benchmark compartilhado, as probabilidades entregues estão descalibradas até você corrigi-las, e o roteamento automático custa silenciosamente 20 pontos em texto curto de escrita latina que não seja inglês. Também há um teto para quantos rótulos você pode pedir:
I've found they start to fail the more classifications you have, long before your typical ML classifier.
Se você está avaliando isso como arquitetura, e não como pacote, a leitura honesta é mais estreita do que a contagem de estrelas sugere: a evidência sustenta colocar uma decisão pequena e bem especificada no Neural Engine a um custo conhecido por chamada, mas ainda não sustenta colocar o seu julgamento lá.
Era assim que as coisas estavam em 22 de setembro de 2026. Projetos mudam rápido — confira a fonte antes de confiar nisso.
Perguntas frequentes
- O laya-coreml é um lançamento oficial da Apple ou da Convai?
Não. O README o descreve como um port independente sob a licença Apache-2.0 e afirma claramente que não é um lançamento oficial da Convai Innovations ou da Apple. Trate os pesos e o harness de benchmark como trabalho da comunidade com um arquivo NOTICE, não como um SDK de fornecedor com canal de suporte.
- A variante W8 torna o modelo significativamente mais rápido?
Muito pouco. Ela registra 4.88 ms de P50 contra 4.98 ms do FP16 - 1.42× contra 1.39× em relação ao MLX compilado. O ganho está na energia, 27.39 W contra 30.75 W de consumo médio do sistema, e no tamanho do pacote. O README avisa que a redução no tamanho do pacote não é uma razão de velocidade, porque o W8 comprime os pesos enquanto o cálculo permanece em FP16.
- A exportação para contexto longo também roda no Neural Engine?
Não por padrão. A exportação Core ML comum via SDPA e o grafo ANE são implementações diferentes, e a comum usa CPU+GPU por padrão depois que formatos de GPU com RangeDim irrestrito falharam nos testes locais de fidelidade do projeto. Trocar a configuração de dispositivo não reproduz o resultado do ANE - o caminho ANE é uma reescrita usando ativações BC1L, projeções 1x1 e atenção por cabeça.
- O que eu realmente preciso para reajustar a calibração?
Exemplos rotulados do seu próprio tráfego, agrupados por tipo de pergunta e número de opções, com uma temperatura ajustada por grupo depois da conversão, não antes. Nada no port faz isso por você. Duas coisas ajudam enquanto você trabalha: os valores não limitados continuam acessíveis como agent.temperature_raw e agent.temperature_by_options_raw, e um RuntimeWarning no carregamento nomeia cada grupo que o port precisou limitar.
- 0.154 J significa que o chip gasta 0.154 joules?
Não. É uma estimativa do sistema inteiro a partir de leituras diretas do sensor SMC PSTR, então inclui o que mais o laptop estava fazendo, e o README sinaliza incerteza de sensor e de carga de fundo. Carregamento e aquecimento (warmup) ficam de fora do número por decisão, o que importa se o seu processo for de vida curta.
- Posso comprimir abaixo de 8 bits para caber em um dispositivo menor?
Não com pesos publicados. Os experimentos do port em seis e quatro bits falharam no limite de 0.02 de desvio de probabilidade calibrada e nunca foram lançados; o W8, com desvio de 0.014393, é o piso que o projeto se dispôs a publicar. Note que o W8 comprime os pesos enquanto o cálculo permanece em FP16, então não é a mesma operação que quantizar ativações, que foi onde os outros runtimes se enrolaram.