
Nimble: 2,676 exemplos para chegar a três pontos do Jev
Publicado em 22 de setembro de 2026
Uma receita, não mais um endpoint
A Bespoke Labs publicou o nimble em 18 de setembro: um adaptador LoRA que transforma o Qwen3.5-9B num modelo de decisão tipada — escolha um destes candidatos, aplique esta política, avalie isto contra esta rubrica — e, mais útil ainda, todo o pipeline que o produziu. Código de curadoria, configuração de treino, ferramental de avaliação, tudo sob Apache 2.0. O adaptador em si tem cerca de 165 MiB e precisa do modelo base de 18 GB ao lado.
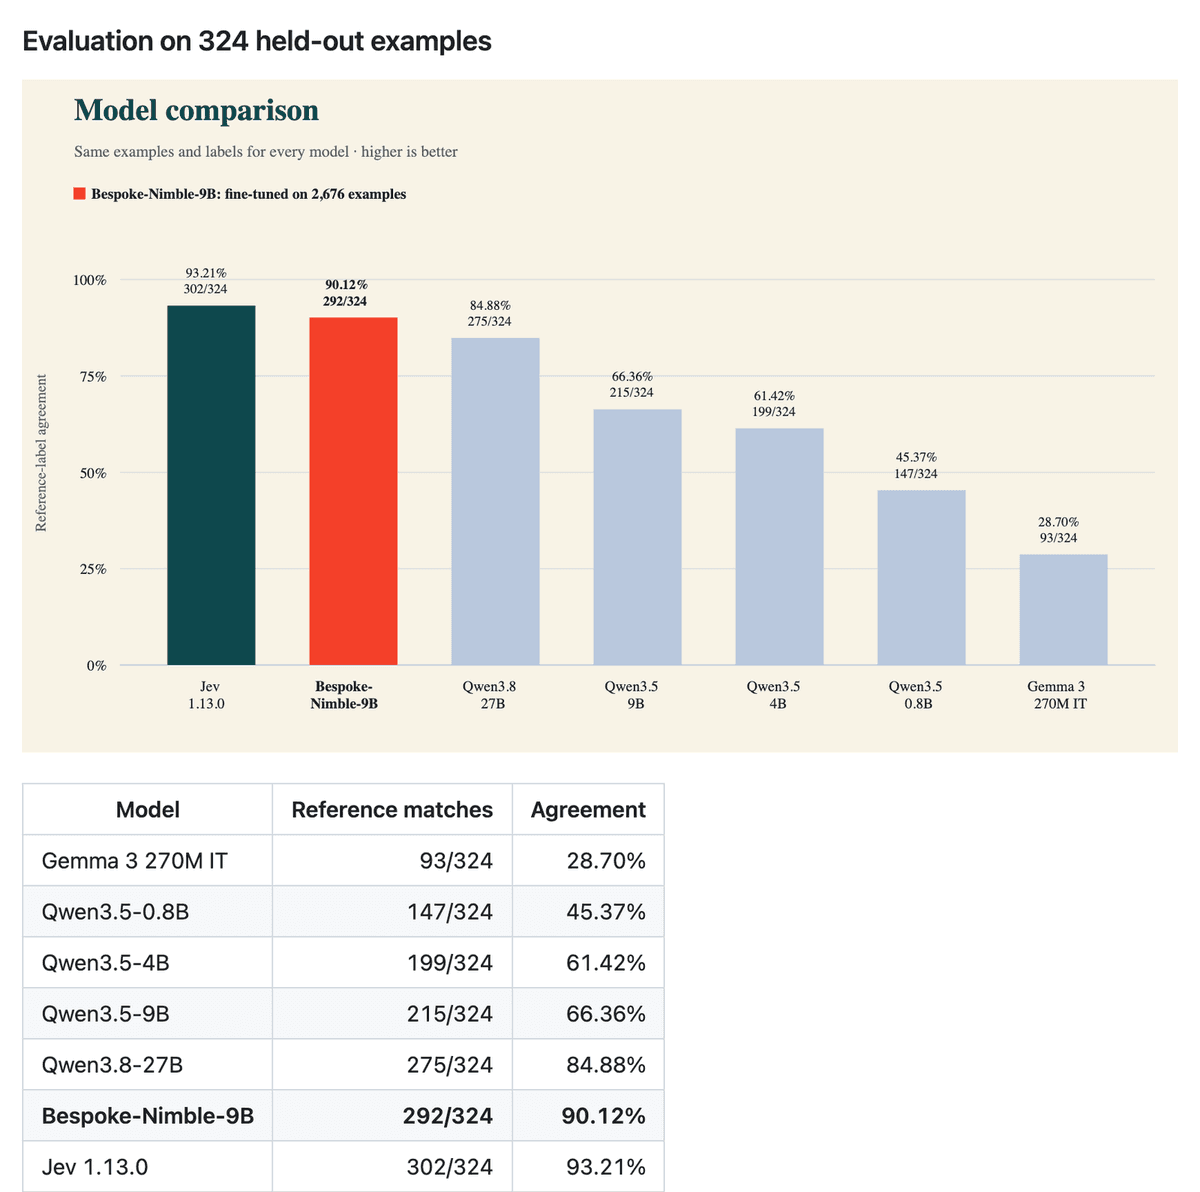
O que isso muda para quem lê é a aritmética de uma questão que as pessoas vinham discutindo sem números: quanto custa parar de chamar o modelo de decisão de outra empresa. No conjunto reservado e congelado de 324 exemplos do projeto, o fine-tune concorda com o rótulo de referência 90.12% das vezes. O Jev 1.13.0, da TypeSafe, atinge 93.21% nos mesmos exemplos. O modelo base sem ajuste atinge 66.36%. Ou seja, o LoRA fecha a maior parte de uma diferença de 26.85 pontos e deixa três pontos na mesa.
Note that we did not distill from Jev.
Essa frase está fazendo um trabalho de verdade. Ela significa que a receita é uma receita, e não uma cópia, e que os três pontos são o custo de construir seus próprios dados de treino, e não o custo de uma imitação com perdas.
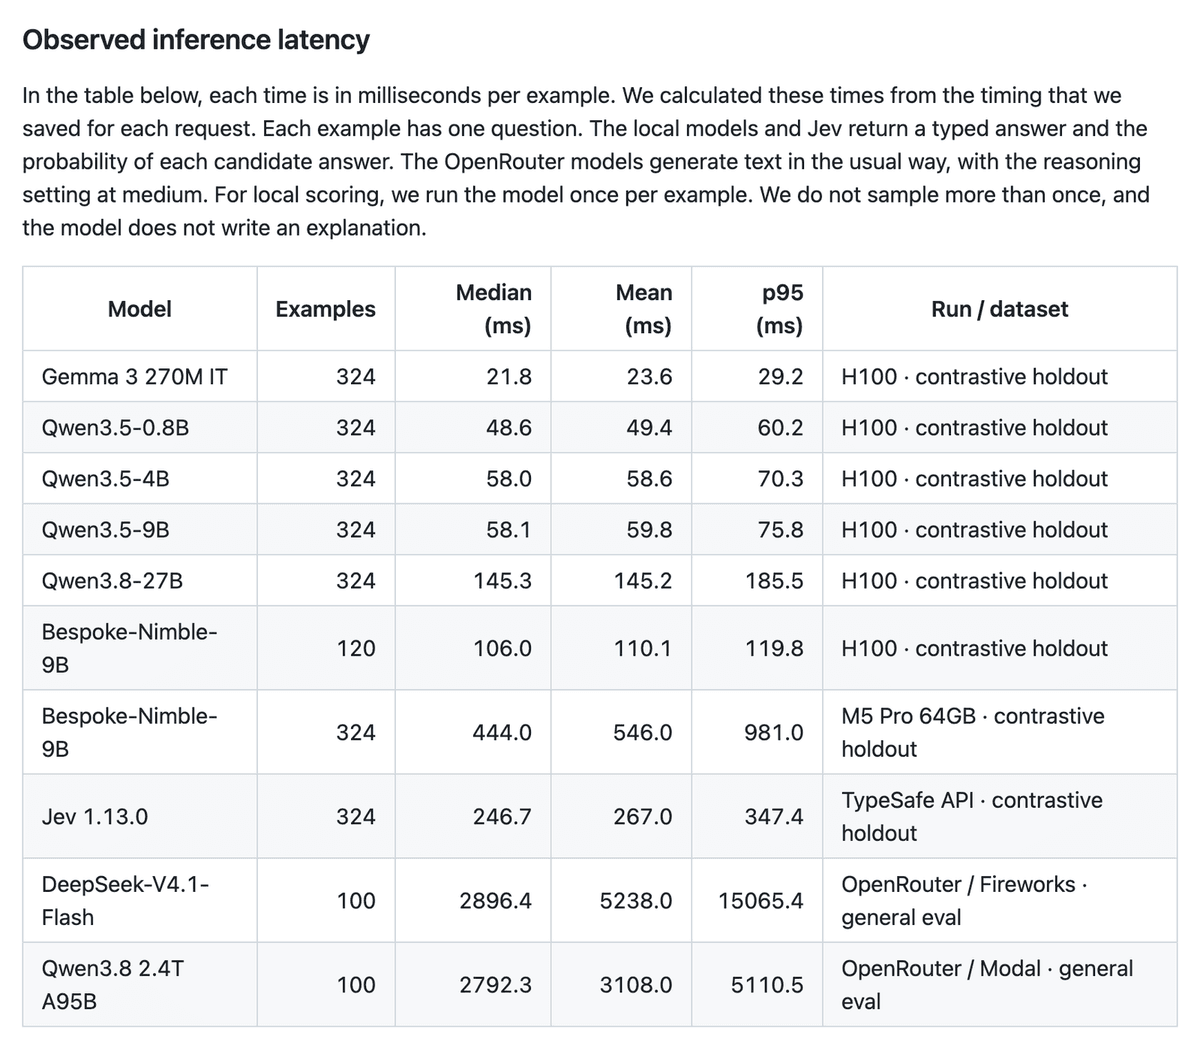
Localmente ele também é mais rápido do que a chamada que substitui, com a ressalva impressa na mesma tabela. Mediana de 106.0 ms por exemplo numa H100 contra 246.7 ms via API da TypeSafe. Num M5 Pro 64GB, o mesmo adaptador leva 444.0 ms de mediana, 546.0 de média, 981.0 em p95 — o que já é o fim da versão para laptop do discurso de vendas. Mais acima na mesma tabela, o Qwen3.5-9B base sem ajuste roda em 58.1 ms nos 324 exemplos, e o repositório não explica o que o adaptador acrescenta. A cifra rápida também não se apoia na mesma amostra de tudo com que é comparada.
Their recorded times are also not from a controlled serving test.
A parte da onda que mostrou o trabalho por trás
O Jev foi lançado fechado, e setembro se encheu de imitações — um resumo da AINews desta semana catalogou seis delas e arriscou palpites sobre as arquiteturas, porque chutar era tudo que dava para fazer. Quase todas publicaram um número de velocidade e um endpoint.
a lot of demos emphasized speed more than quality, and there is still no standard benchmark for this category.
O Nimble é a entrada que, em vez disso, entregou a etapa cara: como os dados de treino foram feitos. A Bespoke chama o método de curadoria de dados contrastiva. Você escreve dois exemplos que são quase idênticos.
They differ in one relevant fact, and this difference changes the correct answer.
O exemplo documentado é uma política de reembolso em que só Mira pode autorizar reembolsos numa conta; a versão pareada troca o nome na autorização assinada para Noah, e a resposta correta vira de verdadeiro para falso. Tudo o resto — a pergunta, a política, a redação — permanece igual. O pipeline garante isso com uma checagem mecânica de localidade: cada par proposto pode mudar uma frase e, no máximo, oito palavras separadas por espaço, medidas por um diff de tokens. Chamadas de modelo separadas então verificam os fatos em cada exemplo, e um teste de exclusão confirma que remover qualquer uma das frases de evidência deixa o fato central genuinamente desconhecido.
Isso produziu 2,676 exemplos em dez categorias temáticas, gerados com o GPT-5.6 Terra e verificados com o GPT-5.6 Sol, seguidos de uma única época de treino LoRA — 335 atualizações do otimizador com batch size efetivo de 8. O ajuste rodou em L40S; o treino final rodou em uma H100. Tudo isso se juntou na velocidade em que a semana estava correndo.
We built Nimble in one day, so expect some rough edges.
Onde ele perde é mais útil do que por quanto
O README encaminha para uma comparação externa: treze subconjuntos públicos, rotulados por humanos, fora das categorias de treino, com os dois modelos avaliados nos mesmos registros.
That is a gap of 1.2 macro points in Jev's favour across tasks that are all outside Nimble's training categories.
— Nimble public benchmarks guide
74.8% macro contra 76.0%. Essa diferença é a cifra que será citada, e é a linha menos informativa da página.
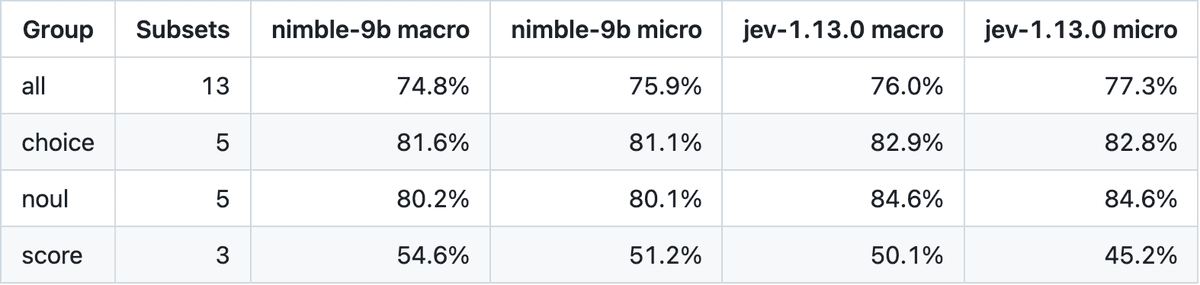
Dividido por grupo, o fine-tune perde em choice, 81.6 a 82.9, perde em noul, 80.2 a 84.6, e vence em score, 54.6 a 50.1, com os números micro ainda mais distantes, 51.2 contra 45.2. Lido como três resultados, isso diz que um modelo treinado em 2,676 exemplos autoproduzidos supera o fornecedor em avaliação de rubrica e fica atrás em classificação. A tabela de acurácia por subconjunto, impressa acima dessas médias, diz algo mais estreito e mais útil, porque traz um p-valor de McNemar em cada linha. A vitória em score tem apenas um dataset por trás: summeval-relevance, com 49.2 contra 35.0, p=0.0004, enquanto helpsteer2 fica 4.9 pontos de distância com p=0.3232, o que não é significativo, e o fine-tune perde no terceiro subconjunto de score, summeval-consistency, 75.7 a 81.2. Já o déficit de 1.3 pontos do grupo choice é a média de duas derrotas significativas — massive-de-DE com p=0.0169, vitaminc-dev com p=0.0125 — contra uma vitória que não é significativa. Então a versão honesta dessa divisão não é "vence em avaliação de rubrica": é que um único dataset de sumarização carrega a única vitória inequívoca, e as derrotas que sobrevivem a um teste de significância estão espalhadas pelos subconjuntos de classificação.
A divisão do mesmo conjunto de treino por tipo de tarefa, feita pelo README, sugere uma causa em vez de uma coincidência. Score é o maior bloco, com 932 exemplos, contra 888 de Noul e 856 de Choice. O modelo é mais forte, em relação ao fornecedor, justamente no tipo de tarefa que mais viu.
Uma linha merece ser destacada completamente das médias. paws é o oitavo dos treze subconjuntos: embaralhamento adversarial de palavras, em que duas frases compartilham a maior parte das palavras e significam coisas diferentes. Tipo noul, 250 registros. O fine-tune marca 82.8%, o Jev 89.2%, e a página marca a diferença como significativa em p=0.0025. Essa diferença de 6.4 pontos é maior do que qualquer uma das médias de grupo, e recai justamente sobre uma tarefa construída exatamente como os dados de treino: pares de frases minimamente diferentes que significam coisas diferentes. O PAWS é a própria ideia da curadoria contrastiva, escrita como teste adversarial por outras pessoas. A afirmação mais distintiva do método é a mais fraca justamente na tarefa para a qual o método existe.
Os autores são diretos sobre o limite de tudo isso.
We trained Bespoke-Nimble-9B on 2,676 examples that we curated. So it's performance will depend on this data and the domains it comes from.
(Os erros de digitação são deles mesmos, e mostram a construção de um dia.) O alcance de domínio é ainda mais estreito do que essa frase sugere, e o README imprime o motivo como uma tabela: uma contagem de treino e uma contagem de reservados para cada uma das dez categorias.
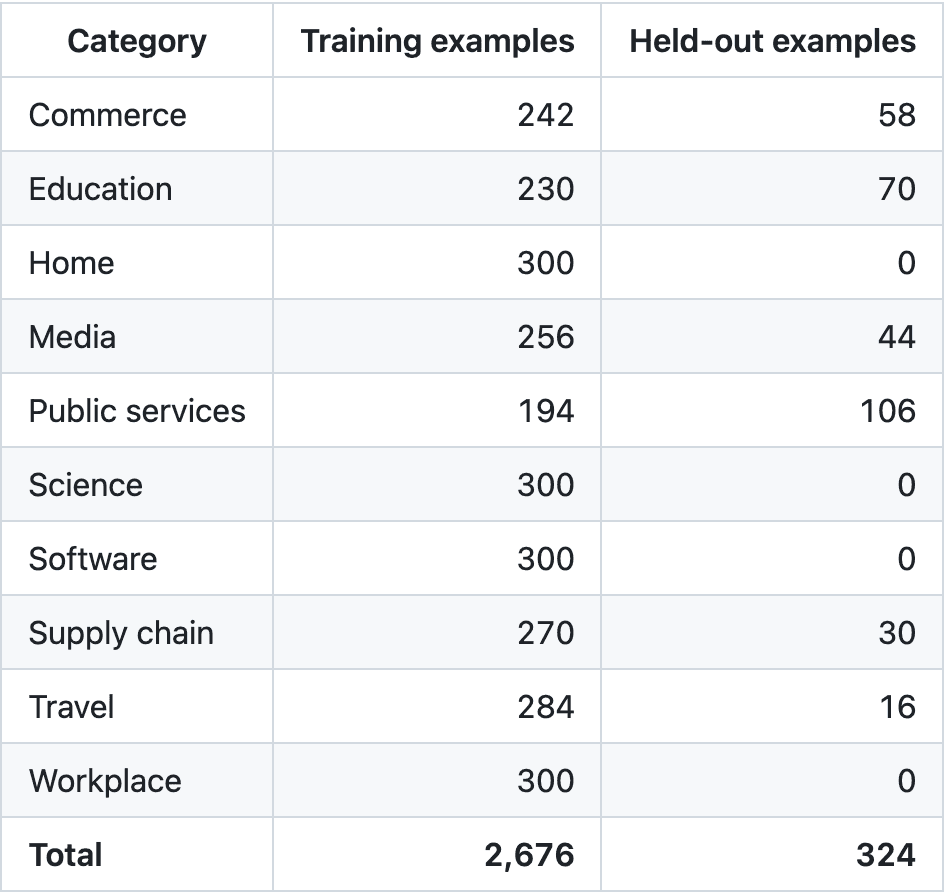
Quatro das dez contagens de reservados são zero: Home, Science, Software e Workplace, com 300 exemplos de treino cada. Toda a avaliação de 324 exemplos vem das outras seis — Public services 106, Education 70, Commerce 58, Media 44, Supply chain 30, Travel 16. Então os 90.12% são medidos sobre seis décimos da superfície em que o modelo foi treinado, e os quatro décimos não medidos são os quatro maiores blocos de treino do conjunto. Não é fraco: é não reportado.
Fora do projeto, a reclamação é sobre a própria origem dos rótulos.
Of course, not enough people are talking about the data side, which is acknowledged to be 100% synthetic.
"Reconhecido" é a palavra certa, e o reconhecimento é incomumente lúcido:
All of the labels are synthetic: a model checked them, and no person has reviewed them.
O README acrescenta o motivo pelo qual isso pesa: chamadas separadas ao mesmo modelo podem cometer o mesmo erro, então a verificação pode não pegar o que o gerador errou. Os dados de treino e os dados de avaliação foram produzidos pela mesma família de geradores, o que significa que um ponto cego compartilhado elevaria a pontuação e reduziria a acurácia ao mesmo tempo, e nada no repositório mostraria isso.
O conjunto reservado é pequeno de uma segunda maneira, que não tem nada a ver com categorias. Seus 324 exemplos são 162 pares intimamente relacionados, e o README conta de onde foram extraídos:
All of them come from only six source families, so this is a narrow test.
Se essas seis famílias são as mesmas seis categorias que o holdout cobre, o README não diz, e o guia de benchmarks usa "famílias" em outro sentido em outro lugar — uma contagem de documentos-fonte por trás de um subconjunto, como as 31 por trás dos 299 registros de squad2. De qualquer forma, a palavra dos autores para isso é a certa: estreito.
Duas críticas independentes afiam isso até virar algo que dá para testar. Um engenheiro que fez benchmark do Jev num arnês de agente encontrou o modo de falha que uma garantia de esquema não consegue capturar:
High confidence means the model is sure it applied your definition — including your mistakes
— Benchmarking Jev in an agent harness, DEV Community
Eles relatam roteamentos errados chegando com confiança 1.0. Fidelidade ao seu esquema não é correção, e um fine-tune herda suas definições de forma mais literal do que um modelo de fornecedor herdaria. Separadamente, um grupo da Johns Hopkins mediu o que uma comparação baseada só no rótulo esconde: em 588 resultados, todo rótulo final estava correto, enquanto 581 saídas posteriores estavam exatas.
the workflow can return the expected verdict while passing an incorrect quantity to subsequent analysis.
Concordância com um rótulo de referência é exatamente uma pontuação baseada só no rótulo. Os dois números de destaque do Nimble são desse tipo.
A última objeção volta ao paws, vinda de alguém com interesse direto na disputa. No rastreador de issues do projeto, um comentarista que assina como m0at coloca seus próprios discriminadores de borda de peso zero contra o Nimble-9B e o Jev, numa suíte reconstruída de 324 amostras de BoolQ, MultiNLI e PAWS, e relata que sua implementação chega a 100% com latência abaixo de um milissegundo. Trate uma comparação autoexecutada numa suíte autorreconstruída com o ceticismo que ela convida. A parte mecânica do argumento sobrevive a quem o está fazendo:
Base small models struggle significantly on PAWS (Gemma 3 at 41.2%, Qwen 3.5 at 45.4%)
— m0at, bespokelabsai/nimble issue #3
O motivo apontado é que a sobreposição de unigramas entre as duas frases fica acima de 85%, então um modelo que pesa palavras em vez da ordem delas quase não tem onde se apoiar. Essa é uma afirmação sobre a forma da tarefa, não sobre o produto de ninguém, e aponta para o mesmo subconjunto em que a própria suíte da Bespoke registra a derrota significativa do fine-tune.
Using n-gram order sensitivity (specifically trigram Jaccard divergence) reliably discriminates semantic flips without requiring generative rollouts.
— m0at, bespokelabsai/nimble issue #3
Se uma estatística de trigramas sem pesos consegue separar os casos em que um modelo de 9B ajustado erra, a pergunta interessante não é se vale a pena ser dono do modelo. É quais das suas decisões, afinal, precisavam de um modelo.
Onde um modelo como esse ganha o seu lugar
Um modelo de decisão tipada é um classificador, e classificadores são mais úteis como uma etapa de roteamento à frente de um trabalho mais lento: decidir primeiro, gastar depois. A questão do reembolso acima é o arquétipo — resolva "isto está autorizado" numa única chamada tipada, e deixe que o ramo que lê documentos, grava num razão contábil ou aciona um humano rode só quando a resposta mandar.
Os números do Nimble mudam o formato da decisão entre construir ou comprar, em vez de resolvê-la. Se o seu tráfego se parece com uma das seis categorias que o holdout cobre, você tem uma cifra publicada para se basear. Se ele se parece com Home, Science, Software ou Workplace, ninguém publicou uma cifra — nem mesmo quem treinou nessas categorias — e o seu primeiro trabalho é montar um conjunto reservado próprio, rotulado por alguém que vai levar a culpa se estiver errado. O método de curadoria se transfere sem atrito. Os rótulos não se transferem em nada.
Seja qual for o modelo que acaba tomando a decisão, o workflow ao redor dele é o mesmo, e vale a pena construí-lo de forma que o caminho barato continue barato. Na Latenode isso é simples de precificar, porque o medidor conta os segundos de CPU que uma execução realmente consome, em vez de nós ou chamadas de API, e não há mínimo por execução — então uma execução que classifica, segue o ramo curto e sai custa proporcionalmente menos do que uma que dá a volta longa. Um nó de JavaScript pode instalar qualquer biblioteca do NPM, o que mantém o trabalho ao redor de uma decisão — parsing, validação, o próprio ramo — como código comum, e não configuração. O plano gratuito oferece 10,000 segundos de CPU por mês em até 5 workflows ativos. Até onde isso vai depende do seu tráfego, não do medidor.
Quem deveria clonar isto, e quem não deveria
Clone se você tem uma superfície de decisão estreita e estável, e estômago para rotular dados: o ativo transferível aqui é o pipeline de curadoria, não os pesos, e a escala em que ele funcionou foi 2,676 exemplos em dez categorias e uma única época de 335 atualizações do otimizador. Quanto isso custou em horas, o repositório não diz. Clone se a sua tarefa se parece especificamente com avaliar relevância de resumos, porque é ali que está a única vitória inequívoca — summeval-relevance, 49.2 contra 35.0, p=0.0004 — e é um único dataset, não uma categoria: os outros dois subconjuntos de score são um empate estatístico e uma derrota. Clone se você quer ver como é um modelo de decisão com a etapa de dados visível, porque quase mais nada nessa onda mostra isso.
Passe longe se você está procurando um substituto plug-and-play para o Jev. Ele fica três pontos atrás nos domínios para os quais foi construído, 6.4 pontos atrás com p=0.0025 em paws, o subconjunto de paráfrase adversarial construído do mesmo jeito que os próprios dados de treino — e os autores dizem claramente para não esperar generalização. Passe longe se o destino do deployment é um laptop: 444 ms de mediana e 981 ms em p95 é um produto diferente de 106 ms numa H100, e a cifra da H100 foi medida em 120 exemplos, enquanto tudo com que ela é comparada foi medido em 324. E passe longe se você não tem dados rotulados próprios, porque o que produziu 90.12% foram 2,676 exemplos curados, não um rank de LoRA.
O número que vale a pena acompanhar não é a diferença de três pontos. É se alguém vai rodar essa receita sobre dados que um humano de fato leu, e relatar o que muda.
Era assim que as coisas estavam em 22 de setembro de 2026. Projetos mudam rápido — confira a fonte antes de confiar nisso.
Perguntas frequentes
- Sob qual licença o Nimble é distribuído, e o que eu de fato baixo?
Apache 2.0. O lançamento é um adaptador LoRA de aproximadamente 165 MiB, além do tokenizador, do construtor de prompts e do código de referência para inferência. Não é um modelo autônomo: você mesmo fornece o Qwen3.5-9B, que soma mais 18 GB ou mais, e ou funde o adaptador ao modelo base ou o carrega junto dele.
- Que hardware e configurações a execução publicada usa?
Uma GPU NVIDIA com suporte a BF16; o repositório relata testes em PyTorch 2.8.0 com CUDA 12.8. A Bespoke ajustou o modelo em L40S e rodou o treino final e a avaliação em uma H100. A configuração publicada é LoRA em rank 16, taxa de aprendizado 5e-5, batch size 2 com acumulação de gradiente 4, limite de prompt de 2,048 tokens e seed 17; o guia de treinamento define o máximo de passos em 1,005, com 101 passos de warmup.
- Dá para rodar a inferência em Apple Silicon?
Sim. O repositório lista o Apple Silicon via MLX como alternativa ao caminho CUDA, e a avaliação publicada inclui uma execução completa de 324 exemplos em um M5 Pro 64GB. A restrição prática é a memória para o modelo base, não para o adaptador, que é pequeno o suficiente para ser um detalhe secundário.
- Dá para apontar o pipeline de curadoria para um modelo gerador diferente?
Sim. Os padrões ficam no módulo de perfis de curadoria, e são definidos por etapa, não globalmente: a geração dos contrastes de treino e a geração da avaliação usam modelos diferentes por padrão, com raciocínio baixo e médio, respectivamente. Mudar qualquer um dos dois significa editar esse módulo, e nada no repositório relata o que acontece com os números publicados quando você faz isso — então a troca torna os resultados seus, para você remedir.
- Um modelo maior e sem ajuste faria o mesmo trabalho?
Não neste teste. Nos mesmos 324 exemplos, o Qwen3.8-27B sem ajuste — três vezes o número de parâmetros — atinge 84.88%, ou seja, 5.25 pontos abaixo do fine-tune de 9B, e a escada despenca rapidamente abaixo dele: Qwen3.5-4B com 61.42%, Qwen3.5-0.8B com 45.37%, Gemma 3 270M IT com 28.70%. Nos domínios para os quais foi treinado, 2,676 exemplos curados rendem mais do que triplicar os pesos — o que é um argumento a favor da receita, e só a favor desses domínios.
- O modelo explica suas respostas?
Não, e isso é deliberado. A pontuação local roda o modelo uma vez por exemplo, sem amostragem repetida e sem justificativa escrita. O que volta é uma resposta tipada mais uma probabilidade para cada candidato, o que o torna barato o bastante para ficar num caminho quente, e também o que não deixa nada para você ler quando ele erra.