
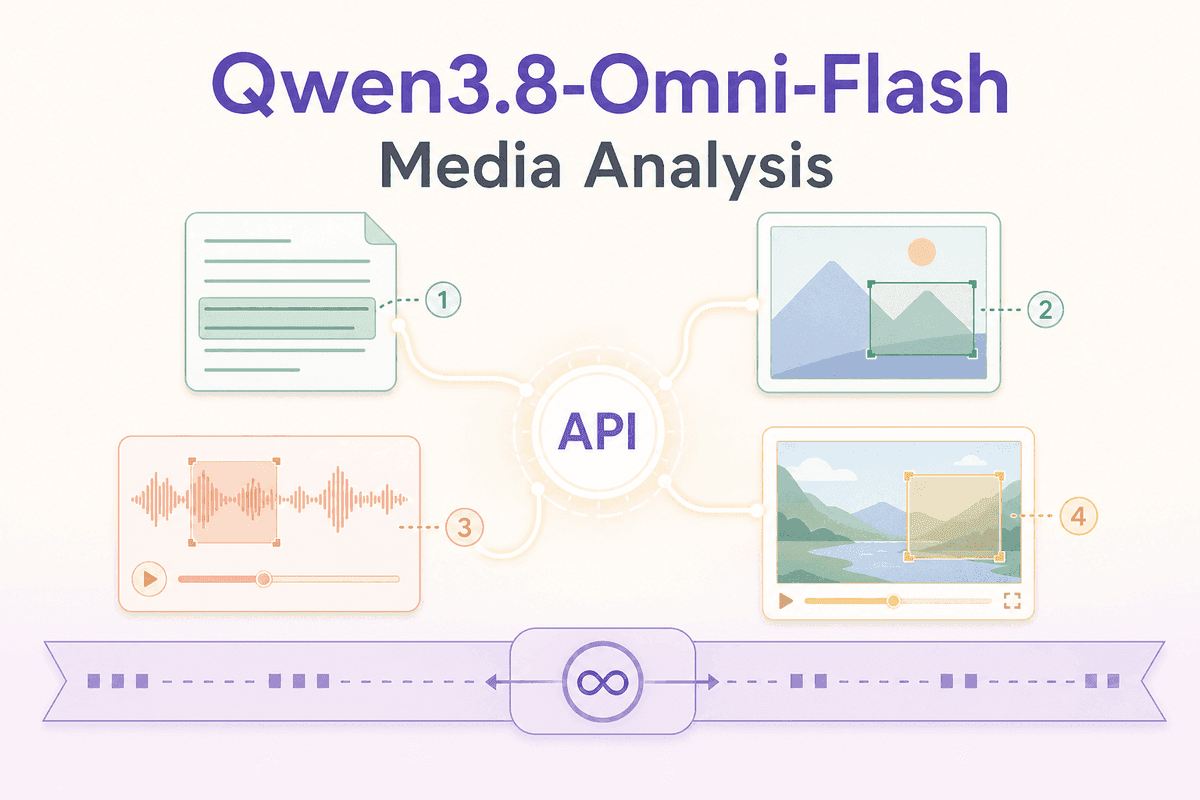
A Alibaba Cloud publicou seu anúncio do Qwen3.8-Omni-Flash em 20 de setembro, apresentando um modelo multimodal que recebe texto, imagens, áudio e vídeo com uma janela de contexto de 1M de tokens. A empresa o posiciona para gravações longas e fluxos no estilo de agentes, não apenas para chat.
Para quem cria automações, a principal atualização é a consolidação de APIs: a Alibaba afirma que o modelo está disponível na Qianwen AI Platform, oferece suporte às APIs Chat Completions e Responses compatíveis com OpenAI e pode ser orientado com ferramentas e esforço de raciocínio ajustável. A Alibaba também apresenta sua abordagem para vídeos longos como uma extração de evidências de segmentos relevantes, em vez de processar toda a mídia de forma uniforme.
As ressalvas importam. As reduções de custo destacadas pela Alibaba são comparações com seu próprio Qwen3.5-Omni-Plus anterior, e não com modelos concorrentes, e o material observa que os preços de mídia por região ainda precisam ser validados. O endpoint base também retorna saída em texto, então equipes que precisam de respostas faladas podem ainda precisar de uma camada de TTS ou de tempo real, como observa a cobertura independente.