
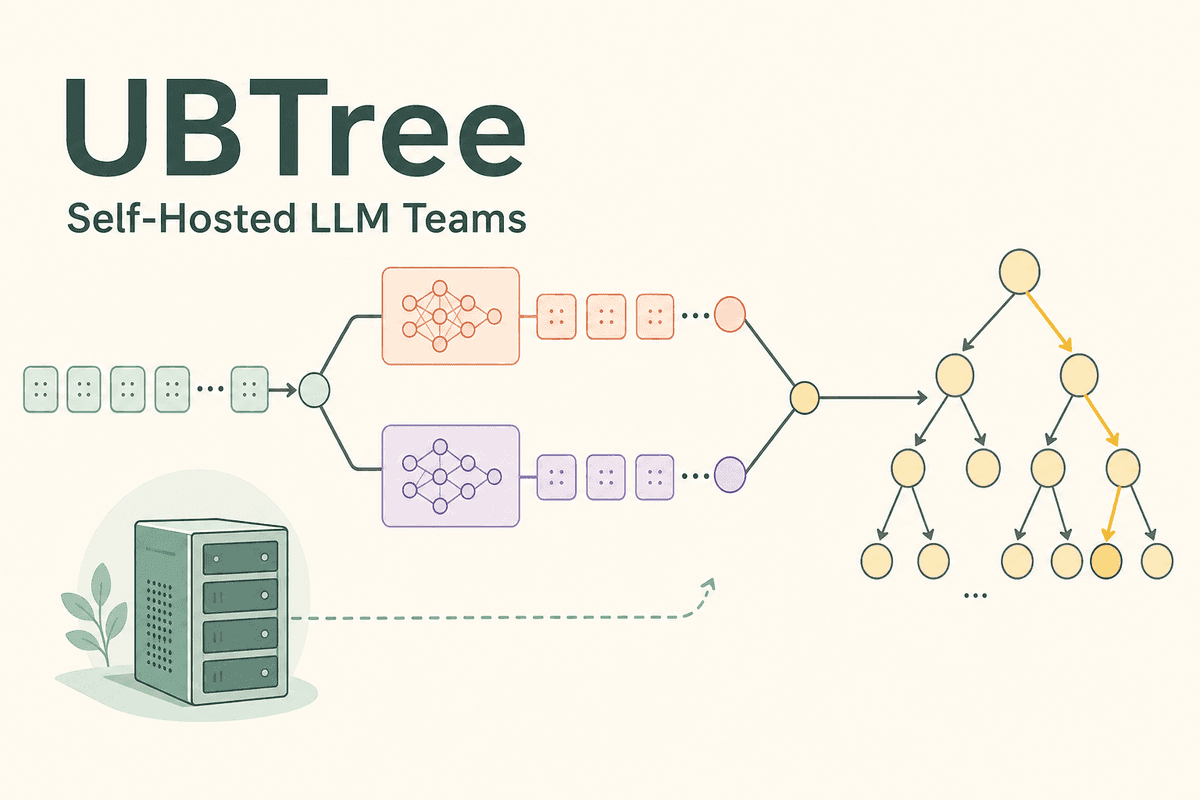
Em 28 de outubro de 2026, a Inclusion AI apresentou o UBTree, um método de decodificação especulativa para inferência de LLM que cria uma árvore de verificação, em vez de depender de um único caminho de rascunho. A Inclusion AI afirma que o UBTree combina um proponente de unigrama com um seletor de bigrama.
A configuração mantém o trabalho neural em duas passagens diretas paralelas, com a busca na árvore realizada depois sobre pontuações pré-calculadas, sem uma passagem neural adicional. Segundo a Inclusion AI, isso foi projetado para resolver dois problemas de geradores de árvores paralelas anteriores: o equilíbrio entre dependências de tokens e paralelismo, além de uma divergência entre treinamento e inferência.
A Inclusion AI relata ganhos médios de velocidade de 5,84× a 6,94× com Qwen3-4B e Qwen3-8B, além de 5,36× com Ling3-Flash 124B no SGLang. A empresa também lançou checkpoints de rascunho do UBTree para Ling-3.0-flash e Ling-3.0-tiny.
A disponibilidade ainda está em estágio inicial: o suporte ao SGLang atualmente está em uma branch separada, enquanto a integração ao upstream segue em andamento. Para equipes que servem modelos auto-hospedados, o UBTree parece um caminho concreto de decodificação para avaliar em benchmarks, especialmente em cargas de trabalho com contexto longo ou menor concorrência.