
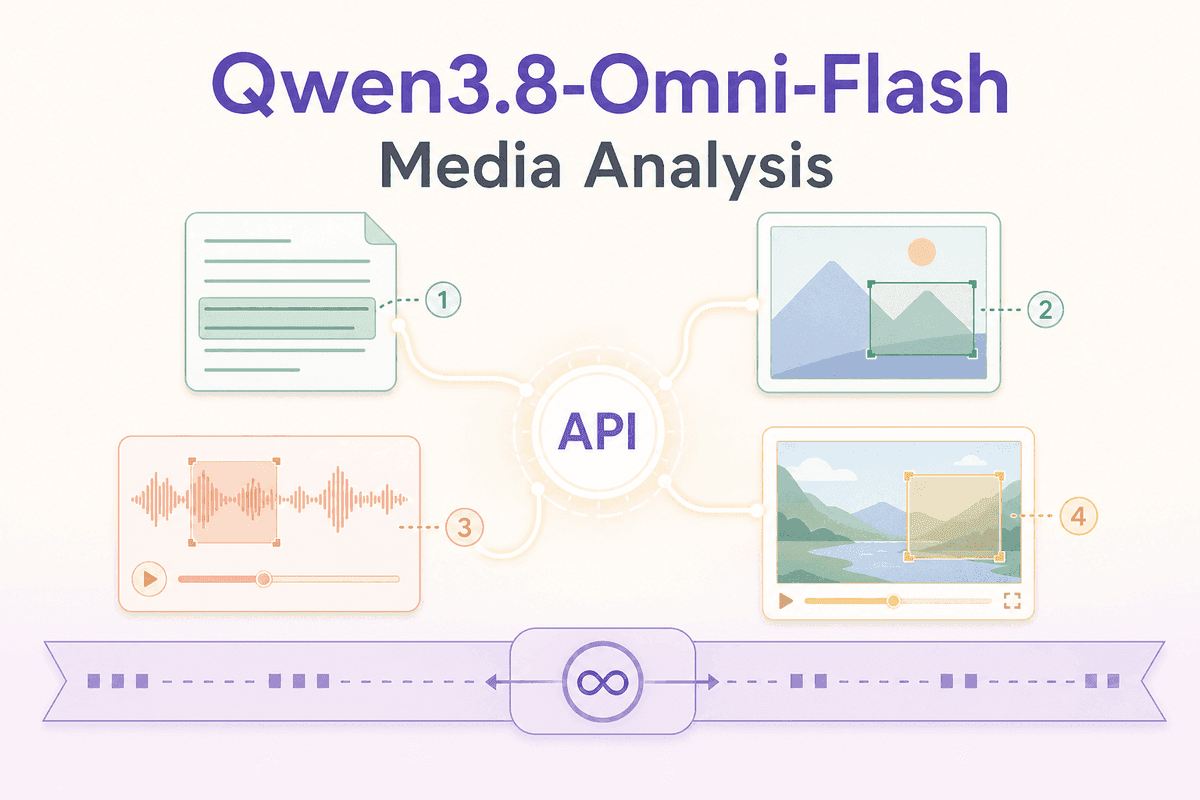
Alibaba Cloud veröffentlichte am 20. September seine Ankündigung zu Qwen3.8-Omni-Flash und stellte ein multimodales Modell vor, das Text, Bilder, Audio und Video mit einem Kontextfenster von 1M Tokens verarbeitet. Das Unternehmen positioniert es für lange Aufnahmen und agentenbasierte Workflows, nicht nur für Chats.
Für Builder ist die API-Konsolidierung die wichtigste Neuerung: Laut Alibaba ist das Modell auf der Qianwen AI Platform verfügbar, unterstützt OpenAI-kompatible Chat-Completions- und Responses-APIs und kann mit Tools sowie anpassbarem Denkaufwand gesteuert werden. Alibaba beschreibt seinen Ansatz für lange Videos zudem so, dass Belege aus relevanten Segmenten abgerufen werden, statt alle Medien einheitlich zu verarbeiten.
Die Einschränkungen sind relevant. Alibabas hervorgehobene Kostensenkungen vergleichen das Modell mit dem eigenen früheren Qwen3.5-Omni-Plus, nicht mit Konkurrenzmodellen, und die Unterlagen weisen darauf hin, dass regionale Medienpreise noch validiert werden müssen. Der Basis-Endpunkt gibt außerdem Text aus. Teams, die gesprochene Antworten benötigen, brauchen daher möglicherweise weiterhin eine TTS- oder Echtzeit-Schicht, wie unabhängige Berichterstattung festhält.