
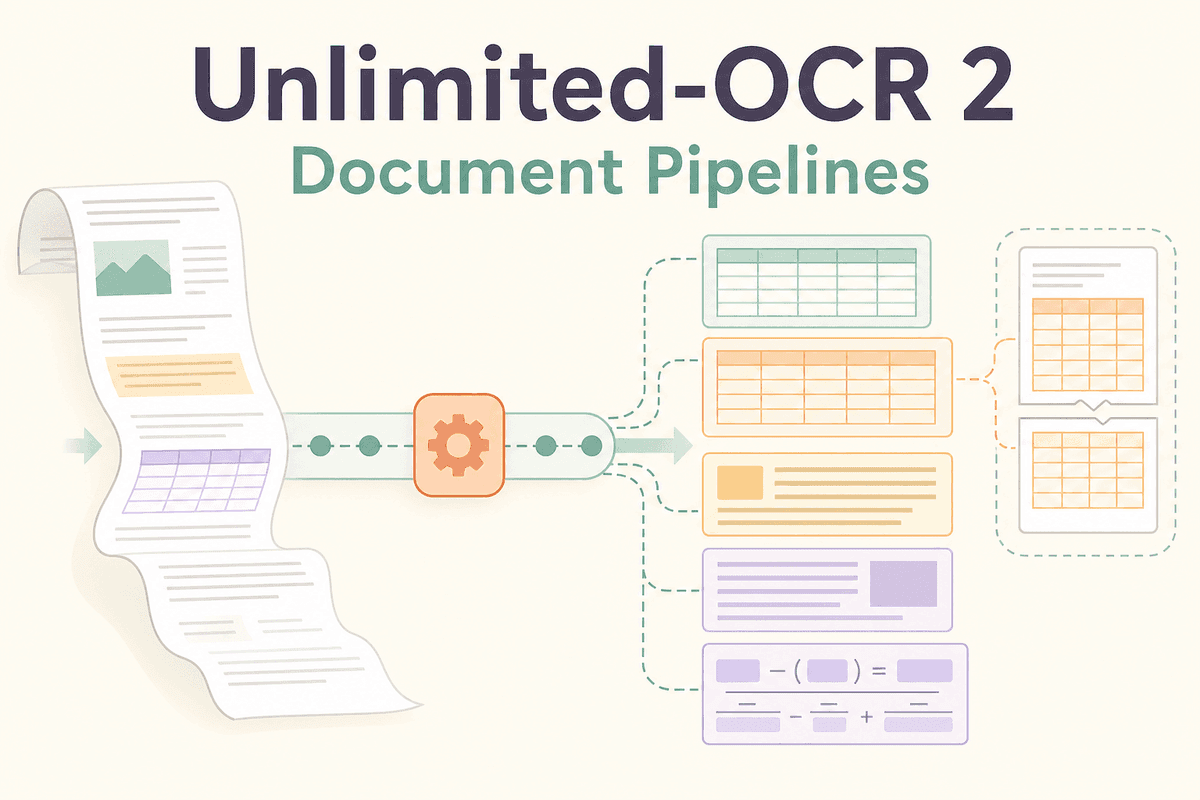
Am 27. Oktober 2026 hat Baidu seinen Cloud-Dokumentparser aktualisiert und nutzt nun Unlimited-OCR 2. Damit steht das Modell für lange Dokumente als gehostete OCR-API bereit, statt dass Teams es selbst bereitstellen müssen.
Laut der Baidu Cloud OCR-Dokumentation unterstützt der Dienst PDFs mit bis zu 500 Seiten und kann die analysierten Ergebnisse als strukturiertes JSON oder Markdown zurückgeben. Baidu zufolge ist er für strukturintensive Dateien ausgelegt, einschließlich tabellenübergreifender Zusammenführung, seitenübergreifender Absatzfortsetzung, Analyse der Titelhierarchie und Layout-Kennzeichnung für Elemente wie Tabellen und Gleichungen.
Die API verwendet einen asynchronen Ablauf statt einer einzelnen blockierenden Anfrage. Ein Client übermittelt eine Datei oder URL, erhält eine Aufgaben-ID und fragt dann den Abschluss ab, bevor er Ergebnislinks abruft. Das lässt sich einfacher in Automatisierungs-Workflows einfügen, die Datenaufnahme bereits von nachgelagerter Extraktion oder Prüfung trennen.
Auf Modellseite nutzt Unlimited-OCR 2 laut Baidu SR-SWA, um Dekodierungslatenz und Speicherbedarf bei zunehmender Dokumentlänge nahezu konstant zu halten; weitere Details finden Sie auf der Modellseite. Für Builder ist die praktische Änderung der Zugang: Die Verarbeitung langer PDFs ist nun über die verwaltete API von Baidu Cloud verfügbar.