
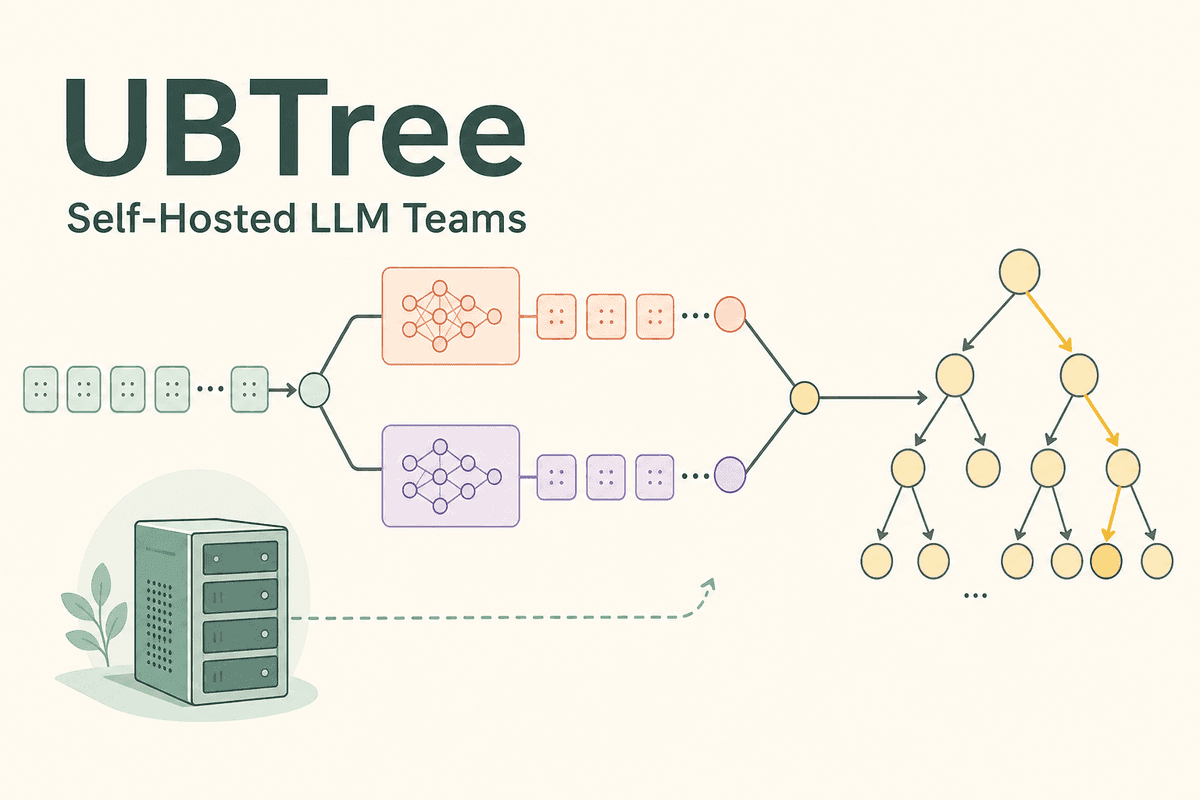
Am 28. Oktober 2026 stellte Inclusion AI UBTree vor, eine spekulative Decodierungsmethode für die LLM-Inferenz, die einen Verifikationsbaum aufbaut, statt sich auf einen einzelnen Draft-Pfad zu verlassen. Laut Inclusion AI kombiniert UBTree einen Unigramm-Vorschläger mit einem Bigramm-Selektor.
Das Setup hält die neuronale Verarbeitung in zwei parallelen Forward-Passes, während die Baumsuche anschließend auf vorab berechneten Scores statt in einem zusätzlichen neuronalen Pass erfolgt. Inclusion AI zufolge soll dies zwei Probleme früherer paralleler Baumverfahren lösen: den Zielkonflikt zwischen Token-Abhängigkeiten und Parallelität sowie eine Diskrepanz zwischen Training und Inferenz.
Inclusion AI berichtet von durchschnittlichen Beschleunigungen von 5,84× bis 6,94× bei Qwen3-4B und Qwen3-8B sowie von 5,36× bei Ling3-Flash 124B in SGLang. Das Unternehmen veröffentlichte außerdem UBTree-Draft-Checkpoints für Ling-3.0-flash und Ling-3.0-tiny.
Die Verfügbarkeit ist noch etwas früh: Die SGLang-Unterstützung liegt derzeit in einem separaten Branch, während die Upstream-Integration noch läuft. Für Teams, die selbst gehostete Modelle bereitstellen, ist UBTree ein konkreter Decodierungsansatz für Benchmarks – insbesondere bei Workloads mit langem Kontext oder geringerer Parallelität.