
DFlash 2: un drafter de 3.43× que cae a 1.45× bajo carga
Publicado el 22 de septiembre de 2026
Un drafter que adivina el bloque entero de una vez
La decodificación especulativa tiene la misma forma en todas partes: un modelo pequeño propone tokens, el modelo grande los comprueba en una sola pasada, y te quedas con lo que sobrevivió. El paso de propuesta se ha mantenido autoregresivo: un token, y luego el siguiente. DFlash 2 lo convierte en una sola pasada:
the entire block, every position, predicted in parallel.
— Inco AI
Un selector ligero traza después una ruta coherente entre los candidatos que se mantuvieron en cada posición, y unas convoluciones dinámicas de dos taps evitan que el borrador se degrade hacia el final del bloque. El proveedor tasa todo el arreglo en más de un 20% de salida adicional por paso de verificación a cambio de alrededor de un 1% más de latencia por ciclo. Las convoluciones son la parte barata de eso: añaden un 0.7% al ciclo de borrador-verificación, mientras que las diez capas Transformer adicionales que comprarían una precisión comparable añadirían un 15.2%.
Nada de esto debería cambiar lo que dice el modelo:
Decoding is lossless: greedy output matches the target model exactly, and sampling preserves its distribution.
Así que el argumento de venta es limpio. Mismo texto, menos segundos. La pregunta es cuántos segundos menos, y bajo qué carga.
Cinco semanas de antigüedad, y solo ahora vale la pena discutirlo
Nada de esto se lanzó esta semana. Inco AI publicó dos drafters DFlash 2 el 18 de agosto, uno para Qwen3.8-27B y otro para Muse Glimmer, y el número con el que abrió era un número de una sola solicitud:
SGLang serves at 2.7–3.4× the throughput of autoregressive decoding at batch size 1
— Inco AI
El drafter entró en nuestro feed el 17 de septiembre, lo cual es un dato sobre el feed y no sobre el proyecto. Lo que ha cambiado es el intervalo. La implementación en vLLM del método se fusionó el 21 de agosto; la guía rápida de la ficha del modelo todavía indica instalar desde ese pull request, el #52816, lo cual fecha la ficha más que el ecosistema. Y un drafter entrenado para Qwen3.8-27B no se podía someter a pruebas de carga antes de que existiera, así que cualquier medición bajo carga que exista, incluida la reproducción en concurrencia 8 más adelante, es posterior al lanzamiento.
Hay algo que el proveedor hizo en el lanzamiento que merece mencionarse. Publicó él mismo las tablas de concurrencia 8 y concurrencia 32, en la ficha del modelo, justo debajo del titular. La mayoría de los proveedores no lo habría hecho. Por eso el desacuerdo trata de cómo leer las cifras, no de si las cifras existen.
El desacuerdo empieza en las propias tablas del proveedor
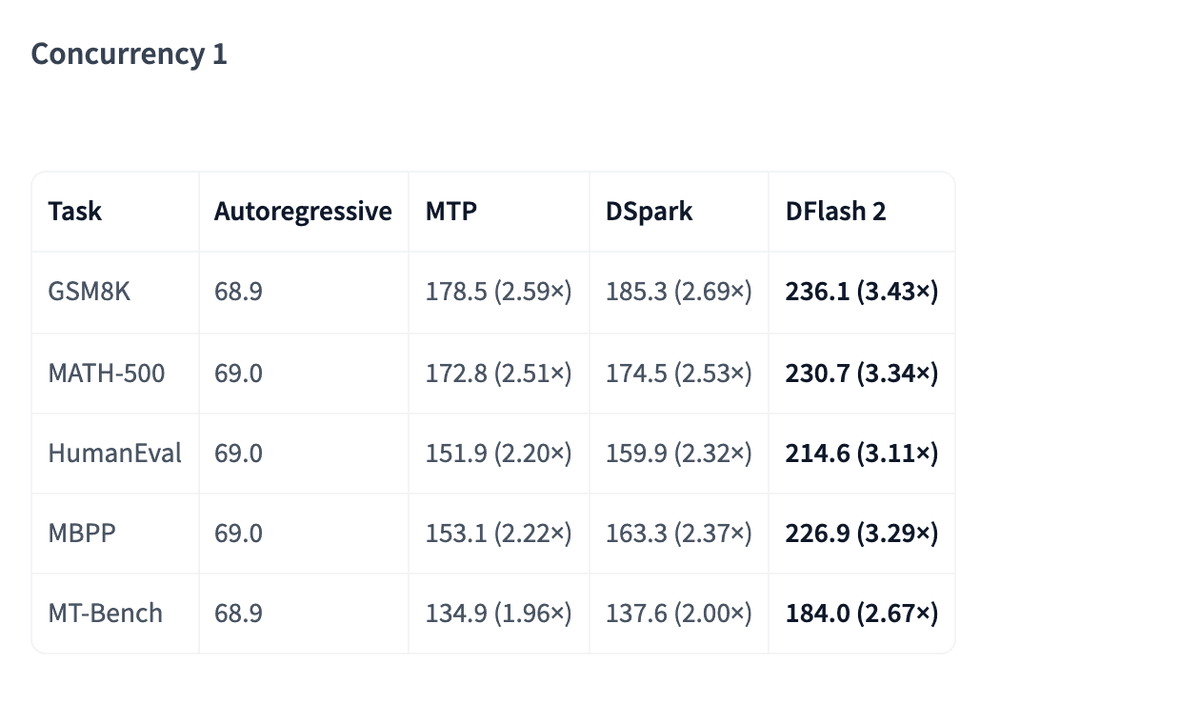
Cada cifra de la ficha del modelo proviene de una sola configuración: SGLang en una única NVIDIA H200, FlashAttention 3 tanto para la atención del objetivo como para la del borrador, tamaño de bloque de especulación 8. Bajo esas condiciones, la curva de GSM8K marca 3.43× en concurrencia 1, 2.84× en concurrencia 8 y 1.45× en concurrencia 32.
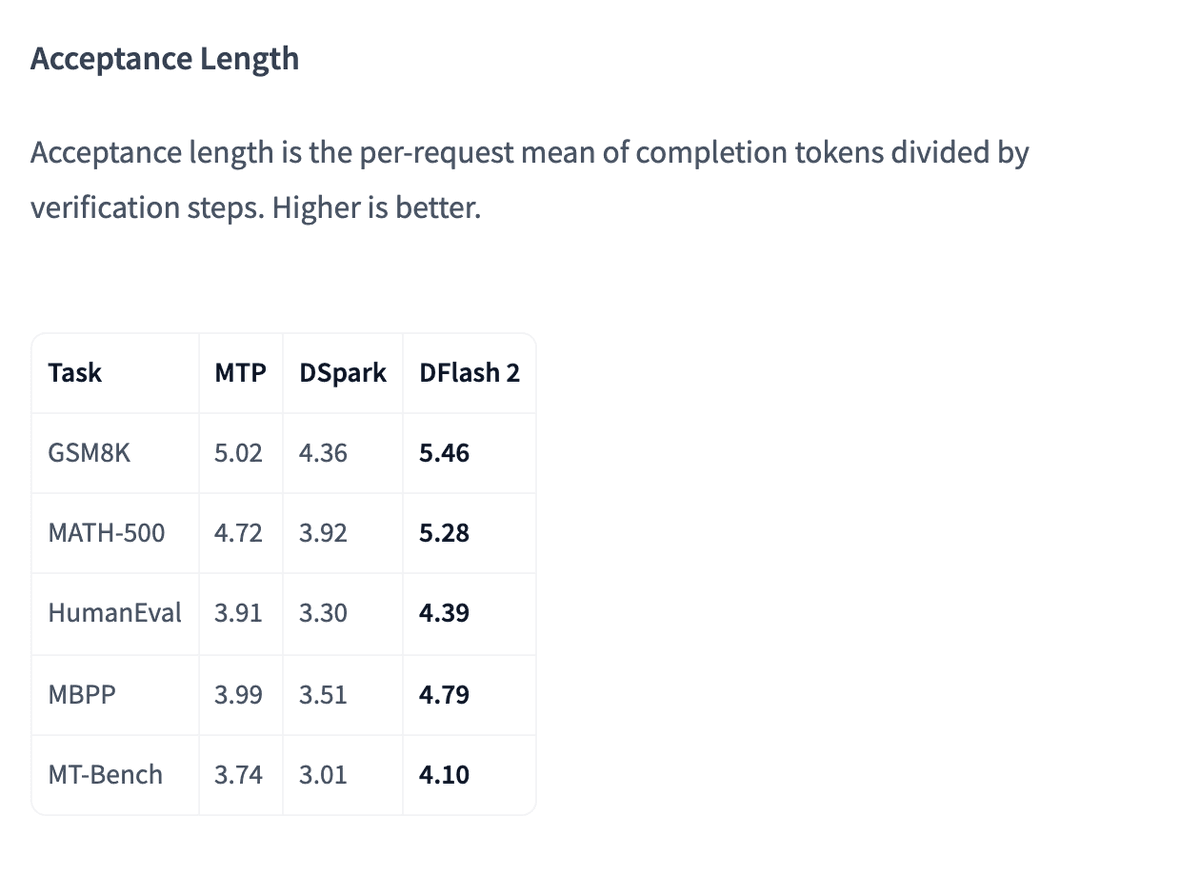
El tipo de tarea mueve el resultado casi tanto como la carga, y la razón está en la tabla al principio de esta página. La longitud de aceptación —tokens completados dividido entre pasos de verificación— llega a 5.46 en GSM8K y 4.10 en MT-Bench. En el chat abierto sobreviven menos tokens de borrador por cada paso de verificación, así que hay menos que ganar; MT-Bench termina en 1.01× mientras GSM8K se mantiene en 1.45×.
La caída a lo largo de la carga tiene una causa distinta, y no es un fallo. Producir un token mueve mucho más datos de pesos que aritmética, así que los multiplicadores de una GPU están mayoritariamente ociosos mientras eso ocurre. La especulación es una forma de aprovechar esa capacidad ociosa. El batching es otra, y solo hay una cuenta compartida.
The batch and the draft are drawing on the same account.
Esa medición se tomó en AMD RDNA4, no en una H200, y la aritmética es específica de esa plataforma: capacidad de borrador por agente de (24 − batch_size) / batch_size, que son unos 23 tokens de especulación para un solo agente y unos 2 cada uno cuando hay ocho corriendo. Silicio distinto, misma forma; y es la forma que trazan las propias tablas de la ficha del modelo.
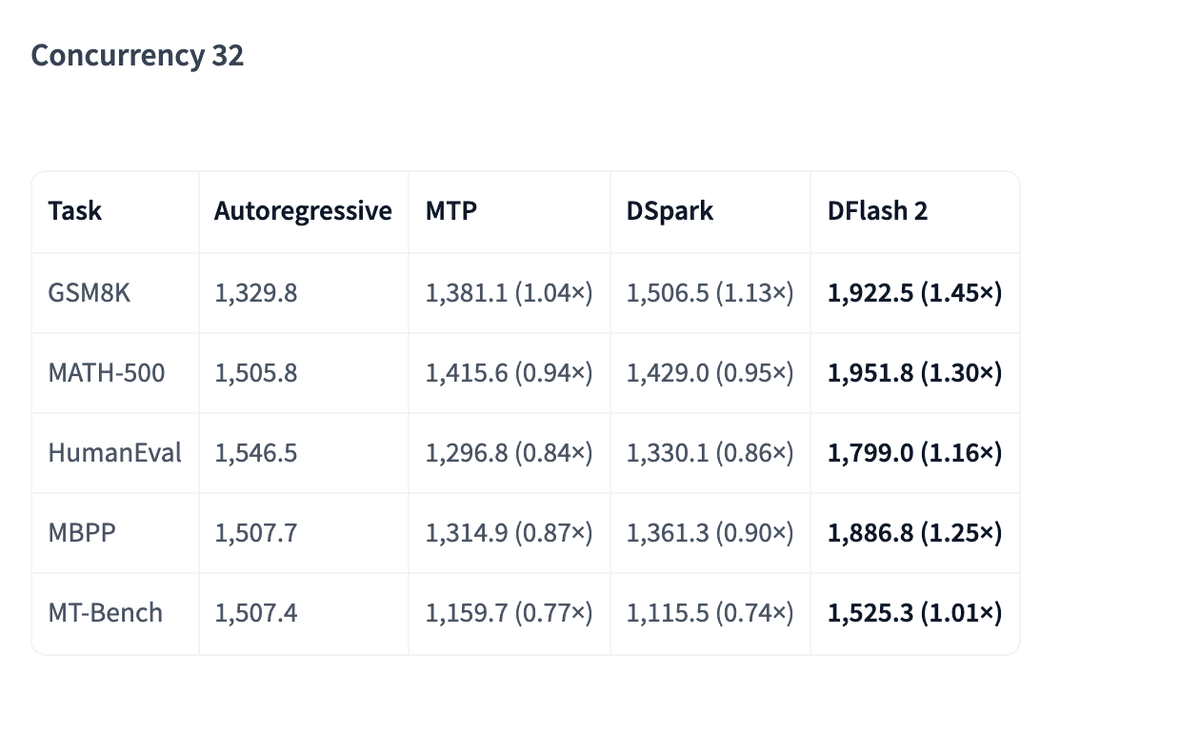
Fíjate en lo que les pasa a los vecinos en ese cuadro. En concurrencia 32, MTP y DSpark quedan por debajo de 1.00× en MATH-500, HumanEval, MBPP y MT-Bench. Ahí la especulación no solo deja de ayudar; resta throughput. DFlash 2 se mantiene a flote en las cinco tareas, lo cual es un resultado real; simplemente no es el resultado que cita todo el mundo.
El modo de fallo que esto produce en la práctica es un fallo de planificación, no técnico:
sees 2.5x speedup, ships it — then observes 5% regressions in production where p50 concurrency is 16
— Tian Pan
Es decir: se mide una aceleración de 2.5x, se pone en producción, y luego se observan regresiones del 5% con una concurrencia p50 de 16 — la carga que el equipo debería haber usado para medir desde el principio.
Segundo coste, y este sí es un problema de corrección, no de rendimiento. Al ejecutar la configuración de manual para DFlash 2 con Qwen3.8-27B en SGLang:
under high concurrent load, sometimes the last user message is appended to the wrong context
L3tum lo reportó en una RTX Pro 6000. Lo que hace difícil descartar el reporte es que una segunda persona lo reprodujo en hardware distinto y luego lo midió: gabrielbryk, en una DGX Spark contra un objetivo NVFP4, registró 7 respuestas erróneas en 100 solicitudes en concurrencia 8, frente a 0 en 100 ejecutando la misma configuración de forma serial y 0 en 304 con la especulación desactivada. Al ampliar los casos afectados a una muestra mayor, la tasa de fallo dentro de ese subconjunto quedó en 111 de 304 — la cifra que la gente cita, y no la tasa que vería tu propio tráfico. Dentro de ese conjunto ampliado, cambiar el objetivo a un lm_head denso en BF16 redujo los 111 fallos a 1, pero no los eliminó, lo cual sugiere que la deriva está en la ruta de verificación bajo composición de lotes y no en un artefacto de cuantización. No son caídas del sistema. Son respuestas bien formadas que repiten correctamente las restricciones y luego responden a una pregunta distinta. Volver a MTP hizo que se detuvieran. No hay ninguna corrección publicada.
Tercero, la memoria. La ficha del modelo indica 2B de parámetros en BF16 para el drafter y nunca lo convierte a gigabytes ni a una proporción del pool de la H200.
Spec decode isn't free. You're paying VRAM for both models simultaneously.
Ese artículo trataba sobre un modelo de borrador de 4B, no sobre DFlash 2, y lo que se puede trasladar es la contabilidad, no las cifras: ambos modelos residen en memoria a la vez, la pila de servicio preasigna más de lo que uno estima, y las dos soluciones disponibles son reducir el modelo de borrador o recortar el paralelismo. Bajar a un drafter de 0.6B recuperó allí unos 2 GiB. Ambos movimientos reducen la aceleración que estabas comprando.
En defensa del proveedor: publicó la caída, publicó una definición de longitud de aceptación contra la que se pueden comprobar sus tablas, y fue transparente sobre cómo se construyó la comparación.
We trained the DFlash and DSpark drafters ourselves under matched setups, while MTP ships with the model.
— Inco AI
Léelo dos veces. Es a la vez una declaración de buenas prácticas y una advertencia: dos de las tres bases con las que DFlash 2 se compara son reimplementaciones propias del proveedor.
Dónde vuelve a aparecer la pregunta de la concurrencia
La mayoría de quienes lean esto nunca tendrán la GPU en la que corre el drafter. Lo que sí tienen es la orquestación que hay delante, y para ellos toda la pregunta se reduce a un solo número: el tiempo de reloj en sus propios prompts y a su propia concurrencia. Eso es algo que se puede construir en una tarde. Toma los veinte o treinta prompts que tu producto realmente envía, ponlos en un workflow de Latenode que llame a dos endpoints de un catálogo de unos 335 modelos, y deja que un nodo de JavaScript —que puede instalar cualquier librería de NPM— cronometre cada llamada y registre el par. Después deja de ejecutarlo de uno en uno. Lanza el workflow en paralelo para reproducir la carga que atiendes: un plan de pago incluye 5 workers de ejecución en paralelo, y hay más disponibles como complemento a 10 $ por worker al mes, de modo que la concurrencia de tu prueba es un número que elegiste tú y puedes citar junto al resultado, exactamente lo que hacen las tablas del proveedor y lo que la mayoría de los benchmarks internos no hacen. El medidor coopera con el experimento: Latenode cobra por los segundos de CPU que consume realmente una ejecución, no por nodo ni por llamada a la API, y sin mínimo por ejecución, así que un barrido de unos cientos de ejecuciones cortas cuesta los segundos que tarda y no una tarifa plana por ejecución. No hay integración de DFlash 2 ni de SGLang en Latenode y este artículo no afirma que la haya; la velocidad de decodificación sigue siendo problema del proveedor. Lo que se puede trasladar es la medición, tomada bajo tu propia carga y no bajo la del benchmark.
Quién debería gastar la tarde en esto
Ejecútalo si tu carga de trabajo realmente se parece al benchmark: generaciones largas, pocas solicitudes en curso, una tarjeta de clase H200, un objetivo de la familia Qwen3.8, y SGLang o un vLLM lo bastante reciente como para incluir la fusión de agosto. Procesamiento de documentos por lotes durante la noche, un asistente de código para un solo desarrollador, un agente interno al que nadie más pone en cola detrás. En ese régimen las longitudes de aceptación son las mejores de los tres drafters en todas las tareas medidas, y el 3.43× es real.
No lo ejecutes en un nivel de servicio compartido este trimestre. Dos razones, y la segunda es la que descalifica. El caso del throughput se adelgaza justo donde vive la producción:
Above that, the gains from speculation are consumed by verification overhead at scale.
— Tian Pan
Y que siete solicitudes de cada cien devuelvan una respuesta equivocada con confianza en concurrencia 8, mientras que la misma configuración con la especulación desactivada no devuelve ninguna, no es un parámetro de ajuste. Hasta que ese issue se cierre, la postura honesta es que DFlash 2 es un buen drafter con un bug de integración sin resolver en la misma pila que su propio manual te dice que uses.
Si de todos modos lo vas a evaluar, mide dos cosas que la ficha no te da: la memoria residente con el drafter cargado y tus ajustes reales de KV-cache, y la precisión de las respuestas a tu concurrencia p50 en lugar de a una sola. Ambas son baratas. Ambas son las cifras que deciden.
Así estaban las cosas el 22 de septiembre de 2026. Los proyectos avanzan rápido: comprueba la fuente antes de confiar en esto.
Preguntas frecuentes
- ¿De qué más, además de la H200, dependen las cifras publicadas?
El tamaño de bloque es 8, es decir, siete tokens de borrador por paso de verificación; el muestreo sigue la temperatura recomendada de Qwen3.8, 1.0, top-p 0.95, top-k 20; y la salida está limitada a 4,096 tokens. Cada cifra de throughput y de longitud de aceptación de la ficha se produjo bajo esa combinación exacta, así que un despliegue que difiera en cualquiera de esos parámetros no es comparable hasta que lo vuelvas a medir.
- ¿Puedo ejecutarlo en vLLM?
La implementación en vLLM se fusionó el 21 de agosto de 2026, así que el método existe en ese proyecto además de en SGLang. La ficha no se ha actualizado: su guía rápida todavía indica instalar desde el pull request #52816, que seguía sin fusionar cuando se publicó la ficha. Comprueba tu versión de vLLM contra la fecha de la fusión en lugar de seguir la ficha al pie de la letra. Ten en cuenta también que los reportes de corrección en concurrencia 8 se registraron contra SGLang, lo que significa que el comportamiento de vLLM bajo la misma carga está sin medir en público, no que esté limpio.
- ¿DFlash 2 solo funciona con Qwen3.8-27B?
Un drafter DFlash 2 se entrena contra un objetivo concreto, y se publicaron dos: este y un drafter para Muse Glimmer, donde el proveedor reporta 3.1–4.6× en lugar de 2.7–3.4×. El lanzamiento de agosto cubrió esos dos objetivos y ningún otro, y las mediciones publicadas por el proveedor cubren solo la H200. Emparejar el drafter con un objetivo contra el que no fue entrenado no es una opción de configuración.
- ¿La salida es realmente idéntica a la del modelo base?
Esa es la afirmación matemática, y las matemáticas en sí no están en duda: el decodificado greedy coincide exactamente con el objetivo y el muestreo preserva su distribución. Lo que está abierto es si las implementaciones la respetan. Las respuestas erróneas en concurrencia 8 parecen un fallo de integración de servicio, una divergencia en la ruta de verificación bajo composición de lotes, pero la persona que las midió señala un segundo reporte, z-lab/dflash issue 159, de divergencia greedy respecto al decodificado autoregresivo plano en MLX, sin que intervenga SGLang, y admite que parte de esto podría estar en el propio contrato de verificación. En cualquier caso, la distinción le importa a quien lo está arreglando y nada a quien recibe la respuesta equivocada.
- ¿Por qué la gente reporta longitudes de aceptación muy por debajo del 5.46 de la ficha?
Porque la longitud de aceptación es una propiedad de todo el despliegue, no solo del drafter. Un reporte abierto en el tracker de DFlash, z-lab/dflash issue 170, tiene aproximadamente 3 en llama.cpp frente a aproximadamente 5.5 en vLLM, pero el runtime no es lo único que difiere. Los objetivos son checkpoints distintos, un GGUF Q6_K frente a una compilación AWQ MXFP4, y los dos drafters también son cuantizaciones distintas. La hipótesis principal del autor del reporte, indicada en el título del issue, apunta al emparejamiento de objetivos y no al motor. Controla los checkpoints antes de culpar al runtime, y lee el 5.46 como una cifra producida por una configuración concreta, no como un objetivo que tu despliegue haya fallado en alcanzar.