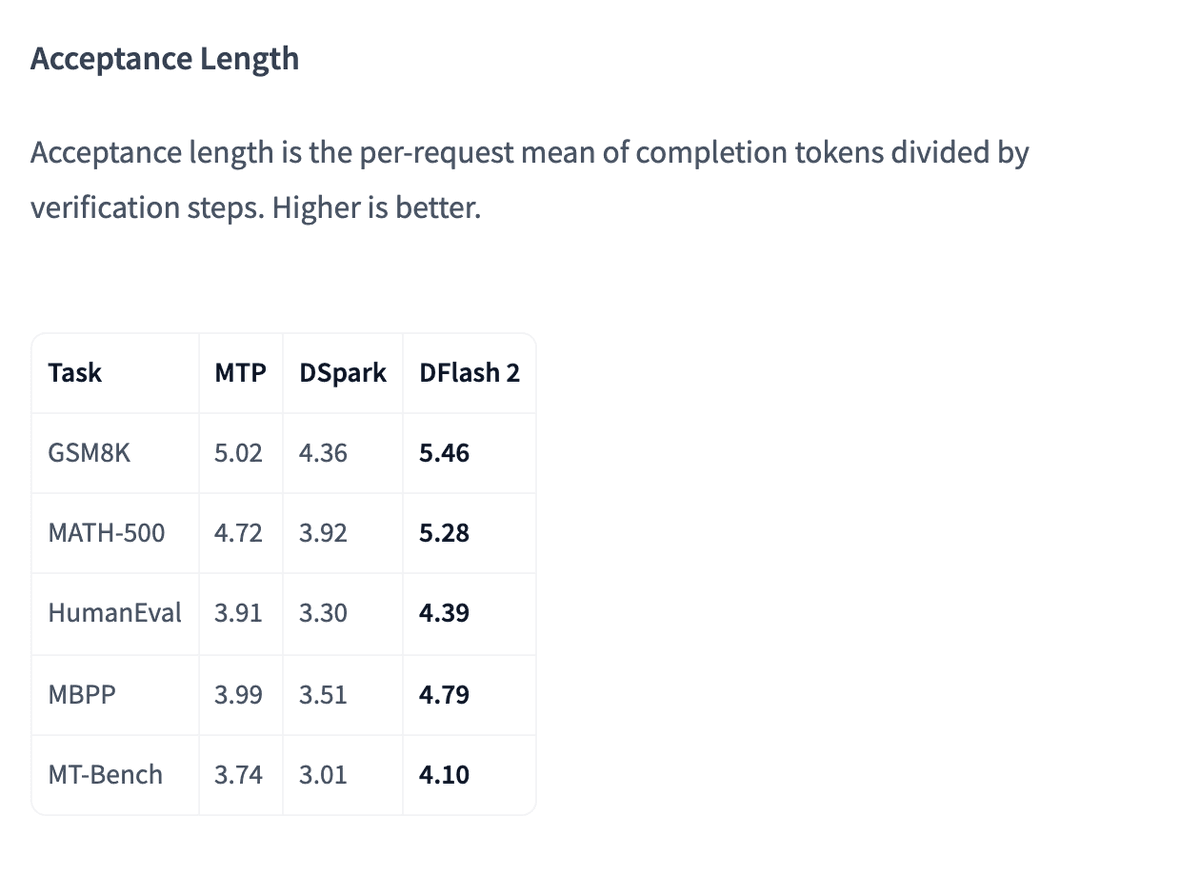
DFlash 2: un drafter de 3.43× que cae a 1.45× bajo carga
El drafter de difusión por bloques de Inco AI llega a 3.43× en GSM8K con una sola solicitud y 1.45× en concurrencia 32. Esto cuesta en memoria y varianza.

Todos los análisis publicados, empezando por los más recientes.
El drafter de difusión por bloques de Inco AI llega a 3.43× en GSM8K con una sola solicitud y 1.45× en concurrencia 32. Esto cuesta en memoria y varianza.
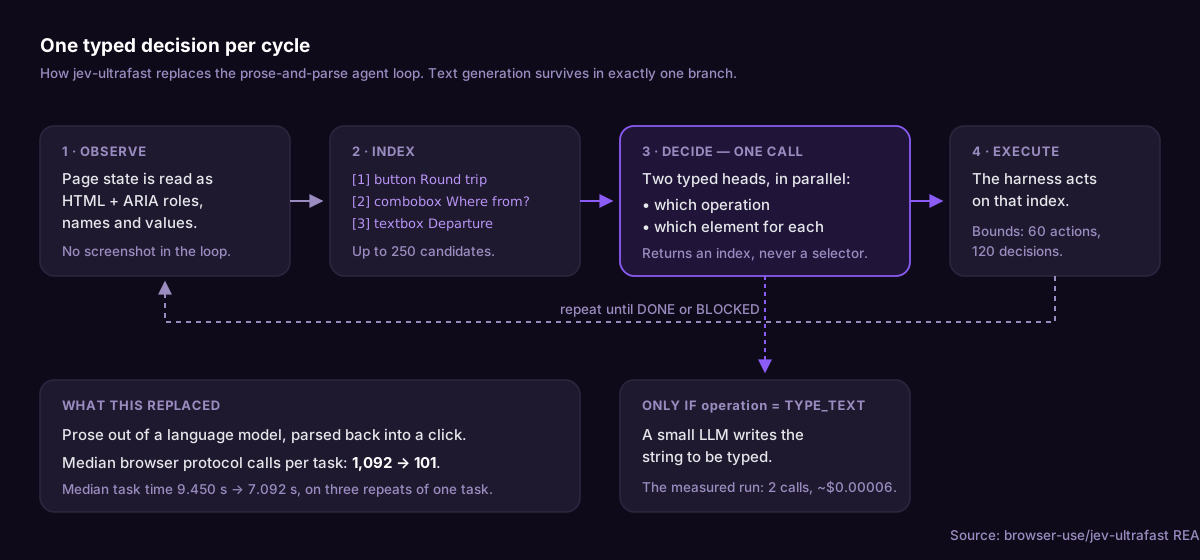
jev-ultrafast (browser-use) completa una búsqueda en Google Flights en 7,1 s sustituyendo el bucle del agente por una decisión tipada por ciclo. Aquí está la trampa.
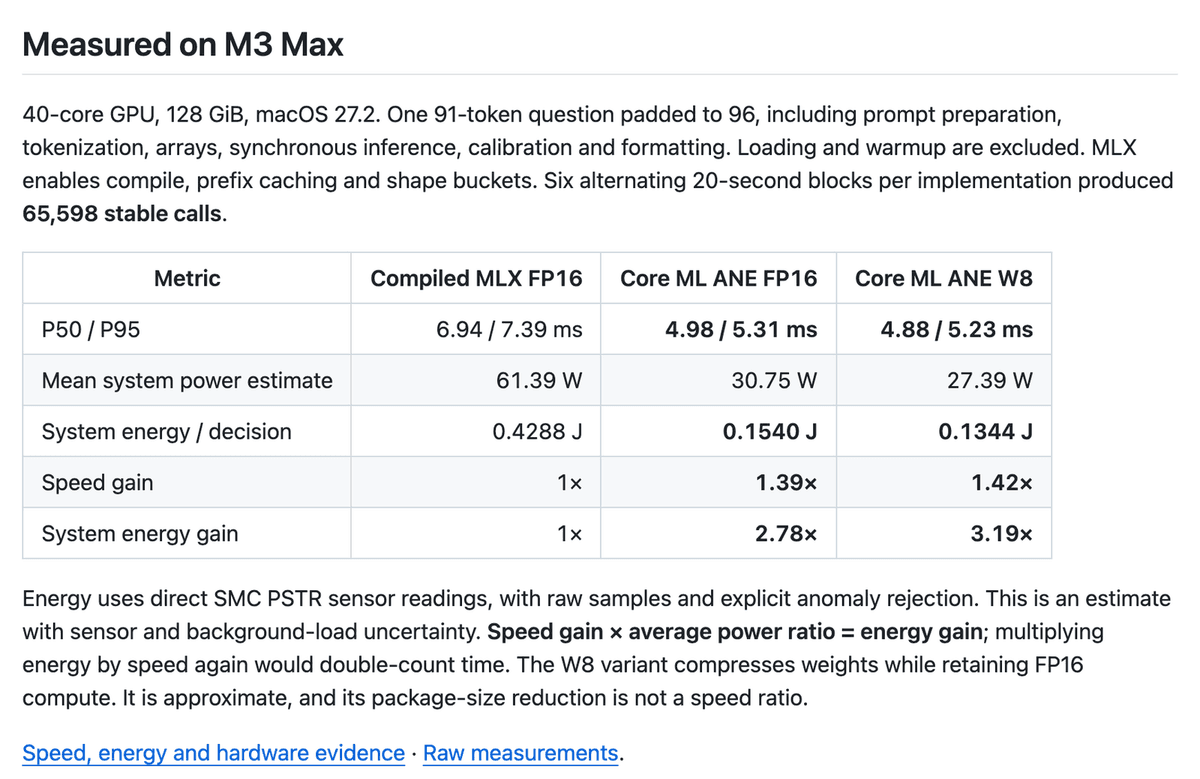
El port de Core ML de mizorewww ejecuta una decisión tipada de Laya en 4.98 ms y 0.154 J en un M3 Max. Lo que demuestran las pruebas de paridad, y lo que no.
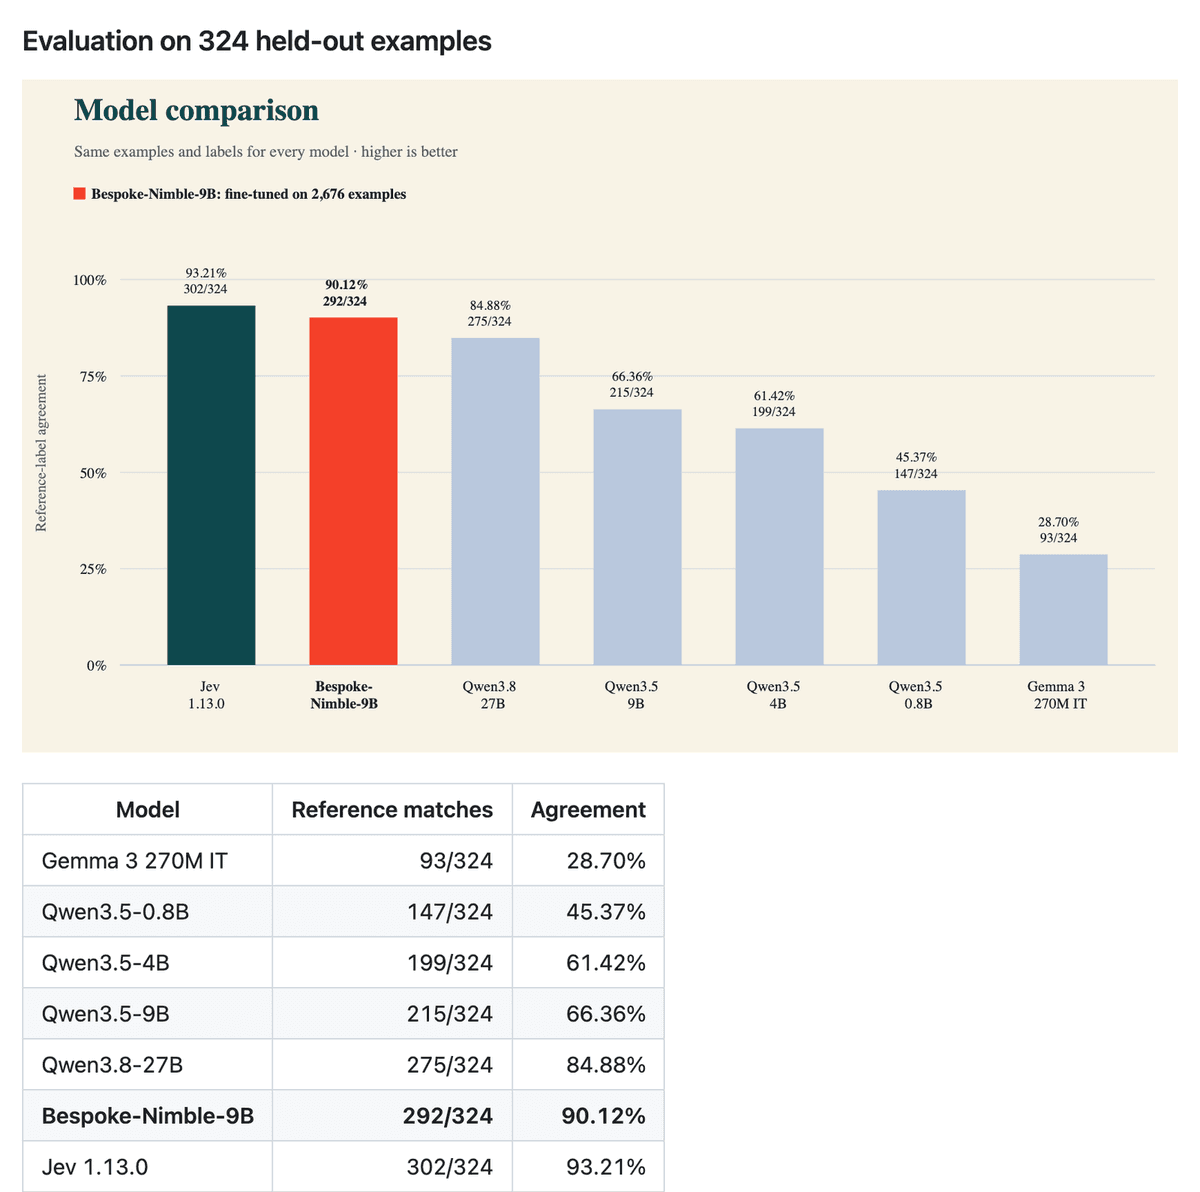
Bespoke Labs ajustó Qwen3.5-9B con 2,676 ejemplos sintéticos. Alcanza 90.12% frente al 93.21% de Jev, y su evaluación cubre seis de diez dominios entrenados.