
Laya en el Neural Engine: 4.98 ms y 0.154 J por decisión
Publicado el 22 de septiembre de 2026
Una decisión con precio en milisegundos y julios
mizorewww/laya-coreml toma los checkpoints de decisión tipada de Laya, los convierte a Core ML, y los ejecuta en el Apple Neural Engine. El resultado de ese trabajo no es una nueva capacidad. Es una lista de precios.
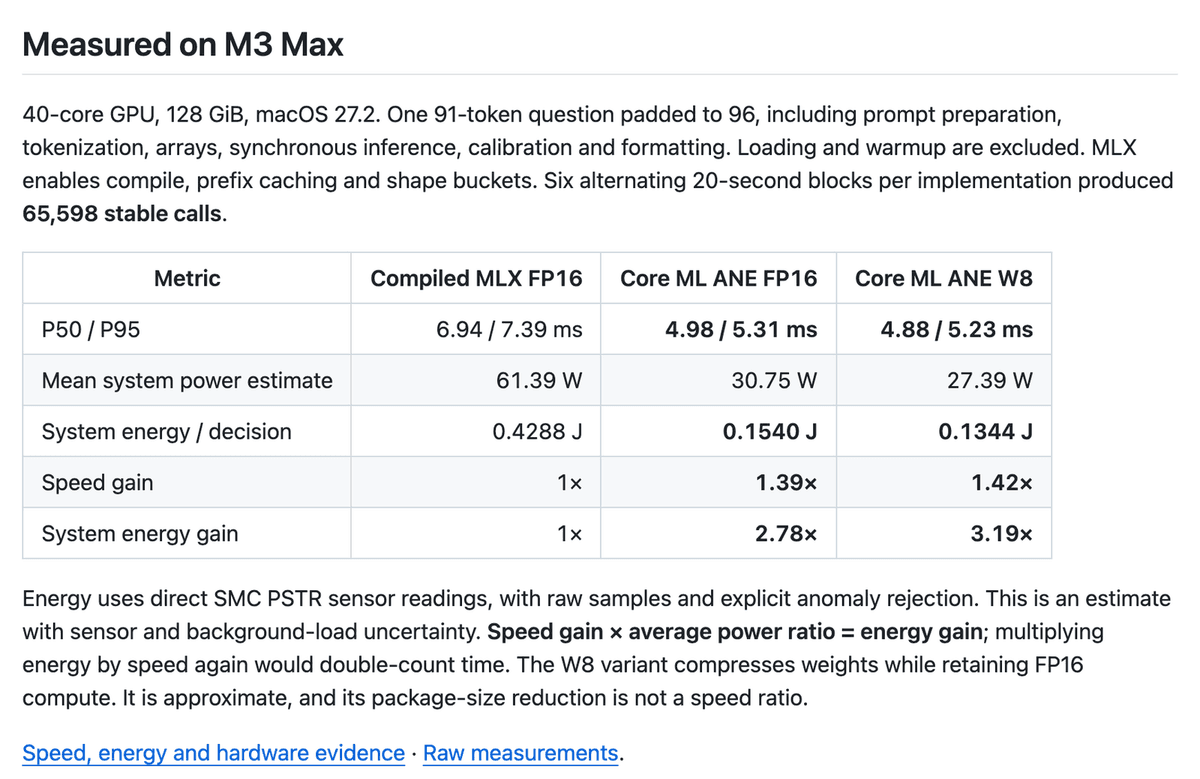
One short multilingual decision: 4.98 ms P50 / 5.31 ms P95 on M3 Max with ANE FP16.
La misma tabla sitúa el MLX FP16 compilado en 6.94 / 7.39 ms, y la energía por decisión en 0.1540 J para el ANE frente a 0.4288 J para MLX — una mejora de 2.78× en 65,598 llamadas estables, con la energía leída del sensor SMC PSTR en lugar de modelada. Diez mil decisiones en el Neural Engine son unos 1.5 kJ, o 0.43 Wh. Es una cifra contra la que se puede presupuestar, y es la razón por la que existe este port en lugar de otro wrapper.
Aun así, lee las condiciones de la prueba antes de gastarla.
One 91-token question padded to 96, including prompt preparation, tokenization, arrays, synchronous inference, calibration and formatting.
La pregunta tiene 91 tokens; el padding lleva el tensor a 96; y 96 es todo el presupuesto. El límite total del bundle de ANE es de 96 tokens, contando la pregunta, las opciones y cualquier estado transportado, y una solicitud más larga produce un error de capacidad. Así que la cifra principal se mide con la caja llena — la forma correcta de medirla, y también una advertencia de que no hay margen que encontrar más tarde.
Lo que hay dentro de la caja importa más que los milisegundos, y esta es la parte que hay que revisar antes de portar cualquier cosa.
The three general-purpose FP16 checkpoints match upstream selected answers on 189/189 validation questions. Each passes 100 repeated calls.
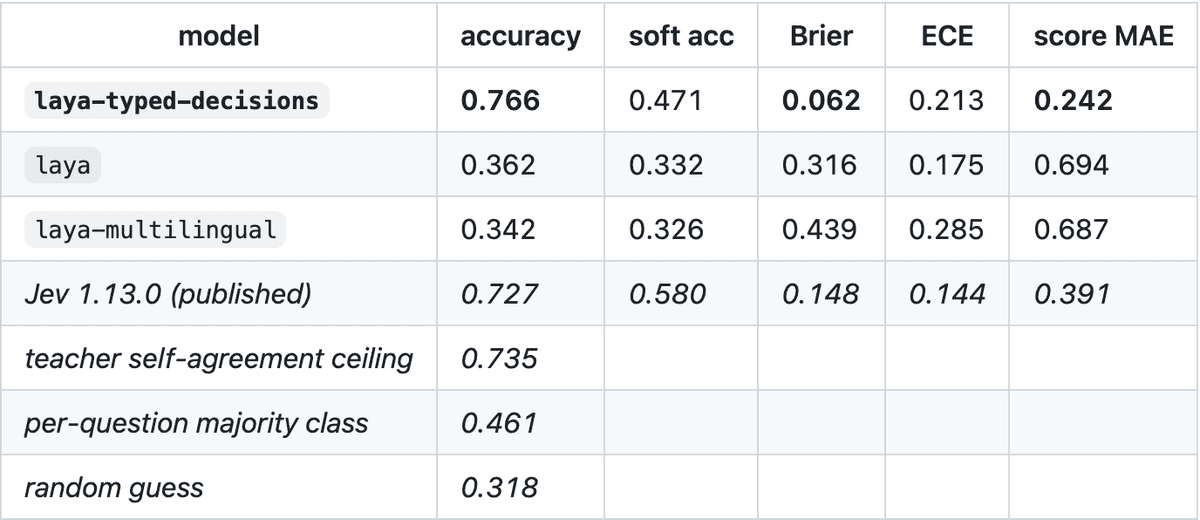
De propósito general es la frase clave. En el benchmark de decisiones tipadas de upstream, los checkpoints de propósito general puntúan 0.362 y 0.342, por debajo del 0.461 que alcanza una conjetura de clase mayoritaria por pregunta; el 0.766 que hace que Laya parezca fuerte pertenece a un fine-tune específico de la tarea. Lo que ninguna página, en ninguno de los dos lados, informa es una cifra de precisión para el bundle que produjo los 4.98 ms. La latencia se mide por bundle; la precisión se mide por checkpoint de upstream; nadie une las dos columnas.
El bucle es lo que tiene que ser barato
Ocho repositorios llevan el nombre Laya en el feed de esta semana, y los dos que tienen mediciones adjuntas son ports de runtime del mismo autor: un runtime de MLX, y luego este de Core ML. Ninguno añade una capacidad al modelo. Ambos existen para hacer que una decisión sea lo bastante barata como para caber dentro de un bucle que la ejecutará miles de veces — la propia comprobación de extremo a extremo del port es una partida de Snake de 600 pasos, comparada acción por acción con la build de MLX.
Esa es la premisa sobre la que actúa el cluster: que un round trip de red no cabe dentro de un frame. Vale la pena nombrarla como premisa, porque nadie aquí ha publicado una medición de tiempo de la alternativa alojada junto a la suya propia. Lo que laya-coreml sí publicó es la otra mitad del presupuesto, la que casi nadie mide.
A separately validated W8 palette variant reached 4.88 ms and 3.19× energy improvement.
El mismo párrafo añade que estos son resultados de una sola pregunta y no tiempos completos de frame de Snake, y que la mejora de diez veces que el trabajo se propuso encontrar no se logró. Dos desarrolladores que probaron el mismo movimiento en otros runtimes publicaron después mediciones en un eje completamente distinto: no qué tan rápido responde el modelo convertido, sino si la respuesta y la confianza asociada a ella sobreviven a la conversión.
Los fixtures de paridad demuestran que la respuesta no cambió, no que fuera correcta
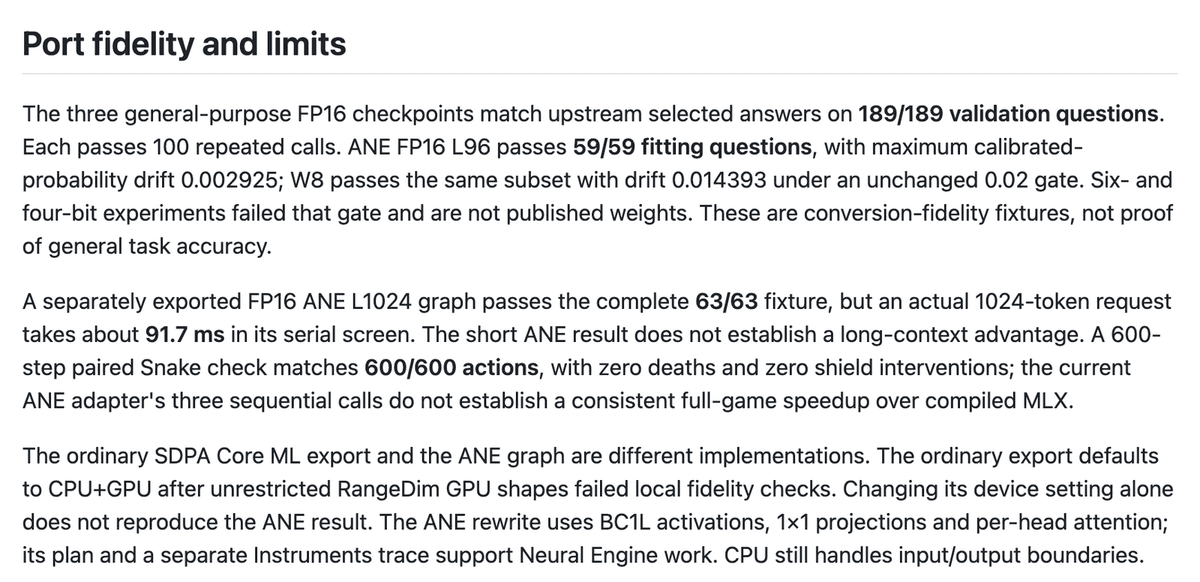
La validación del port es exhaustiva y está inusualmente clara sobre su propio alcance. La build ANE FP16 pasa 59 de 59 preguntas de ajuste con una deriva máxima de probabilidad calibrada de 0.002925; W8 pasa el mismo subconjunto con 0.014393 frente a un gate sin cambios de 0.02; los experimentos de seis y cuatro bits no pasaron ese gate y nunca se publicaron como pesos. Y luego, en el mismo párrafo:
These are conversion-fidelity fixtures, not proof of general task accuracy.
Esa distinción es exactamente donde aterrizan las críticas. En Hugging Face, el autor de un port web cuantizado informa lo que ocurre cuando se recurre a la compresión obvia:
Ordinary dynamic INT8 destroys this model. onnxruntime.quantization.quantize_dynamic drops argmax agreement to 69% with a worst-case probability shift of 0.99.
— nvkudva, laya-web-q8 model card
Cuantizar solo los MatMuls es catastrófico, mientras que cuantizar solo los embeddings sobrevive, lo que apunta a outliers de activación más que a la precisión de los pesos. Un desarrollador que trabajaba el mismo problema en un port de navegador resumió el trade-off en una línea:
The difference is the quantization scheme, not the checkpoint, and it is also where the twentyfold speed difference comes from.
— a-voronkov, laya-web-poc PR #16
La calibración es el segundo agujero, y es un problema de secuenciación más que un bug de cuantización:
The shipped temperatures were fitted by the original author, not refitted after quantization.
— nvkudva, laya-web-q8 model card
Upstream coincide en la magnitud, en su propio README:
Refitting one temperature per (question type, option count) on held-out data moves mean ECE 0.466 -> 0.081 (laya) and 0.314 -> 0.106 (laya-multilingual).
El port de Core ML ya ha detectado un caso en el que esto salió mal: una temperatura de fábrica de 0.1006 para el bucket de once o más opciones, lo bastante afilada como para reportar un lanzamiento de moneda como casi-certeza, ahora limitada (clamped) con una advertencia nombrada al cargar. Un fixture que compara las probabilidades de dos modelos no puede ver un error que ambos heredan.
La tercera objeción no toca el silicio en absoluto. Aterriza en el router que elige qué checkpoint ejecuta el silicio.
128/200 German utterances (64%) went to the English checkpoint.
Una conjetura de idioma indecisa se trata como inglés, y pasar lang="de" recupera la precisión completa, así que el modelo está bien y el enrutamiento no. Es un vaivén de 20 puntos en texto corto en escritura latina, decidido por una heurística que informa confianza total mientras se equivoca.
Lo que nadie ha producido es la comparación que la mayoría de los lectores quiere:
Accuracy and calibration claims for laya-mlx haven't been independently verified against a shared benchmark like JevBench; the published numbers cover latency, throughput, and memory only.
Fíjate en lo que eso deja fuera. Cada medición anterior es local contra local — Neural Engine contra MLX compilado en el mismo portátil, una pregunta a la vez. Nadie ha publicado un round trip alojado medido junto a ella, así que «más rápido que la API» sigue siendo la premisa de la que parten estos proyectos, no un resultado que ninguno de ellos informe.
Encajarlo en algo que se despliega
La cifra de 5 ms se sostiene para decisiones cortas y de forma fija, y deja de sostenerse en el momento en que sales de la caja:
A separately exported FP16 ANE L1024 graph passes the complete 63/63 fixture, but an actual 1024-token request takes about 91.7 ms in its serial screen.
Dieciocho veces la latencia. El proyecto saca la conclusión por sí mismo:
The short ANE result does not establish a long-context advantage.
Así que la versión desplegable es un prompt pequeño y fijo, una lista corta de opciones, selección explícita de idioma en lugar de auto-enrutamiento, y temperaturas que tú mismo ajustaste con tus propios datos etiquetados después de la conversión. Presupuesta el etiquetado. Ese es el verdadero coste de integración, no la exportación.
La forma que subyace a todo esto es una puerta (gate): una decisión tipada es un clasificador, y un clasificador se gana el sitio delante del trabajo más lento, así que la mayoría de las entradas nunca llegan a la llamada al modelo, al scraping o a la persona. En un portátil, la puerta es el bundle de Core ML y el ahorro consiste en que lo caro nunca se pide. En un pipeline alojado, la puerta es en cambio el primer paso dentro de la ejecución, y esa es una forma que se ajusta al medidor de Latenode: cuenta los segundos de CPU que una ejecución realmente consume — tiempo de ejecución, no el número de nodos o llamadas a la API — y no hay un cargo mínimo por ejecución, así que una ejecución que termina en la puerta se factura por los segundos que gastó y no como una ejecución completa. El paso que hace de puerta es un nodo ordinario: uno de los aproximadamente 335 modelos del catálogo, o un nodo de JavaScript, que puede instalar cualquier librería de NPM. El plan gratuito incluye 10.000 segundos de CPU al mes y cinco workflows activos. Nada de eso ejecuta el bundle de ANE, que se queda en el portátil; lo que se mueve entre ambos es la forma, no el artefacto.
Quién debería portar esto esta semana
Pórtalo si tienes una decisión fija y de baja cardinalidad dentro de un bucle en silicio de Apple, tu prompt y tus opciones caben en 96 tokens, puedes indicar el idioma en lugar de dejar que el router lo adivine, y tienes ejemplos etiquetados con los que reajustar la calibración. Comprueba qué checkpoint de upstream lleva tu bundle antes de prometerle a alguien una cifra de precisión — el port es explícito en que lo que convirtió es la familia de propósito general, y la familia de propósito general no es la fila que supera al teacher. Para ese lector, las cifras de velocidad y energía son reales y reproducibles, que es más de lo que logran la mayoría de las afirmaciones on-device: 4.98 ms, 0.154 J, medidas por sensor, con 65,598 llamadas detrás.
Sáltatelo si esperabas sustituir un endpoint de decisión alojado por esto y mantener todo lo demás igual. El trabajo publicado no respalda ese cambio — no existe una comparación de benchmark compartido, las probabilidades de fábrica están mal calibradas hasta que las corriges, y el auto-enrutamiento cuesta silenciosamente 20 puntos en texto corto no inglés de escritura latina. También hay un techo para cuántas etiquetas puedes pedir:
I've found they start to fail the more classifications you have, long before your typical ML classifier.
Si estás evaluando esto como una arquitectura y no como un paquete, la lectura honesta es más estrecha de lo que sugiere el número de estrellas: la evidencia respalda poner una decisión pequeña y bien especificada en el Neural Engine a un coste conocido por llamada, y todavía no respalda poner ahí tu criterio.
Así estaban las cosas el 22 de septiembre de 2026. Los proyectos avanzan rápido: comprueba la fuente antes de confiar en esto.
Preguntas frecuentes
- ¿Es laya-coreml una versión oficial de Apple o de Convai?
No. El README lo describe como un port independiente bajo Apache-2.0 y afirma claramente que no es una versión oficial de Convai Innovations ni de Apple. Trata los pesos y el arnés de benchmark como trabajo comunitario con un archivo NOTICE, no como un SDK de proveedor con un canal de soporte.
- ¿La variante W8 hace que el modelo sea significativamente más rápido?
Apenas. Reporta 4.88 ms P50 frente a 4.98 ms para FP16 - 1.42× frente a 1.39× sobre MLX compilado. La ganancia está en la potencia, 27.39 W frente a 30.75 W de consumo medio del sistema, y en el tamaño del paquete. El README advierte que la reducción de tamaño del paquete no es una ratio de velocidad, porque W8 comprime los pesos mientras que el cómputo se mantiene en FP16.
- ¿La exportación de contexto largo también se ejecuta en el Neural Engine?
No por defecto. La exportación ordinaria de Core ML con SDPA y el grafo de ANE son implementaciones distintas, y la ordinaria usa por defecto CPU+GPU después de que las formas de GPU con RangeDim sin restringir fallaran las comprobaciones locales de fidelidad del proyecto. Cambiar su configuración de dispositivo no reproduce el resultado del ANE - la ruta de ANE es una reescritura que usa activaciones BC1L, proyecciones 1x1 y atención por cabeza.
- ¿Qué necesito realmente para reajustar la calibración?
Ejemplos etiquetados de tu propio tráfico, agrupados por tipo de pregunta y número de opciones, con una temperatura ajustada por bucket después de la conversión y no antes. Nada en el port hace esto por ti. Dos cosas ayudan mientras trabajas: los valores sin limitar (unclamped) siguen siendo accesibles como agent.temperature_raw y agent.temperature_by_options_raw, y un RuntimeWarning al cargar nombra cada bucket que el port tuvo que limitar (clamp).
- ¿0.154 J significa que el chip gasta 0.154 julios?
No. Es una estimación de todo el sistema a partir de lecturas directas del sensor SMC PSTR, así que incluye lo que sea que el portátil estuviera haciendo además, y el README señala la incertidumbre del sensor y de la carga de fondo. La carga y el calentamiento (warmup) quedan excluidos de la cifra por decisión, lo cual importa si tu proceso tiene una vida corta.
- ¿Puedo comprimir por debajo de 8 bits para caber en un dispositivo más pequeño?
No con los pesos publicados. Los experimentos de seis y cuatro bits del port no pasaron su gate de deriva de probabilidad calibrada de 0.02 y nunca se publicaron; W8, con una deriva de 0.014393, es el suelo que estuvo dispuesto a enviar. Ten en cuenta que W8 comprime los pesos mientras el cómputo se mantiene en FP16, así que no es la misma operación que cuantizar activaciones, que es donde los otros runtimes se atascaron.