
Nimble: 2,676 ejemplos para acercarse a Jev en tres puntos
Publicado el 22 de septiembre de 2026
Una receta, no otro endpoint más
Bespoke Labs publicó nimble el 18 de septiembre: un adaptador LoRA que convierte Qwen3.5-9B en un modelo de decisión tipada — elige uno de estos candidatos, aplica esta política, puntúa esto contra esta rúbrica — y, más útil todavía, el pipeline completo que lo produjo. Código de curación, configuración de entrenamiento, arnés de evaluación, todo Apache 2.0. El propio adaptador pesa unos 165 MiB y necesita el modelo base de 18 GB al lado.
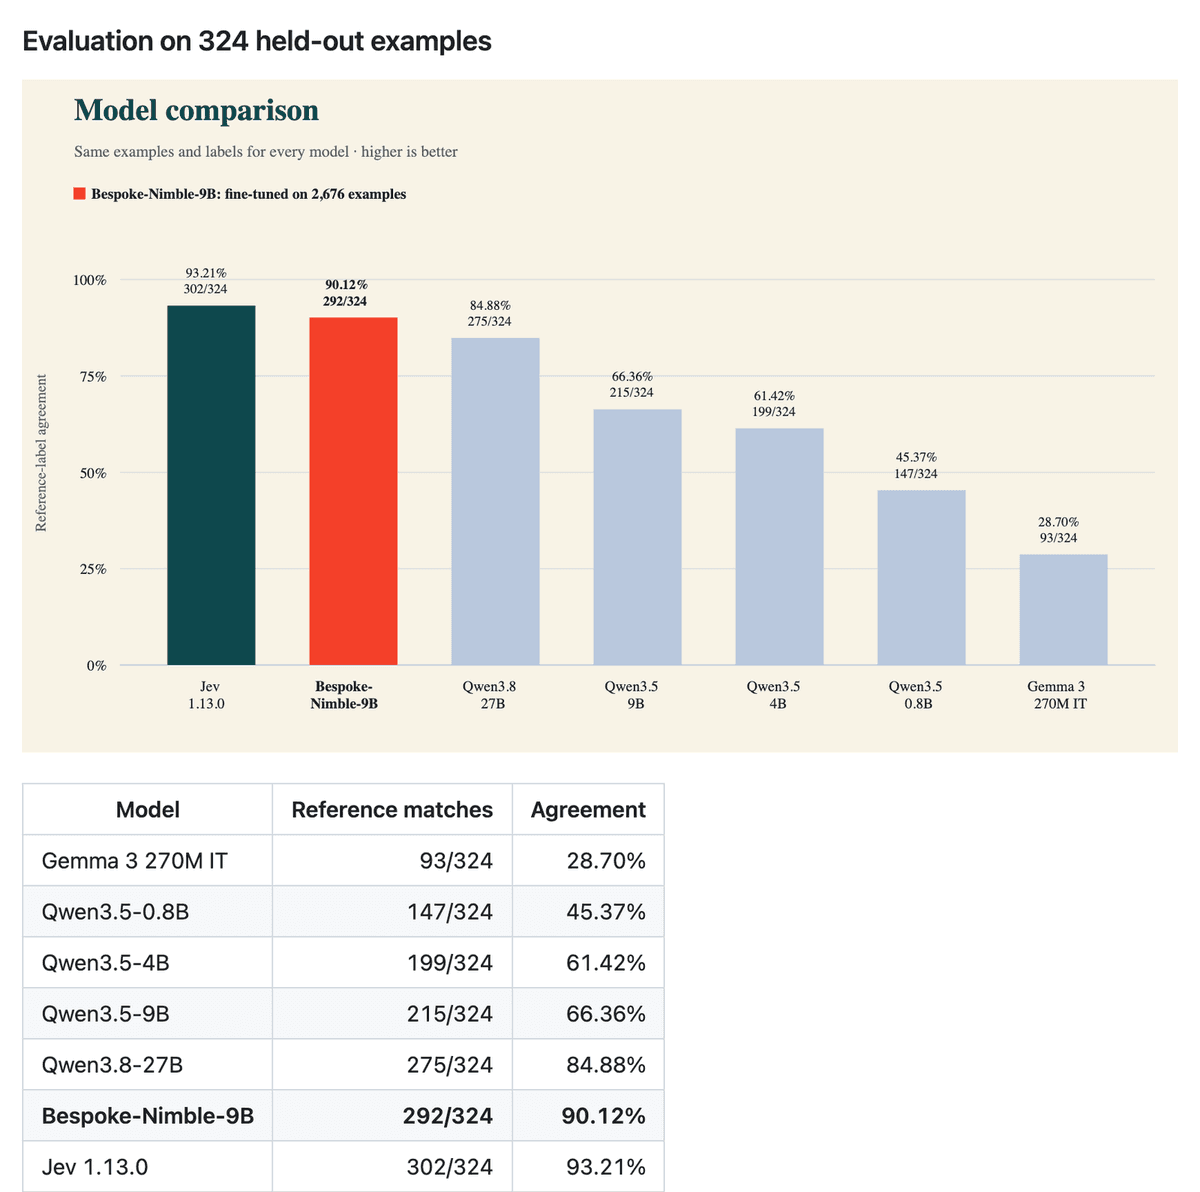
Lo que eso cambia para el lector es la aritmética de una pregunta que la gente lleva discutiendo sin números: cuánto cuesta dejar de llamar al modelo de decisión de otro. Sobre el conjunto held-out congelado del proyecto de 324 ejemplos, el fine-tune coincide con la etiqueta de referencia el 90.12% de las veces. El Jev 1.13.0 de TypeSafe obtiene 93.21% sobre los mismos ejemplos. El modelo base sin ajustar obtiene 66.36%. Así que el LoRA cierra casi toda una brecha de 26.85 puntos y deja tres puntos sobre la mesa.
Note that we did not distill from Jev.
Esa frase está haciendo trabajo real. Significa que la receta es una receta y no una copia, y significa que los tres puntos son el coste de construir los datos de entrenamiento tú mismo, y no el coste de una imitación con pérdidas.
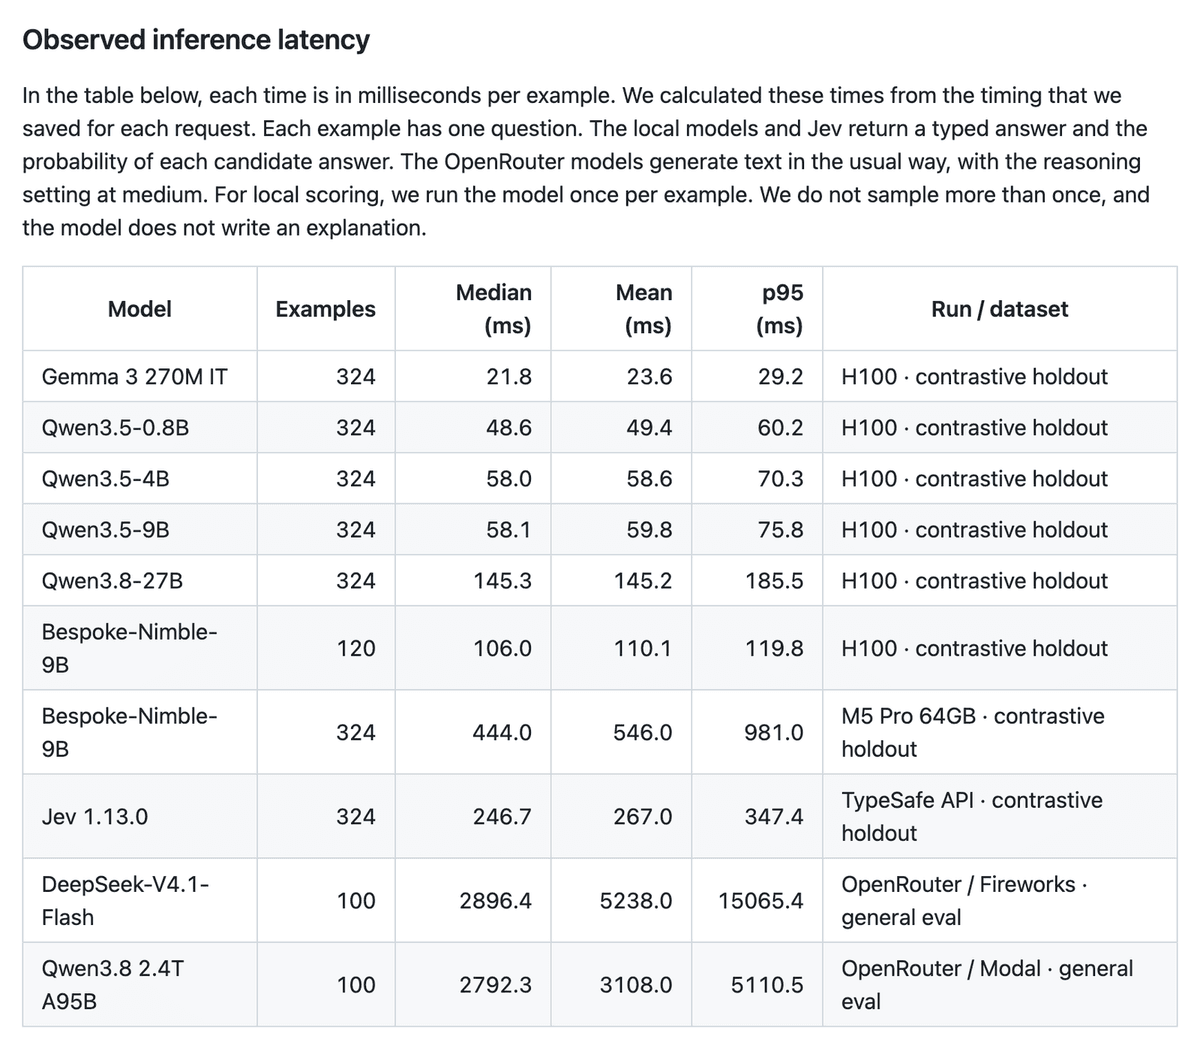
En local también es más rápido que la llamada que reemplaza, con la salvedad impresa en la misma tabla. 106.0 ms de mediana por ejemplo en una H100 frente a 246.7 ms a través de la API de TypeSafe. En una M5 Pro de 64GB el mismo adaptador tarda 444.0 ms de mediana, 546.0 de media, 981.0 en p95 — que es donde termina la versión de la propuesta para portátil. Más arriba en la misma tabla, el Qwen3.5-9B base sin ajustar corre en 58.1 ms sobre los 324 ejemplos completos, y el repositorio no explica qué aporta el adaptador. La cifra rápida tampoco se apoya en la misma muestra que todo aquello con lo que se compara.
Their recorded times are also not from a controlled serving test.
La parte de la ola que enseñó su proceso
Jev se lanzó cerrado, y septiembre se llenó de imitaciones — un resumen de AINews de esta semana catalogó seis de ellas y especuló sobre las arquitecturas, porque especular era lo único que se podía hacer. Casi todas publicaron una cifra de velocidad y un endpoint.
a lot of demos emphasized speed more than quality, and there is still no standard benchmark for this category.
Nimble es la entrada que entregó el paso caro en su lugar: cómo se hicieron los datos de entrenamiento. Bespoke llama al método curación de datos contrastiva. Escribes dos ejemplos casi idénticos.
They differ in one relevant fact, and this difference changes the correct answer.
El ejemplo documentado es una política de reembolsos donde solo Mira puede autorizar reembolsos en una cuenta; la versión emparejada cambia el nombre en la autorización firmada a Noah, y la respuesta correcta pasa de verdadero a falso. Todo lo demás — la pregunta, la política, la redacción — se mantiene igual. El pipeline lo impone con una comprobación mecánica de localidad: cada par propuesto puede cambiar una frase y como máximo ocho palabras separadas por espacios, medido con un diff de tokens. Llamadas al modelo por separado verifican luego los hechos en cada ejemplo, y una prueba de eliminación confirma que quitar cualquiera de las frases de evidencia deja el hecho central genuinamente desconocido.
Eso produjo 2,676 ejemplos repartidos en diez categorías temáticas, generados con GPT-5.6 Terra y verificados con GPT-5.6 Sol, seguidos de una sola época de entrenamiento LoRA — 335 actualizaciones del optimizador con un tamaño de lote efectivo de 8. El ajuste corrió en L40S; el fit final corrió en una H100. Todo el proceso se armó a la velocidad a la que se movía la semana.
We built Nimble in one day, so expect some rough edges.
Dónde pierde es más útil que por cuánto
El README remite a una comparación externa: trece subconjuntos públicos, etiquetados por humanos, fuera de las categorías de entrenamiento, ambos modelos puntuados sobre los mismos registros.
That is a gap of 1.2 macro points in Jev's favour across tasks that are all outside Nimble's training categories.
— Nimble public benchmarks guide
74.8% macro frente a 76.0%. Esa brecha es la cifra que se va a citar, y es la línea menos informativa de la página.
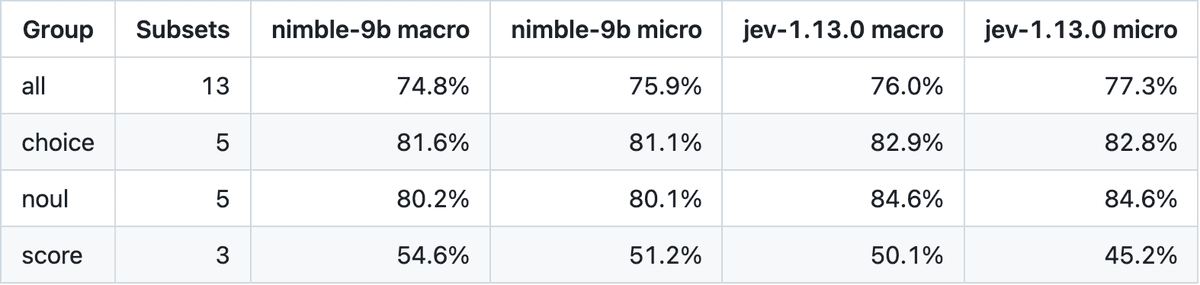
Dividido por grupo, el fine-tune pierde en choice 81.6 frente a 82.9 y pierde en noul 80.2 frente a 84.6, y gana en score 54.6 frente a 50.1, con las cifras micro aún más separadas, 51.2 frente a 45.2. Leído como tres resultados, eso dice que un modelo entrenado con 2,676 ejemplos hechos por uno mismo supera al proveedor en puntuación de rúbricas y va por detrás en clasificación. La tabla de precisión por subconjunto impresa encima de esos promedios dice algo más estrecho y más útil, porque lleva un valor p de McNemar en cada fila. La victoria en score tiene solo un conjunto de datos de profundidad: summeval-relevance con 49.2 frente a 35.0, p=0.0004, mientras que helpsteer2 está 4.9 puntos separado con p=0.3232, que no es significativo, y el fine-tune pierde el tercer subconjunto de score, summeval-consistency, 75.7 frente a 81.2. El déficit de 1.3 puntos del grupo choice, por su parte, promedia dos derrotas significativas — massive-de-DE con p=0.0169, vitaminc-dev con p=0.0125 — frente a una victoria que no es significativa. Así que la versión honesta de la división no es "gana en puntuación de rúbricas": es que un único conjunto de datos de resumen sostiene la única victoria inequívoca, y las derrotas que sobreviven a una prueba de significancia están repartidas por los subconjuntos de clasificación.
La división del README del mismo conjunto de entrenamiento por tipo de tarea sugiere una causa más que una coincidencia. Score es el bloque más grande, con 932 ejemplos, frente a 888 de Noul y 856 de Choice. El modelo es más fuerte, en relación con el proveedor, en el tipo de tarea del que vio más ejemplos.
Una fila merece salir de los promedios por completo. paws es el octavo de los trece subconjuntos: mezcla adversarial de palabras, donde dos frases comparten la mayoría de sus palabras pero significan cosas distintas. Tipo noul, 250 registros. El fine-tune puntúa 82.8%, Jev 89.2%, y la página marca la diferencia como significativa con p=0.0025. Esa brecha de 6.4 puntos es más ancha que cualquiera de los promedios de grupo, y cae exactamente sobre una tarea construida igual que los datos de entrenamiento: pares de frases mínimamente distintas que significan cosas distintas. PAWS es la idea propia de la curación contrastiva, escrita como prueba adversarial por otras personas. La afirmación más distintiva del método es la más débil en la tarea para la que existe el método.
Los autores son directos sobre el límite de todo esto.
We trained Bespoke-Nimble-9B on 2,676 examples that we curated. So it's performance will depend on this data and the domains it comes from.
(Los errores tipográficos son suyos, y son la construcción de un día asomando.) El alcance de dominio es más estrecho de lo que incluso esa frase sugiere, y el README imprime la razón como una tabla: un recuento de entrenamiento y un recuento held-out para cada una de las diez categorías.
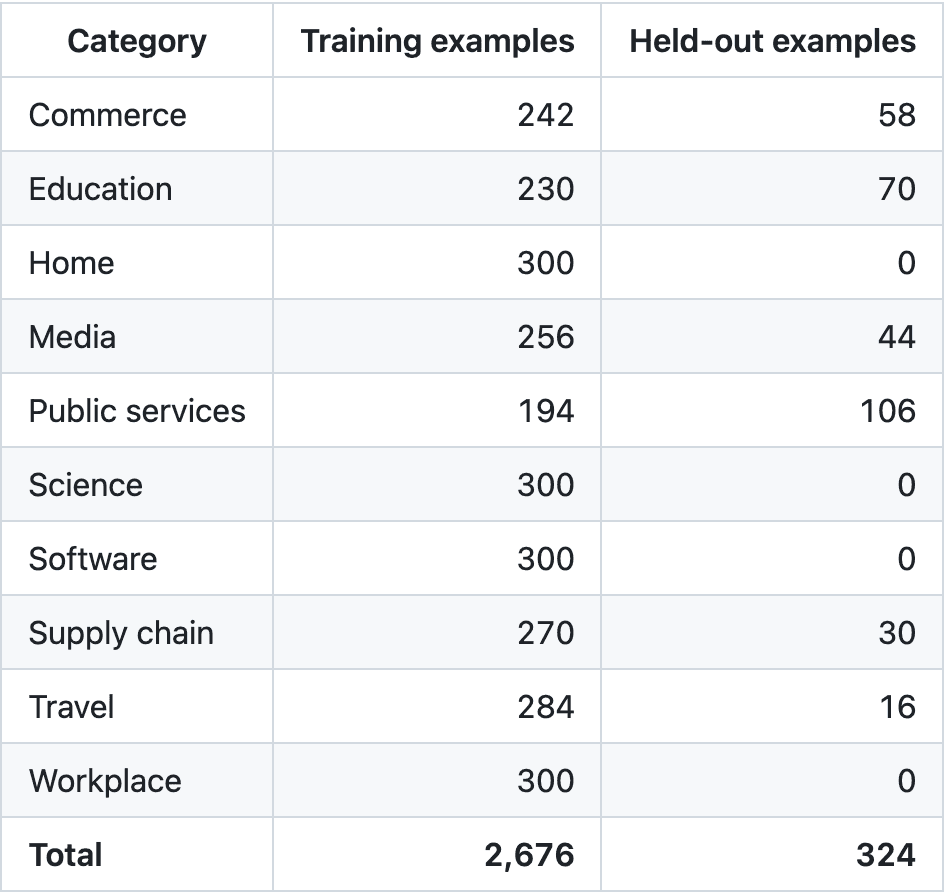
Cuatro de los diez recuentos held-out son cero: Home, Science, Software y Workplace, con 300 ejemplos de entrenamiento cada una. La evaluación completa de 324 ejemplos viene de las otras seis — Public services 106, Education 70, Commerce 58, Media 44, Supply chain 30, Travel 16. Así que el 90.12% se mide sobre seis décimas partes de la superficie con la que se entrenó el modelo, y las cuatro décimas no medidas son los cuatro bloques de entrenamiento más grandes del conjunto. No débil: no reportado.
Fuera del proyecto, la queja es sobre de dónde salieron las etiquetas, sin más.
Of course, not enough people are talking about the data side, which is acknowledged to be 100% synthetic.
Reconocido es la palabra correcta, y el reconocimiento es inusualmente lúcido:
All of the labels are synthetic: a model checked them, and no person has reviewed them.
El README añade la razón por la que eso muerde: llamadas separadas al mismo modelo pueden cometer el mismo error, así que la verificación puede no detectar lo que el generador hizo mal. Los datos de entrenamiento y los datos de evaluación fueron producidos por la misma familia de generadores, lo que significa que un punto ciego compartido subiría la puntuación y bajaría la precisión a la vez, y nada en el repositorio lo mostraría.
El conjunto held-out es pequeño de una segunda manera que no tiene nada que ver con las categorías. Sus 324 ejemplos son 162 pares estrechamente relacionados, y el README cuenta de dónde proceden:
All of them come from only six source families, so this is a narrow test.
Si esas seis familias son las mismas seis categorías que cubre el holdout, el README no lo dice, y la guía de benchmarks usa "familias" en un sentido distinto en otra parte — un recuento de documentos fuente detrás de un subconjunto, como los 31 detrás de los 299 registros de squad2. En cualquier caso, la palabra del propio autor es la correcta: estrecho.
Dos críticas independientes afilan eso hasta convertirlo en algo comprobable. Un ingeniero que evaluó Jev en un arnés de agente encontró el modo de fallo que una garantía de esquema no puede atrapar:
High confidence means the model is sure it applied your definition — including your mistakes
— Benchmarking Jev in an agent harness, DEV Community
Informan de enrutados equivocados que llegan con confianza 1.0. La fidelidad a tu esquema no es corrección, y un fine-tune hereda tus definiciones de forma más literal de lo que lo haría un modelo de un proveedor. Por separado, un grupo de Johns Hopkins midió lo que esconde una comparación basada solo en la etiqueta: sobre 588 resultados, cada etiqueta final era correcta mientras que 581 salidas posteriores eran exactas.
the workflow can return the expected verdict while passing an incorrect quantity to subsequent analysis.
Coincidir con una etiqueta de referencia es exactamente una puntuación basada solo en la etiqueta. Las dos cifras principales de Nimble son de ese tipo.
La última objeción vuelve a paws, de alguien con intereses en la carrera. En el rastreador de incidencias del proyecto, un comentarista que firma como m0at enfrenta sus propios discriminadores de borde de peso cero contra Nimble-9B y Jev en una suite reconstruida de 324 muestras de BoolQ, MultiNLI y PAWS, e informa que su implementación alcanza el 100% con latencia sub-milisegundo. Trata una comparación autoejecutada sobre una suite autoreconstruida con el escepticismo que invita. La parte mecánica del argumento sobrevive a quien la hace:
Base small models struggle significantly on PAWS (Gemma 3 at 41.2%, Qwen 3.5 at 45.4%)
— m0at, bespokelabsai/nimble issue #3
La razón dada es que el solapamiento de unigramas entre las dos frases supera el 85%, así que un modelo que pesa palabras en vez de su orden casi no tiene de dónde agarrarse. Eso es una afirmación sobre la forma de la tarea, no sobre el producto de nadie, y apunta al mismo subconjunto donde la propia suite de Bespoke registra la derrota significativa del fine-tune.
Using n-gram order sensitivity (specifically trigram Jaccard divergence) reliably discriminates semantic flips without requiring generative rollouts.
— m0at, bespokelabsai/nimble issue #3
Si un estadístico de trigramas sin pesos puede separar los casos en los que se equivoca un modelo de 9B ajustado, la pregunta interesante no es si conviene ser dueño del modelo. Es cuáles de tus decisiones necesitaban un modelo, para empezar.
Dónde se gana su lugar un modelo así
Un modelo de decisión tipada es un clasificador, y los clasificadores son más útiles como paso de enrutado delante de trabajo más lento: decide primero, gasta después. La pregunta del reembolso de arriba es el arquetipo — resuelve "esto está autorizado" en una sola llamada tipada, y deja que la rama que lee documentos, escribe en un libro contable o avisa a un humano corra solo cuando la respuesta lo indique.
Las cifras de Nimble cambian la forma de la decisión de construir o comprar, más que resolverla. Si tu tráfico se parece a alguna de las seis categorías que cubre el holdout, tienes una cifra publicada de la que partir. Si se parece a Home, Science, Software o Workplace, nadie ha publicado una cifra — ni siquiera quienes entrenaron con esas categorías — y tu primer trabajo es un conjunto held-out propio, etiquetado por alguien a quien se le pueda echar la culpa si sale mal. El método de curación se traslada sin fricción. Las etiquetas no se trasladan en absoluto.
Sea cual sea el modelo que acabe tomando la decisión, el flujo de trabajo a su alrededor es el mismo, y vale la pena construirlo para que la ruta barata siga siendo barata. En Latenode eso es sencillo de calcular, porque el medidor cuenta los segundos de CPU que una ejecución realmente consume, no nodos ni llamadas a API, y no hay un mínimo por ejecución — así que una ejecución que clasifica, toma la rama corta y termina cuesta proporcionalmente menos que una que da el rodeo largo. Un nodo de JavaScript puede instalar cualquier librería de NPM, lo que mantiene el trabajo alrededor de una decisión — parseo, validación, la propia rama — como código ordinario en vez de configuración. El nivel gratuito son 10,000 segundos de CPU al mes en 5 workflows activos. Hasta dónde llega eso es una pregunta sobre tu tráfico, no sobre el medidor.
Quién debería clonar esto, y quién no
Clónalo si tienes una superficie de decisión estrecha y estable, y el estómago para etiquetar datos: el activo trasladable aquí es el pipeline de curación, no los pesos, y la escala a la que funcionó fue 2,676 ejemplos en diez categorías y una sola época de 335 actualizaciones del optimizador. Lo que eso costó en horas, el repositorio no lo dice. Clónalo si tu tarea se parece específicamente a puntuar la relevancia de un resumen, porque ahí es donde está la única victoria inequívoca — summeval-relevance, 49.2 frente a 35.0 con p=0.0004 — y es un único conjunto de datos, no una categoría: los otros dos subconjuntos de score son un empate estadístico y una derrota. Clónalo si quieres ver cómo es un modelo de decisión con el paso de datos visible, porque casi nada más en esta ola lo muestra.
Sáltatelo si estás buscando un reemplazo directo de Jev. Va tres puntos por detrás en los dominios para los que se construyó, 6.4 puntos por detrás con p=0.0025 en paws, el subconjunto de paráfrasis adversarial construido igual que sus propios datos de entrenamiento, y los autores te dicen sin rodeos que no esperes generalización. Sáltatelo si el objetivo de despliegue es un portátil: 444 ms de mediana y 981 ms en p95 es un producto distinto de 106 ms en una H100, y la cifra de la H100 se midió sobre 120 ejemplos mientras que todo con lo que se compara se midió sobre 324. Y sáltatelo si no tienes datos etiquetados propios, porque lo que produjo el 90.12% fueron 2,676 ejemplos curados, no un rango de LoRA.
La cifra que vale la pena vigilar no es la brecha de tres puntos. Es si alguien ejecuta esta receta sobre datos que un humano de verdad ha leído, y reporta qué cambia.
Así estaban las cosas el 22 de septiembre de 2026. Los proyectos avanzan rápido: comprueba la fuente antes de confiar en esto.
Preguntas frecuentes
- ¿Bajo qué licencia está Nimble, y qué descargo exactamente?
Apache 2.0. La publicación es un adaptador LoRA de unos 165 MiB, más el tokenizador, el constructor de prompts y código de inferencia de referencia. No es un modelo independiente: tú aportas Qwen3.5-9B, que son otros 18 GB o más, y o bien fusionas el adaptador o lo cargas junto al modelo base.
- ¿Qué hardware y qué configuración usa la ejecución publicada?
Una GPU NVIDIA con soporte BF16; el repositorio informa de pruebas en PyTorch 2.8.0 con CUDA 12.8. Bespoke ajustó en L40S y ejecutó el fit final y la evaluación en una H100. La configuración publicada es LoRA de rango 16, tasa de aprendizaje 5e-5, tamaño de lote 2 con acumulación de gradiente 4, un límite de prompt de 2,048 tokens y semilla aleatoria 17; la guía de entrenamiento fija el máximo de pasos en 1,005 con 101 pasos de calentamiento.
- ¿Puedo ejecutar la inferencia en Apple Silicon?
Sí. El repositorio incluye Apple Silicon vía MLX junto a la ruta CUDA, y la evaluación publicada incluye una ejecución completa de 324 ejemplos en una M5 Pro de 64GB. La restricción práctica es la memoria para el modelo base, no para el adaptador, que es lo bastante pequeño como para ser un detalle menor.
- ¿Puedo apuntar el pipeline de curación a otro modelo generador?
Sí. Los valores por defecto viven en el módulo de perfiles de curación, y se fijan por etapa en lugar de globalmente: los contrastes de entrenamiento y la generación de evaluación usan por defecto modelos distintos, con razonamiento bajo y medio respectivamente. Cambiar cualquiera de los dos implica editar ese módulo, y nada en el repositorio indica qué pasa con las cifras publicadas si lo haces, así que un cambio te deja las mediciones por tu cuenta.
- ¿Haría el mismo trabajo un modelo más grande sin ajustar?
No en esta prueba. Sobre los mismos 324 ejemplos, el Qwen3.8-27B sin ajustar — el triple de parámetros — alcanza 84.88%, 5.25 puntos por debajo del fine-tune de 9B, y la escala cae rápido por debajo de eso: Qwen3.5-4B con 61.42%, Qwen3.5-0.8B con 45.37%, Gemma 3 270M IT con 28.70%. En los dominios para los que se entrenó, 2,676 ejemplos curados compran más que triplicar los pesos — lo cual es cierto para esta receta, y solo es cierto para esos dominios.
- ¿El modelo explica sus respuestas?
No, y es deliberado. La puntuación local ejecuta el modelo una vez por ejemplo, sin muestreo repetido y sin razonamiento escrito. Lo que devuelve es una respuesta tipada más una probabilidad por candidato, que es lo que lo hace lo bastante barato como para sentarse en una ruta caliente, y también lo que no te deja nada que leer cuando se equivoca.