
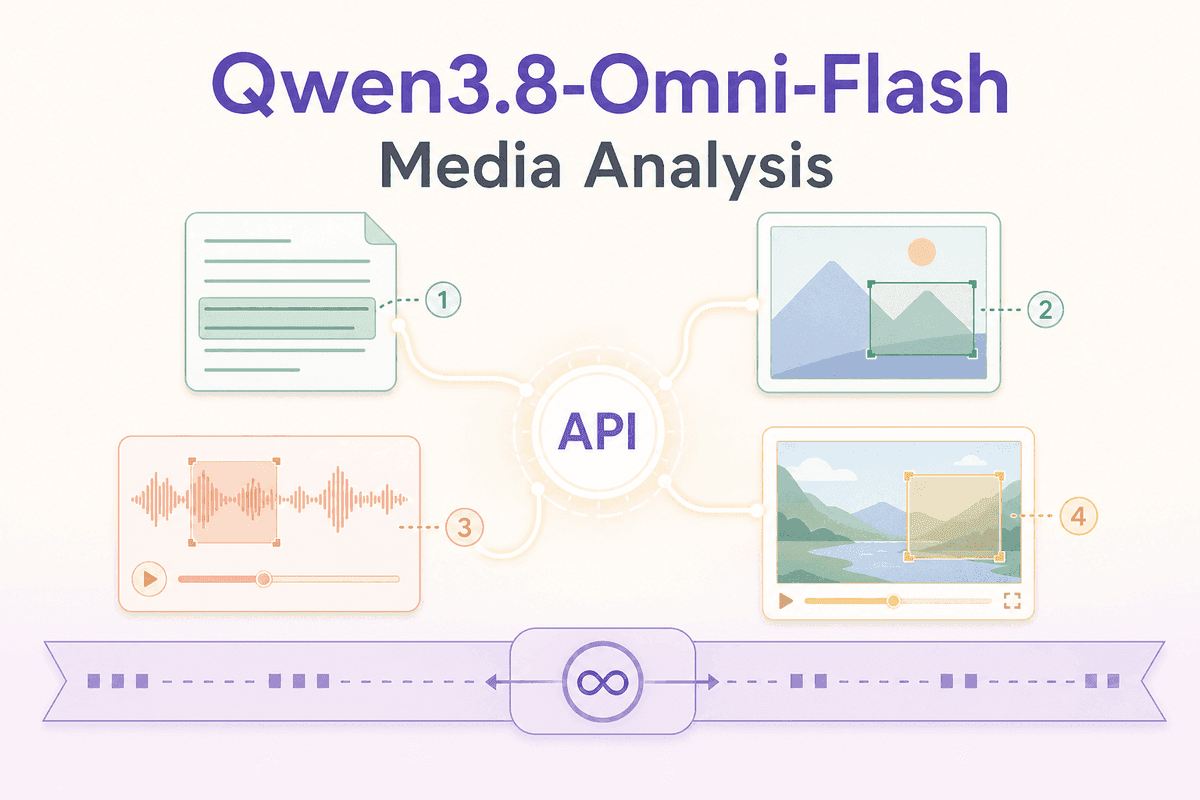
Alibaba Cloud publicó su anuncio de Qwen3.8-Omni-Flash el 20 de septiembre y presentó un modelo multimodal que admite texto, imágenes, audio y vídeo con una ventana de contexto de 1M tokens. La empresa lo posiciona para grabaciones largas y flujos de estilo agente, no solo para chat.
Para quienes desarrollan automatizaciones, la principal novedad es la consolidación de API: Alibaba afirma que el modelo está disponible en Qianwen AI Platform, es compatible con las API Chat Completions y Responses de OpenAI, y puede guiarse con herramientas y un esfuerzo de razonamiento ajustable. Alibaba también plantea su enfoque para vídeos largos en torno a extraer evidencias de segmentos relevantes, en lugar de procesar todo el contenido multimedia de forma uniforme.
Las advertencias son importantes. Las reducciones de costes destacadas por Alibaba se comparan con su propio Qwen3.5-Omni-Plus anterior, no con modelos rivales, y la documentación indica que los precios regionales para contenido multimedia aún deben validarse. El endpoint base también devuelve texto, por lo que los equipos que necesiten respuestas habladas podrían seguir requiriendo una capa de TTS o en tiempo real, como señala la cobertura independiente.