
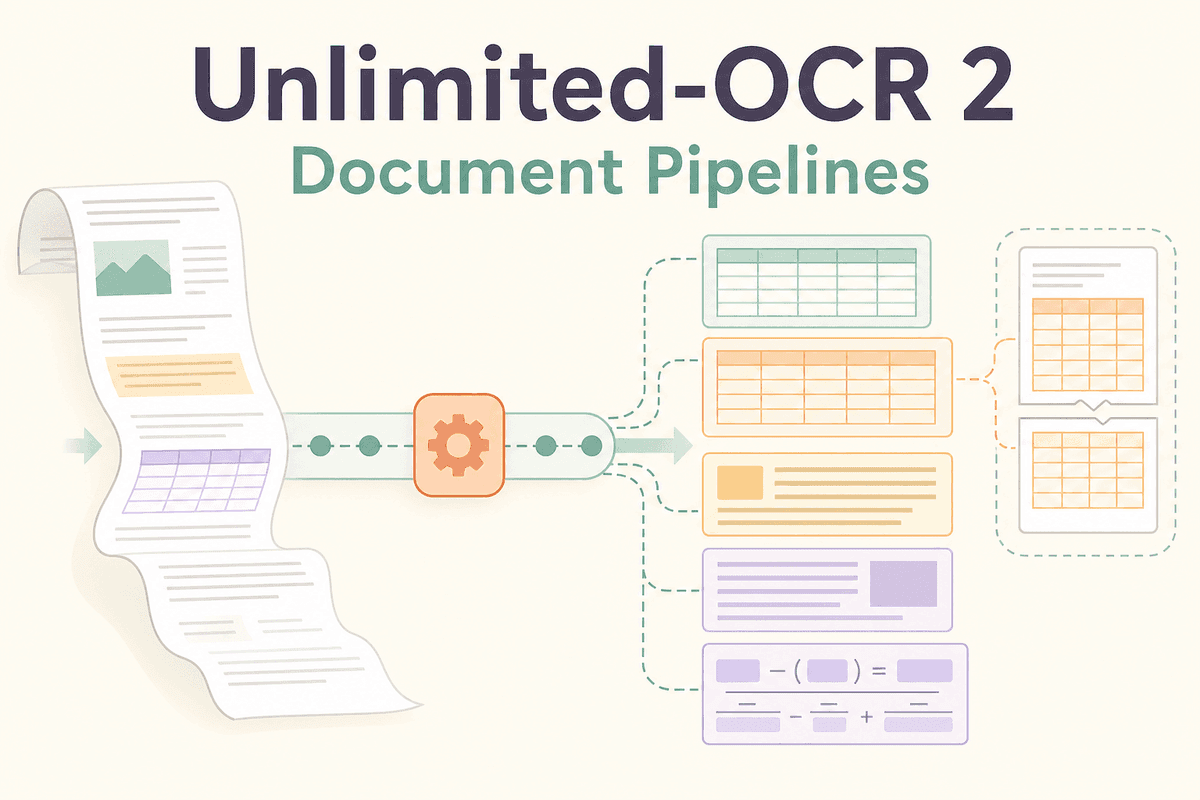
El 2026-10-27, Baidu actualizó su analizador de documentos en la nube para usar Unlimited-OCR 2, lo que pone el modelo para documentos largos a disposición como una API de OCR alojada, en lugar de requerir que los equipos lo desplieguen por su cuenta.
Según la documentación de Baidu Cloud OCR, el servicio admite PDF de hasta 500 páginas y puede devolver resultados analizados como JSON estructurado o Markdown. Baidu afirma que está diseñado para archivos con estructuras complejas, incluida la combinación de tablas entre páginas, la continuidad de párrafos entre páginas, el análisis de jerarquías de títulos y el etiquetado de diseño para elementos como tablas y ecuaciones.
La API utiliza un proceso asíncrono en lugar de una única solicitud bloqueante. Un cliente envía un archivo o una URL, recibe un ID de tarea y luego consulta el estado de finalización antes de obtener los enlaces de resultados. Esto facilita su integración en flujos de automatización que ya separan la ingesta de la extracción o revisión posterior.
En cuanto al modelo, Baidu afirma que Unlimited-OCR 2 utiliza SR-SWA para mantener la latencia de decodificación y el consumo de memoria casi constantes a medida que aumenta la longitud del documento; hay más información en la página del modelo. Para los desarrolladores, el cambio práctico es el acceso: el análisis de PDF largos ahora se ofrece mediante la API gestionada de Baidu Cloud.