
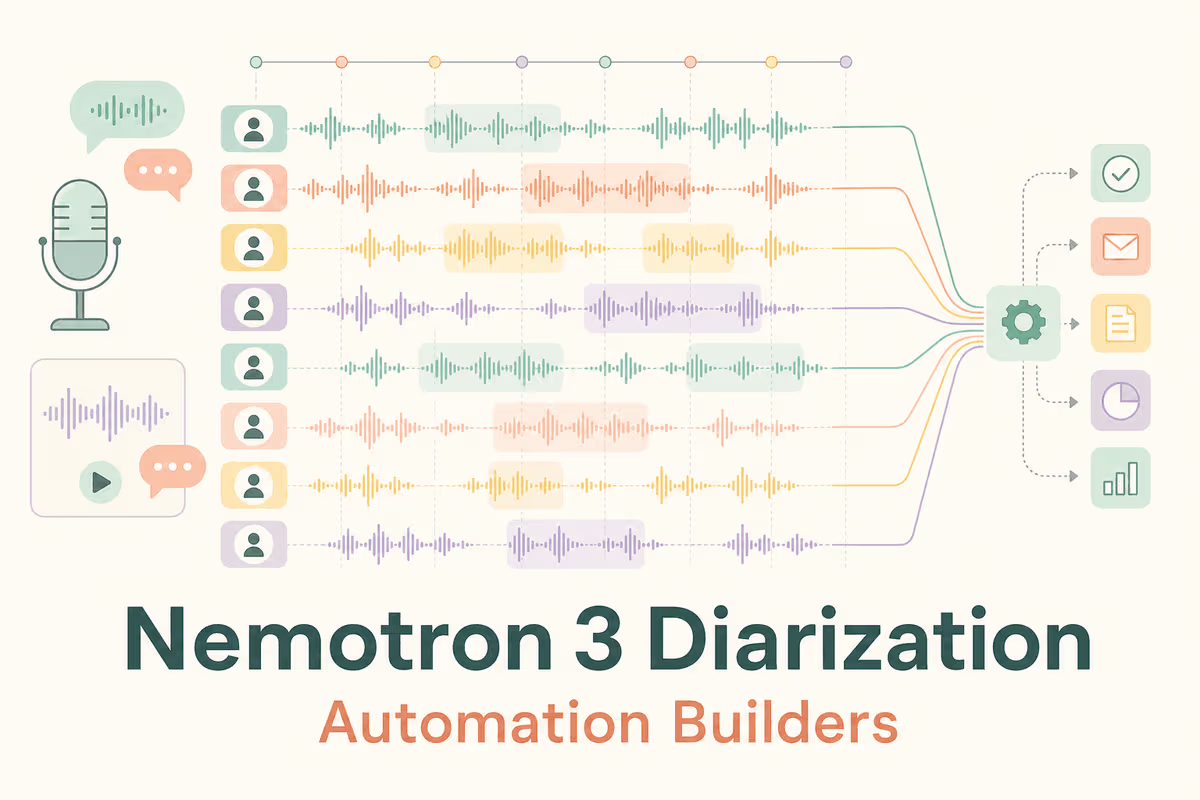
NVIDIA a publié Nemotron 3 Diarization, un modèle audio à poids ouverts destiné à suivre les locuteurs dans des conversations en direct et enregistrées. Selon le billet de lancement, ce modèle d’environ 100 millions de paramètres distingue jusqu’à huit locuteurs, y compris lorsque leurs paroles se chevauchent.
Le modèle renvoie des repères temporels et des étiquettes anonymes de locuteurs, plutôt que des identités ou des transcriptions autonomes. Un même modèle gère le traitement en streaming et hors ligne, tandis que ses poids sont disponibles sur Hugging Face sous OpenMDW 1.1.
Les équipes peuvent associer ses canaux de locuteurs à la reconnaissance automatique de la parole pour les comptes rendus de réunion, l’analyse d’appels et le traitement de podcasts. Elles devront toujours associer les étiquettes à des participants connus et tester la précision sur des fichiers audio bruités ou propres à leur domaine.
La précédente version de Nemotron 3 de NVIDIA concerne sa famille de modèles de langage ; le lancement de la diarisation porte sur un modèle audio distinct.