
DFlash 2 : un drafter à 3.43× qui retombe à 1.45× en charge
Publié le 22 septembre 2026
Un drafter qui devine le bloc entier d'un coup
Le décodage spéculatif a la même forme partout : un petit modèle propose des tokens, le grand modèle les vérifie en une seule passe, et vous gardez ce qui a survécu. L'étape de proposition est restée autorégressive — un token, puis le suivant. DFlash 2 en fait une seule passe :
the entire block, every position, predicted in parallel.
— Inco AI
Un sélecteur léger trace ensuite un chemin cohérent unique à travers les candidats retenus à chaque position, et des convolutions dynamiques à deux prises empêchent le brouillon de se dégrader vers la fin du bloc. Le fournisseur chiffre l'ensemble du dispositif à plus de 20% de sortie supplémentaire par passe de vérification pour environ 1% de latence de cycle ajoutée. Les convolutions sont la partie la moins chère de ce coût : elles ajoutent 0.7% au cycle brouillon-vérification, là où les dix couches Transformer supplémentaires qui achèteraient une précision comparable en ajoutent 15.2%.
Rien de tout cela n'est censé changer ce que dit le modèle :
Decoding is lossless: greedy output matches the target model exactly, and sampling preserves its distribution.
L'argument est donc net. Même texte, moins de secondes. La question est de savoir combien de secondes de moins, et sous quelle charge.
Vieux de cinq semaines, et seulement maintenant digne d'être débattu
Rien de tout cela n'est sorti cette semaine. Inco AI a publié deux drafters DFlash 2 le 18 août, un pour Qwen3.8-27B et un pour Muse Glimmer, et le chiffre qu'elle a mis en avant était un chiffre à requête unique :
SGLang serves at 2.7–3.4× the throughput of autoregressive decoding at batch size 1
— Inco AI
Le drafter est entré dans notre flux le 17 septembre, ce qui est un fait sur le flux et non sur le projet. Ce qui a changé, c'est l'intervalle. L'implémentation vLLM de la méthode a été fusionnée le 21 août — le guide de démarrage rapide de la fiche du modèle vous dit toujours d'installer depuis cette pull request, #52816, ce qui date la fiche plutôt que l'écosystème. Et un drafter entraîné pour Qwen3.8-27B ne pouvait pas être testé en charge avant que ce drafter existe, si bien que toutes les mesures de charge disponibles, y compris la reproduction à concurrency 8 plus bas, sont postérieures à la sortie.
Une chose que le fournisseur a faite au lancement mérite d'être nommée. Il a publié lui-même les tableaux à concurrency 8 et concurrency 32, sur la fiche du modèle, juste sous le titre. La plupart des fournisseurs ne l'auraient pas fait. C'est pour cela que le désaccord porte sur la manière de lire les chiffres plutôt que sur leur existence.
Le désaccord commence dans les propres tableaux du fournisseur
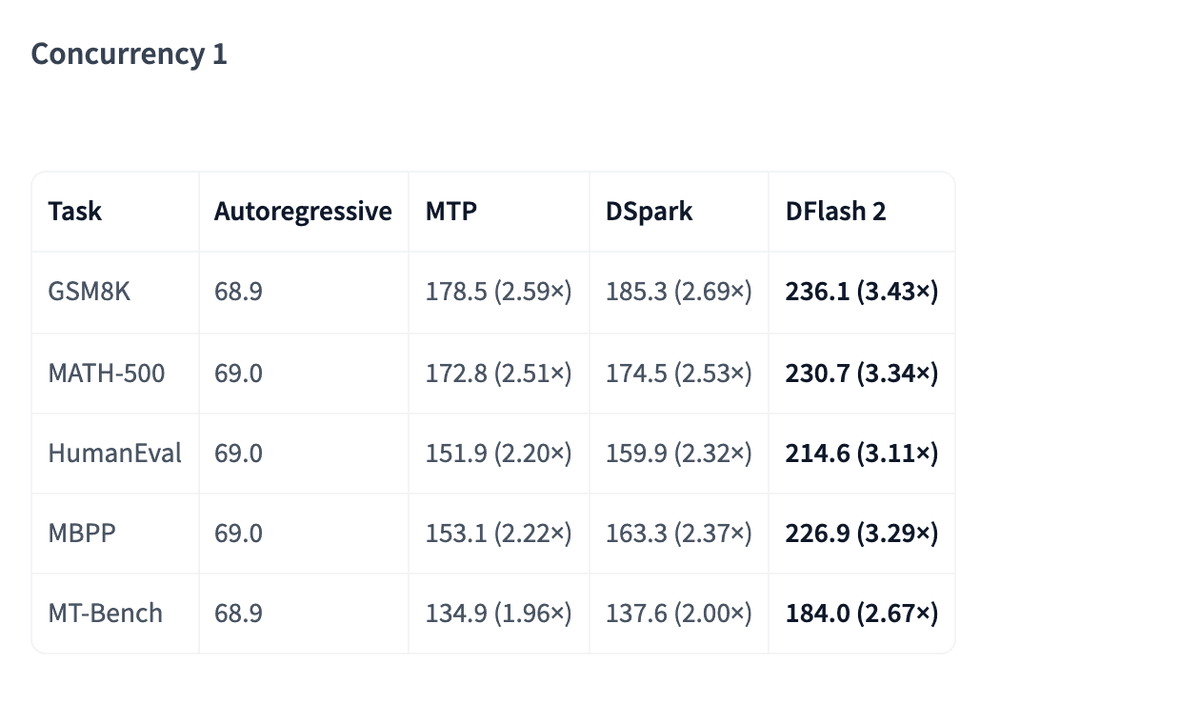
Chaque chiffre de la fiche du modèle provient d'une seule configuration : SGLang sur un unique NVIDIA H200, FlashAttention 3 pour l'attention de la cible comme du brouillon, taille de bloc de spéculation 8. Sous cette configuration, la courbe GSM8K affiche 3.43× à concurrency 1, 2.84× à concurrency 8, et 1.45× à concurrency 32.
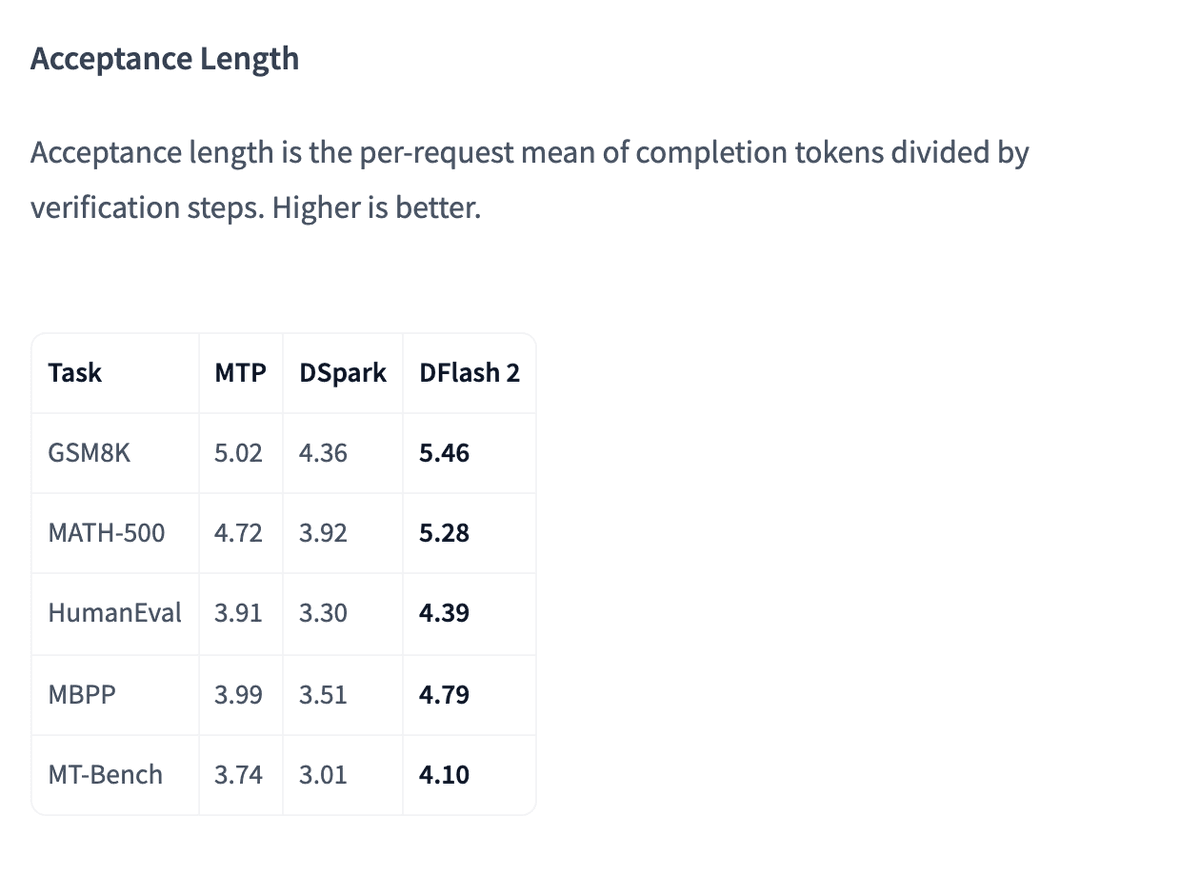
Le type de tâche fait bouger le résultat presque autant que la charge, et la raison est dans le tableau en haut de cette page. La longueur d'acceptation — le nombre de tokens complétés divisé par le nombre d'étapes de vérification — atteint 5.46 sur GSM8K et 4.10 sur MT-Bench. Moins de tokens de brouillon survivent à chaque étape de vérification sur du chat ouvert, donc il y a moins à gagner ; MT-Bench termine ainsi à 1.01× là où GSM8K tient 1.45×.
La dégradation sous charge a une cause distincte, et ce n'est pas un bug. Produire un token déplace beaucoup plus de données de poids qu'il ne fait de calcul, si bien que les multiplieurs d'un GPU restent en grande partie inoccupés pendant ce temps. La spéculation est une façon d'occuper cette capacité inutilisée. Le batching en est une autre, et il n'y a qu'un seul réservoir.
The batch and the draft are drawing on the same account.
Cette mesure a été prise sur AMD RDNA4, pas sur un H200, et l'arithmétique lui est propre : une capacité de brouillon par agent de (24 − batch_size) / batch_size, soit environ 23 tokens de spéculation pour un seul agent et environ 2 chacun une fois que huit tournent en parallèle. Silicium différent, même forme — et c'est la forme que tracent les propres tableaux de la fiche du modèle.
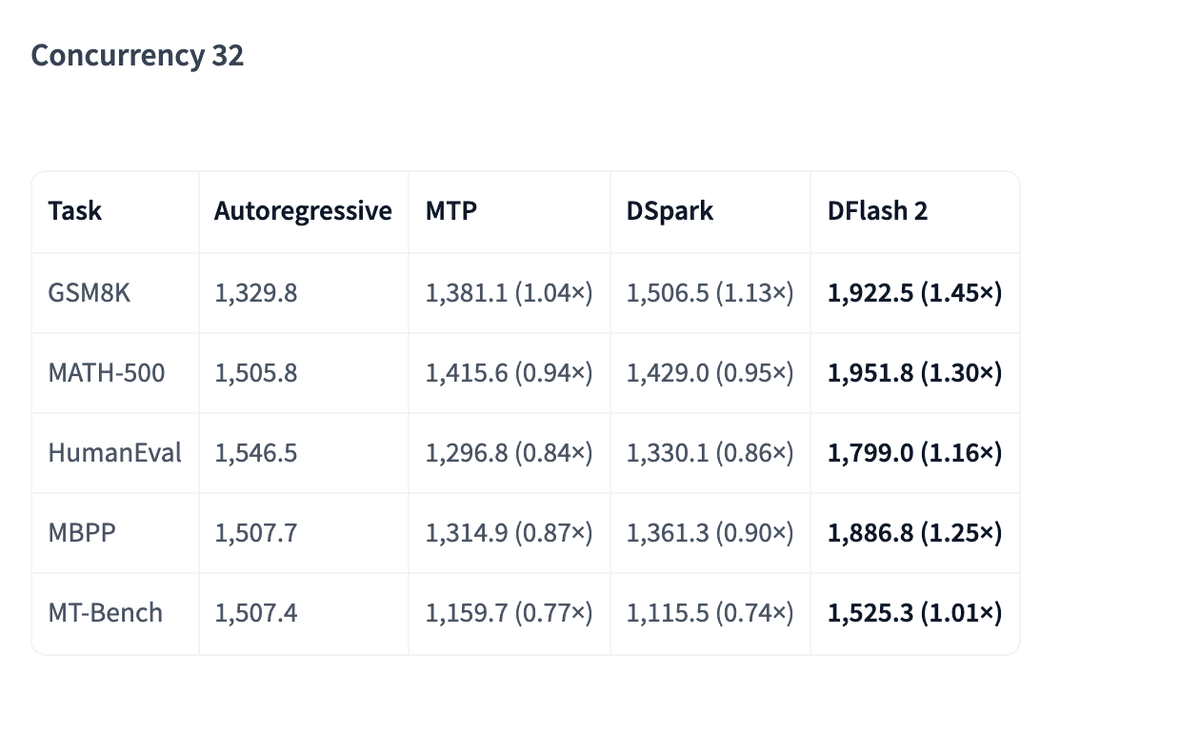
Regardez ce qui arrive aux voisins dans ce même tableau. À concurrency 32, MTP et DSpark passent sous 1.00× sur MATH-500, HumanEval, MBPP et MT-Bench. La spéculation ne se contente pas d'échouer à aider là — elle retire du débit. DFlash 2 reste au-dessus de la ligne de flottaison sur les cinq tâches, ce qui est un vrai résultat — simplement pas celui que tout le monde cite.
Le mode d'échec que cela produit en pratique est un échec de planification, pas un échec technique :
sees 2.5x speedup, ships it — then observes 5% regressions in production where p50 concurrency is 16
— Tian Pan
Deuxième coût, et celui-ci est un problème de correction plutôt que de performance. En faisant tourner la configuration recommandée pour DFlash 2 avec Qwen3.8-27B sur SGLang :
under high concurrent load, sometimes the last user message is appended to the wrong context
L3tum était sur une RTX Pro 6000. Ce qui rend le rapport difficile à écarter, c'est qu'une deuxième personne l'a reproduit sur un matériel différent, puis l'a mesuré : gabrielbryk, sur une DGX Spark face à une cible NVFP4, a relevé 7 réponses fausses sur 100 requêtes à concurrency 8, contre 0 sur 100 en exécutant la même configuration en série et 0 sur 304 avec la spéculation désactivée. En élargissant les cas concernés à un échantillon plus large, le taux d'échec à l'intérieur de ce sous-ensemble atteint 111 sur 304 — le chiffre que l'on cite, et non le taux que verrait votre trafic. À l'intérieur de cet ensemble élargi, remplacer la cible par un lm_head dense en BF16 a fait retomber les échecs de 111 à 1 sans les éliminer, ce qui indique que la dérive se situe dans le chemin de vérification sous composition de lots plutôt que dans un artefact de quantisation. Ce ne sont pas des plantages. Ce sont des réponses bien formées, qui reformulent correctement les contraintes puis répondent à une question différente. Revenir à MTP les a fait cesser. Aucun correctif n'est publié.
Troisième coût, la mémoire. La fiche du modèle indique 2B de paramètres en BF16 pour le drafter et ne les convertit jamais en gigaoctets ni en part du pool du H200.
Spec decode isn't free. You're paying VRAM for both models simultaneously.
Ce billet portait sur un modèle de brouillon de 4B, pas sur DFlash 2, et ce qui est transférable, c'est la comptabilité plutôt que les chiffres : les deux modèles occupent la mémoire en même temps, la pile de service pré-alloue plus que ce que vous aviez estimé, et les deux corrections proposées sont de réduire le modèle de brouillon ou de réduire le parallélisme. Passer à un brouillon de 0.6B y a récupéré environ 2 GiB. Les deux mesures réduisent l'accélération que vous étiez venu chercher.
À la décharge du fournisseur : il a publié la dégradation, il a publié une définition de la longueur d'acceptation contre laquelle vous pouvez vérifier ses tableaux, et il a été honnête sur la manière dont la comparaison a été construite.
We trained the DFlash and DSpark drafters ourselves under matched setups, while MTP ships with the model.
— Inco AI
Lisez cela deux fois. C'est à la fois la divulgation d'une bonne pratique et un avertissement : deux des trois références que DFlash 2 bat sont les propres réimplémentations du fournisseur.
Là où la question de la simultanéité resurgit
La plupart des lecteurs de cet article ne posséderont jamais le GPU sur lequel tourne le drafter. Ce qu'ils possèdent, c'est l'orchestration en amont, et pour eux toute la question se ramène à un seul chiffre : le temps d'horloge murale sur leurs propres prompts, à leur propre niveau de simultanéité. C'est une chose que vous pouvez construire en une après-midi. Prenez les vingt ou trente prompts que votre produit envoie réellement, mettez-les dans un workflow Latenode qui appelle deux endpoints d'un catalogue d'environ 335 modèles, et laissez un nœud JavaScript — qui peut installer n'importe quelle bibliothèque NPM — chronométrer chaque appel et journaliser la paire. Puis arrêtez de le faire tourner une requête à la fois. Déclenchez le workflow en parallèle pour reproduire la charge que vous servez réellement : un plan payant inclut 5 workers d'exécution parallèles, et au-delà la simultanéité est un module complémentaire à 10 $ par worker et par mois — si bien que le niveau de simultanéité de votre test est un chiffre que vous avez choisi et pouvez citer à côté du résultat, exactement ce que font les tableaux du fournisseur et ce que ne font pas la plupart des benchmarks internes. Le compteur de facturation coopère avec l'expérience — Latenode facture les secondes CPU qu'une exécution consomme réellement, pas par nœud ni par appel d'API, sans minimum par exécution, si bien qu'un balayage de quelques centaines d'exécutions courtes coûte les secondes qu'il prend plutôt qu'un tarif fixe par exécution. Il n'y a pas d'intégration DFlash 2 ou SGLang dans Latenode et cet article n'en revendique aucune ; la vitesse du décodeur reste le problème du fournisseur. Ce qui est transférable, c'est la mesure, prise sous votre charge plutôt que sous celle du benchmark.
Qui devrait y consacrer l'après-midi
Faites-le tourner si votre charge de travail ressemble vraiment au benchmark : des générations longues, peu de requêtes en vol, une carte de classe H200, une cible de la famille Qwen3.8, et SGLang ou un vLLM assez récent pour porter la fusion d'août. Traitement de documents en lot pendant la nuit, assistant de code pour un développeur seul, agent interne que personne d'autre ne fait attendre en file. Dans ce régime, les longueurs d'acceptation sont les meilleures des trois drafters sur chaque tâche mesurée, et 3.43× est réel.
Ne le faites pas tourner sur un service partagé ce trimestre. Deux raisons, et la seconde est disqualifiante. L'argument de débit s'amenuise exactement là où vit la production :
Above that, the gains from speculation are consumed by verification overhead at scale.
— Tian Pan
Et sept requêtes sur cent qui renvoient une réponse fausse avec assurance à concurrency 8, là où la même configuration avec la spéculation désactivée n'en renvoie aucune, ce n'est pas un paramètre à régler. Tant que ce ticket n'est pas fermé, la position honnête est que DFlash 2 est un bon drafter avec un bug d'intégration non résolu dans la pile même que son propre guide vous dit d'utiliser.
Si vous évaluez quand même, mesurez deux choses que la fiche ne vous donne pas : la mémoire résidente avec le drafter chargé et vos réglages réels de cache KV, et la précision des réponses à votre simultanéité p50 plutôt qu'à une seule requête. Les deux sont bon marché. Les deux sont les chiffres qui tranchent.
Voici l'état des choses au 22 septembre 2026. Les projets évoluent vite : vérifiez la source avant de vous y fier.
Questions fréquentes
- Outre le H200, de quoi d'autre les chiffres publiés dépendent-ils ?
La taille de bloc est 8, ce qui signifie sept tokens de brouillon par étape de vérification ; l'échantillonnage suit la température 1.0, le top-p 0.95 et le top-k 20 recommandés par Qwen3.8 ; et la sortie est plafonnée à 4 096 tokens. Chaque chiffre de débit et de longueur d'acceptation sur la fiche a été produit sous cette combinaison exacte, si bien qu'un déploiement qui diffère sur l'un de ces points n'est pas comparable tant que vous ne l'avez pas remesuré.
- Puis-je le faire tourner sur vLLM ?
L'implémentation vLLM a été fusionnée le 21 août 2026, si bien que la méthode existe désormais en amont aussi bien sur vLLM que sur SGLang. La fiche n'a pas suivi : son guide de démarrage rapide vous dit toujours d'installer depuis la pull request #52816, qui n'était pas encore fusionnée quand la fiche a été publiée. Vérifiez votre version de vLLM par rapport à la fusion plutôt que de suivre la fiche. Notez aussi que les rapports de correction à concurrency 8 ont été déposés contre SGLang, ce qui signifie que le comportement de vLLM sous la même charge n'est pas mesuré publiquement — ce qui n'est pas la même chose que propre.
- DFlash 2 ne fonctionne-t-il qu'avec Qwen3.8-27B ?
Un drafter DFlash 2 est entraîné contre une seule cible, et deux ont été publiés : celui-ci et un drafter pour Muse Glimmer, pour lequel le fournisseur annonce 3.1–4.6× plutôt que 2.7–3.4×. La sortie d'août couvrait ces deux cibles et aucune autre, et les mesures publiées par le fournisseur ne couvrent que le H200. Associer le drafter à une cible contre laquelle il n'a pas été entraîné n'est pas une option de configuration.
- La sortie est-elle vraiment identique à celle du modèle de base ?
C'est l'affirmation mathématique, et les mathématiques elles-mêmes ne sont pas en cause : le décodage glouton correspond exactement à la cible et l'échantillonnage préserve sa distribution. La question est de savoir si les implémentations la respectent. Les mauvaises réponses à concurrency 8 ressemblent à un échec d'intégration du service, une divergence du chemin de vérification sous composition de lots — mais la personne qui les a mesurées pointe vers un second rapport, z-lab/dflash issue 159, de divergence gloutonne par rapport au décodage autorégressif simple sous MLX, sans SGLang impliqué, et concède qu'une partie du problème pourrait se situer dans le contrat de vérification lui-même. Dans un cas comme dans l'autre, la distinction compte pour ceux qui corrigent le problème et pas du tout pour ceux qui reçoivent la mauvaise réponse.
- Pourquoi certains rapportent-ils des longueurs d'acceptation bien inférieures au 5.46 de la fiche ?
Parce que la longueur d'acceptation est une propriété du déploiement entier, pas du drafter seul. Un rapport ouvert sur le tracker DFlash, z-lab/dflash issue 170, relève environ 3 sur llama.cpp contre environ 5.5 sur vLLM — mais le moteur d'exécution n'est pas la seule chose qui diffère. Les cibles sont des checkpoints différents, un GGUF Q6_K contre un build AWQ MXFP4, et les deux drafters sont eux aussi des quantisations différentes. L'hypothèse principale du rapporteur, énoncée dans le titre de l'issue, pointe l'appariement des cibles plutôt que le moteur. Contrôlez les checkpoints avant d'accuser le moteur d'exécution, et lisez 5.46 comme un chiffre produit par une configuration donnée plutôt que comme un objectif que votre déploiement aurait manqué.