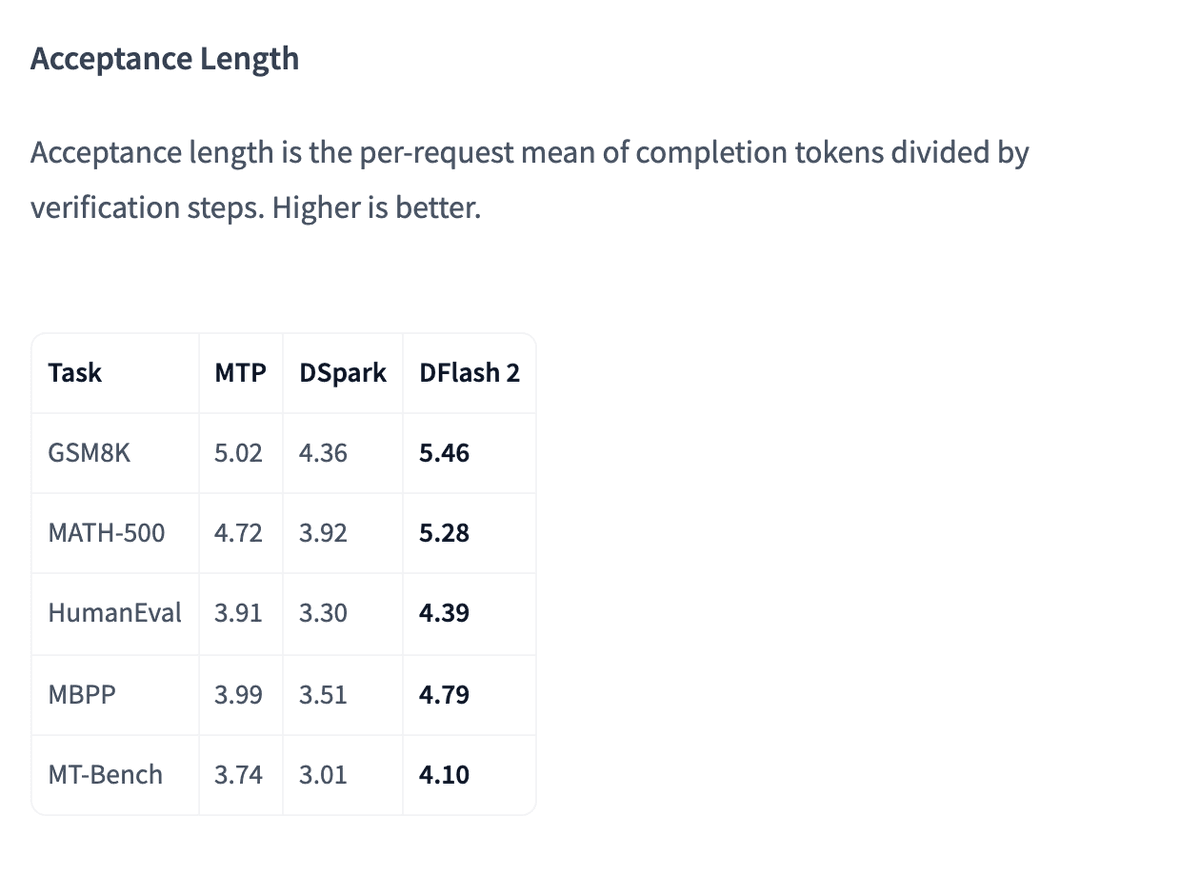
DFlash 2 : un drafter à 3.43× qui retombe à 1.45× en charge
Le drafter à diffusion par blocs d'Inco AI atteint 3.43× sur GSM8K en requête unique, 1.45× à concurrency 32. Voici le prix en mémoire et en variance.

Toutes les analyses publiées, des plus récentes aux plus anciennes.
Le drafter à diffusion par blocs d'Inco AI atteint 3.43× sur GSM8K en requête unique, 1.45× à concurrency 32. Voici le prix en mémoire et en variance.
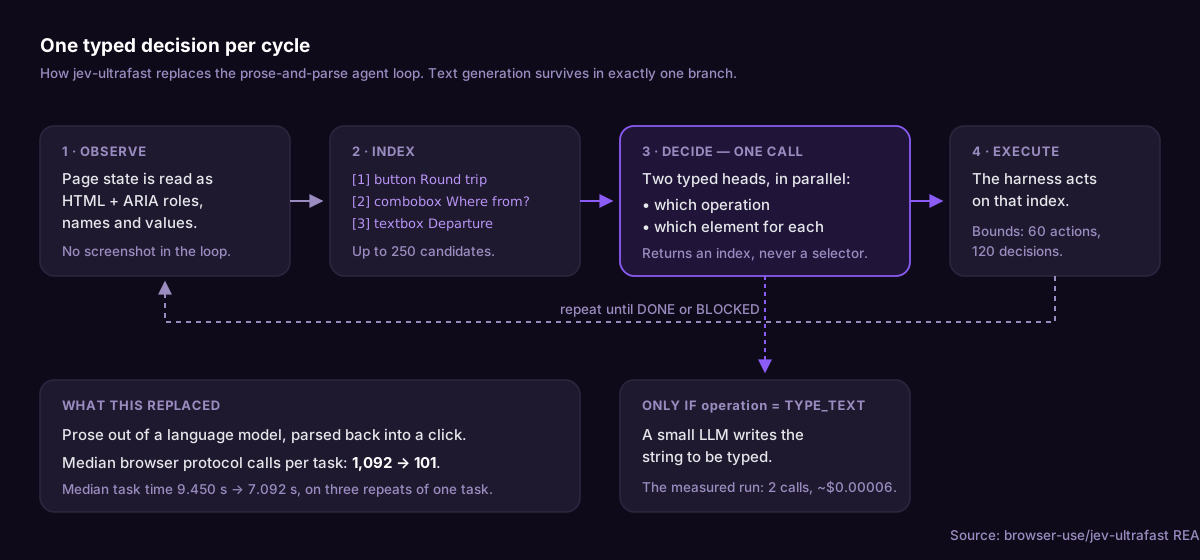
jev-ultrafast de browser-use boucle une recherche Google Flights en 7,1 secondes en remplaçant la boucle agent par une décision typée par cycle. Voici le piège.
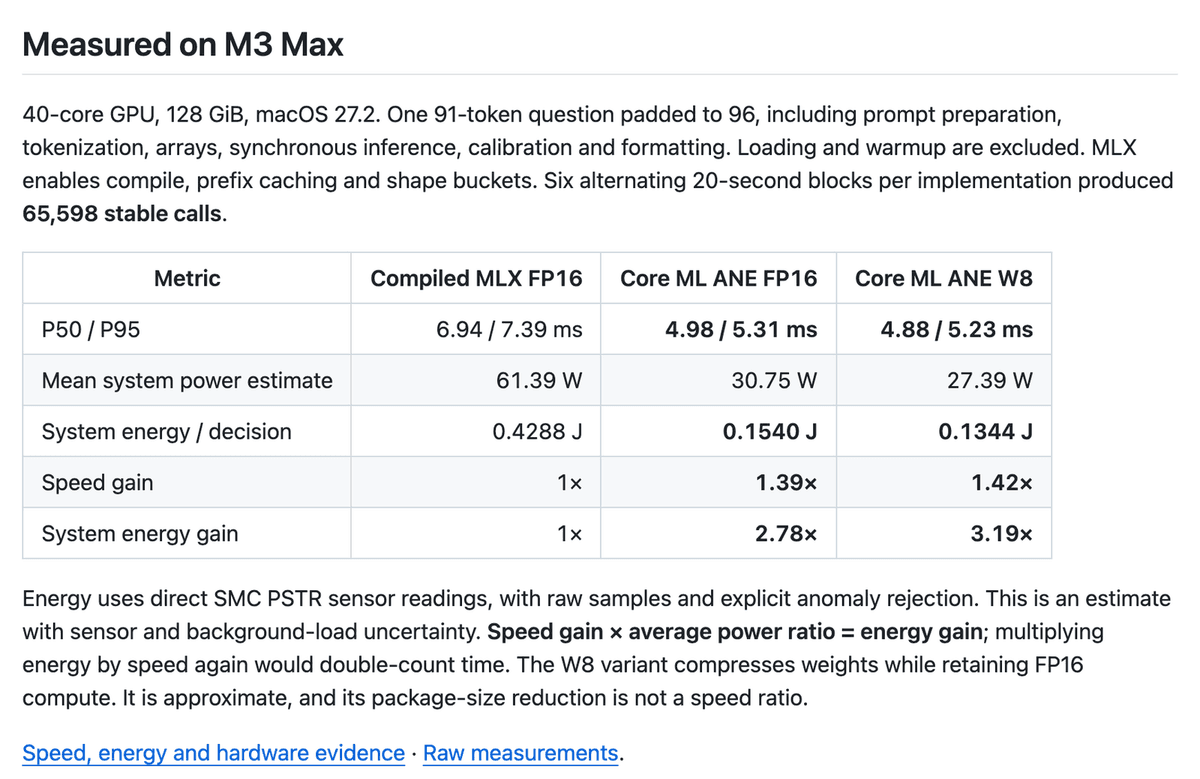
Le portage Core ML de mizorewww exécute une décision typée Laya en 4.98 ms et 0.154 J sur M3 Max. Ce que prouvent les tests de parité, et ce qu'ils ne prouvent pas.
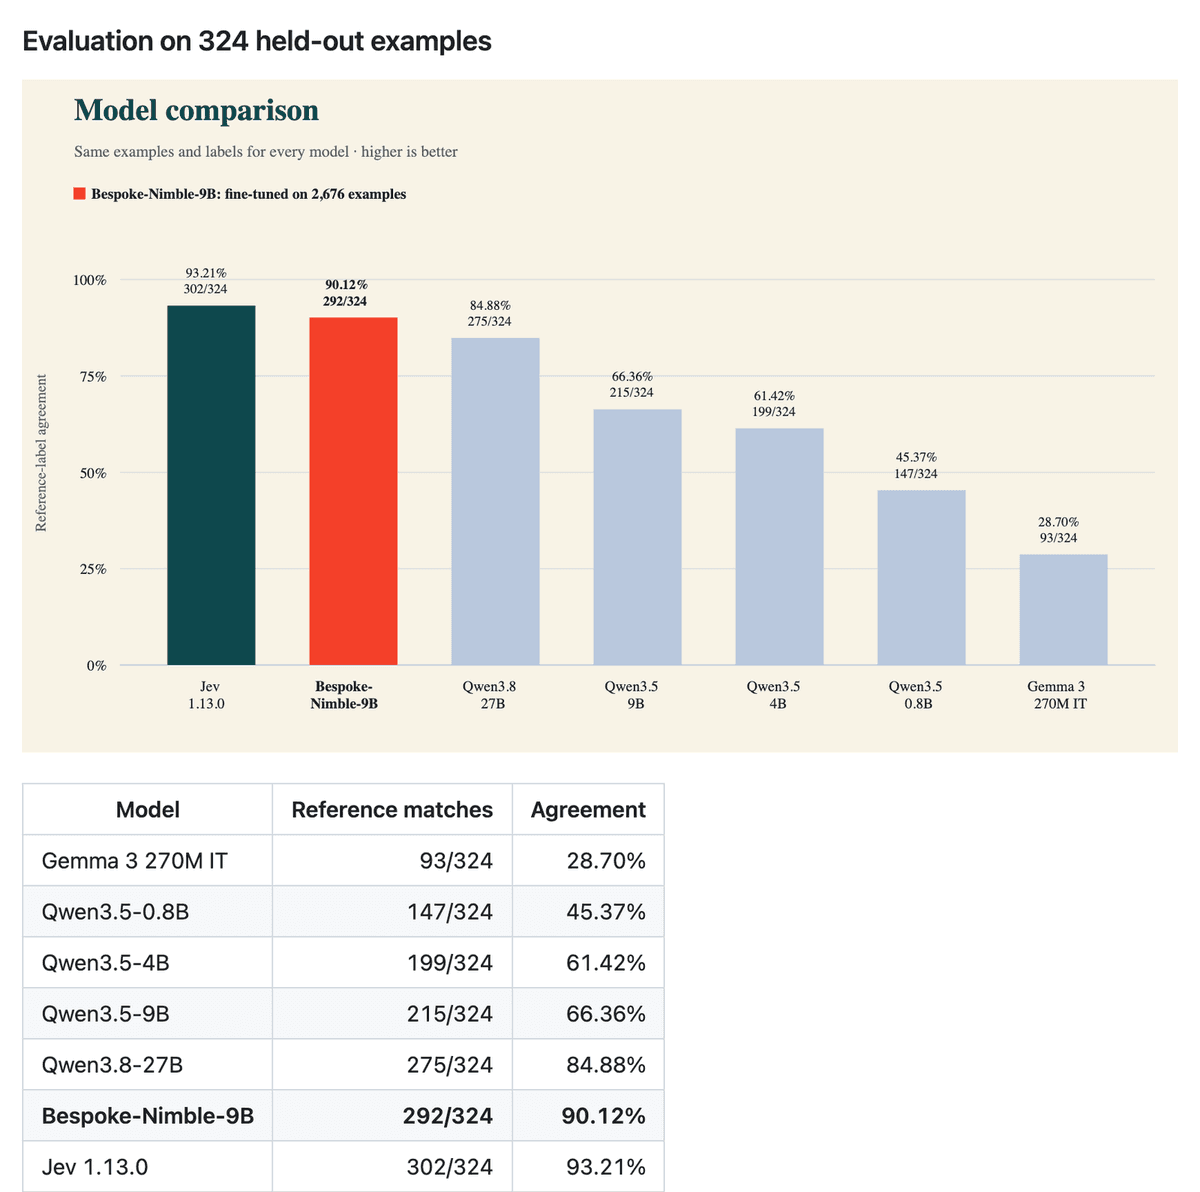
Bespoke Labs a affiné Qwen3.5-9B sur 2,676 exemples synthétiques : 90.12% contre 93.21% pour Jev, une évaluation qui ne couvre que six domaines entraînés sur dix.