
Jev Ultrafast : l'agent qui a arrêté d'écrire du texte
Publié le 22 septembre 2026
Un agent de navigation dont on a retiré la génération
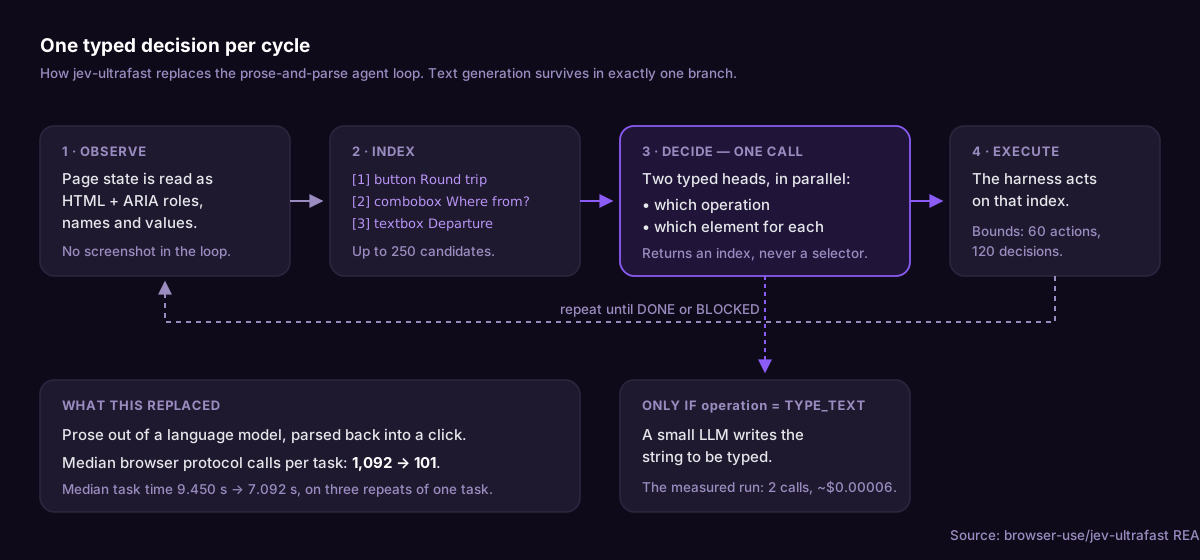
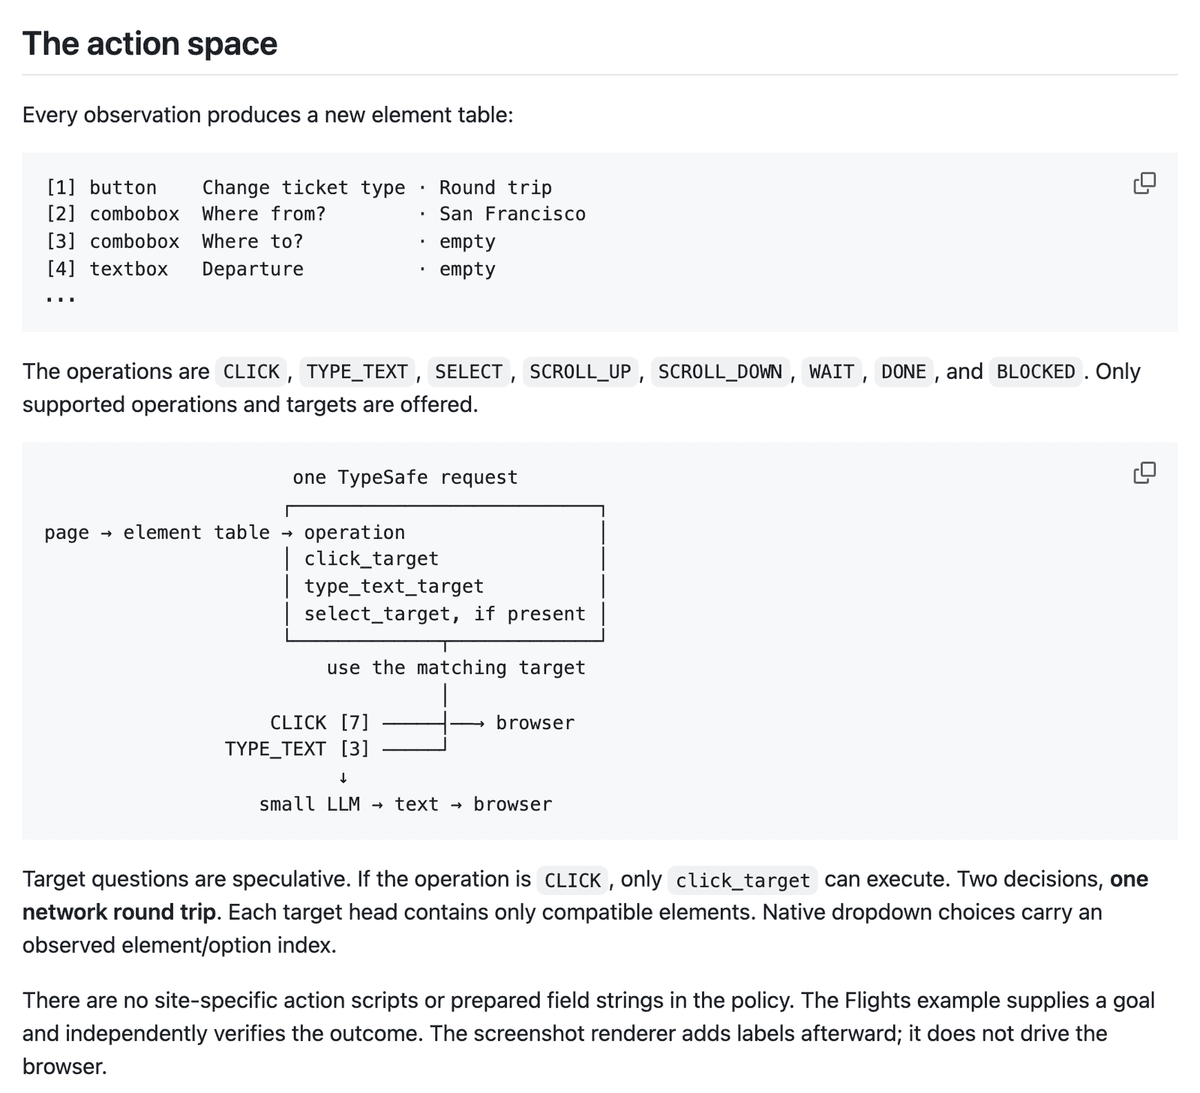
La plupart des agents de navigation fonctionnent en demandant à un modèle de langage, en prose, ce qu'il faut faire ensuite, puis en reconvertissant cette prose en clic. browser-use/jev-ultrafast ne fait pas ça. À chaque observation, il construit une table indexée des éléments accessibles de la page, puis pose au modèle Jev de TypeSafe deux questions typées à la fois : quelle opération, et quel élément pour chaque opération proposée.
One request per decision cycle. Operation and target heads share the same observed state.
— browser-use/jev-ultrafast README
Le vocabulaire d'opérations compte huit éléments : CLICK, TYPE_TEXT, SELECT, SCROLL_UP, SCROLL_DOWN, WAIT, DONE, BLOCKED. Seules les opérations que l'état de page donné prend en charge sont proposées. Rien de ce que renvoie le modèle ne devient jamais un sélecteur, une coordonnée ou du JavaScript exécutable — il renvoie un index dans une table construite par le harnais.
La génération de langage ne survit qu'à un seul endroit :
A small LLM writes text only when the operation is TYPE_TEXT.
— browser-use/jev-ultrafast README
C'est toute la conception. Un classifieur rapide décide, un petit modèle tape, et un exécuteur déterministe valide la cible — fraîcheur du document, géométrie, occlusion du clic — avant de toucher quoi que ce soit.
Pourquoi ça a émergé cette semaine
TypeSafe a ouvert Jev au public le 20 septembre, cinq jours après l'avoir annoncé. jev-ultrafast a été la chose la plus visible construite dessus : environ 17 000 étoiles en une semaine, et le terme jev apparaissant dans 74 noms d'éléments distincts sur ce même flux de sept jours. Ce n'est pas un seul projet qui décolle. C'est un écosystème qui se forme autour d'un modèle sorti avec un argumentaire inhabituel :
Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out.
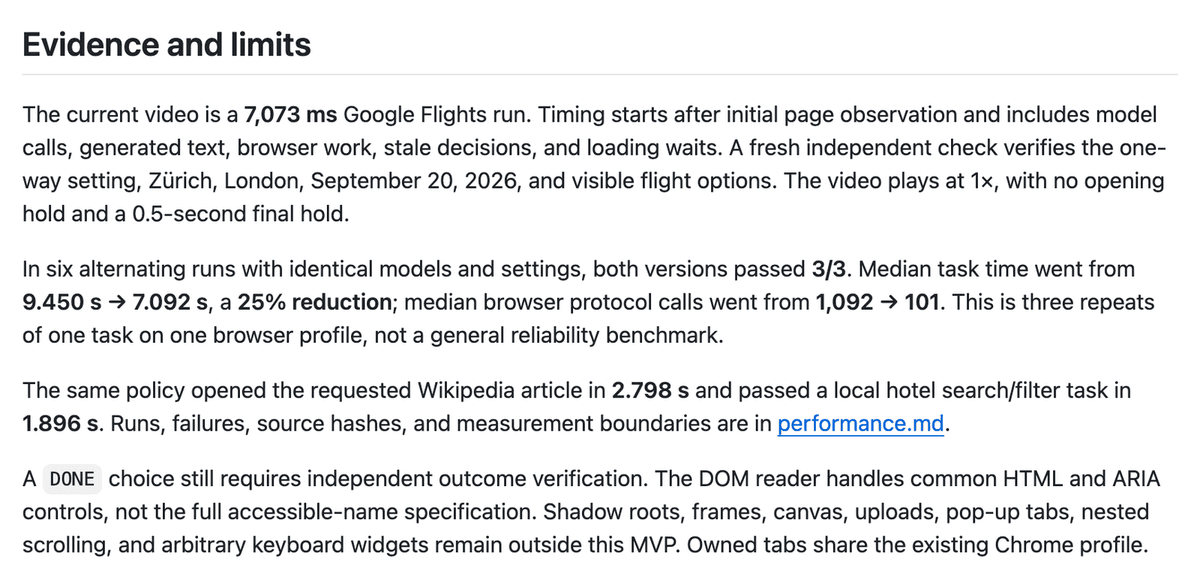
L'agent est la démonstration que cet argumentaire survit au contact de quelque chose de désordonné. Son propre fichier de mesures rapporte qu'une recherche Zurich-Londres sur Google Flights s'est terminée en 7,1 secondes de bout en bout, chargements de page compris et texte tapé par le modèle dans les champs inclus. Face à l'architecture précédente du projet :
Median task time went from 9.450 s → 7.092 s, a 25% reduction; median browser protocol calls went from 1,092 → 101.
— browser-use/jev-ultrafast README
Les 25 % font le titre. La chute par dix du nombre d'appels au protocole du navigateur est le chiffre intéressant, car c'est la partie qui passe à l'échelle : moins d'allers-retours par décision, et le coût de faire tourner cent sessions en parallèle baisse avec.
Ce dont on discute vraiment
Personne n'a publié de critique de cet agent. Il est entré dans le flux de cette semaine le 16 septembre, compte un seul contributeur, aucune release publiée et des commits vieux de cinq jours, et les seules mesures publiques à son sujet sont les siennes. Ce qui est honnête à signaler, c'est que le débat se situe un niveau en dessous, sur le modèle sur lequel l'agent est construit — et que l'essentiel de ce débat s'y applique aussi.
Le projet est étonnamment franc sur les limites de ses propres chiffres :
This is three repeats of one task on one browser profile, not a general reliability benchmark.
— browser-use/jev-ultrafast README
L'annonce de TypeSafe fait une affirmation forte sur l'architecture : parce que Jev abandonne entièrement la génération de chaînes de caractères et renvoie une valeur issue d'un schéma, il ne peut pas halluciner. Les propres graphiques du fournisseur situent cela à zéro sur ses deux mesures d'erreur :
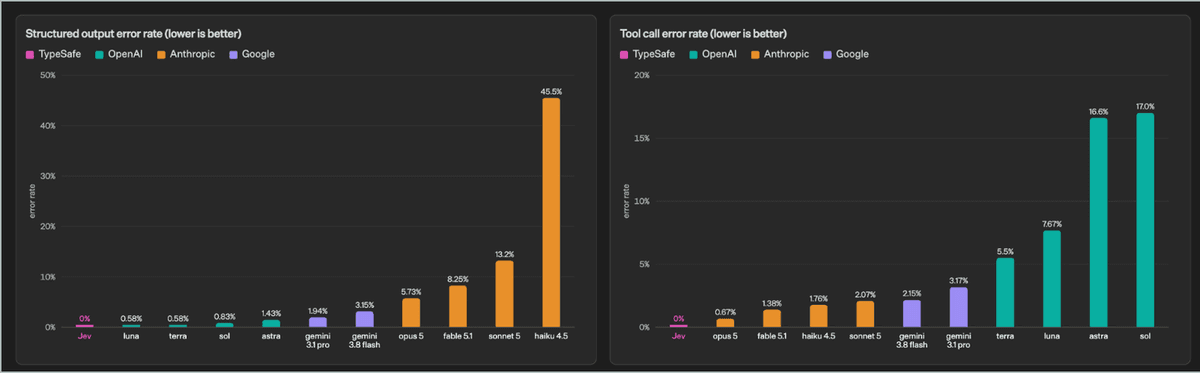
L'objection la plus acérée à Jev porte sur ce que vaut réellement cette garantie :
"Zero hallucination" = schema guarantee, not correctness guarantee — understand this distinction before building.
Cela retombe directement sur l'agent. Son opération DONE est une décision typée comme une autre, et le README concède qu'un choix DONE nécessite tout de même une vérification indépendante du résultat. Un DONE bien formé mais faux ressemble exactement à un DONE bien formé et juste.
L'évaluation indépendante de Jev vient tout juste de commencer. Le projet jev-capability-atlas a fait tourner Jev et la famille Laya sur des entrées identiques pour la première fois, et a constaté que le compromis est réel dans les deux sens :
Laya's fine-tuned specialist does beat Jev by 3 points on its own training distribution
— Zaious, jev-capability-atlas
— mais avec une erreur de calibration cinq fois supérieure, et en dessous d'une base de référence aveugle aux entrées une fois sorti de sa propre distribution, où les mêmes testeurs ont trouvé Laya très en retard en chinois. Jev a son propre problème de langue : TypeSafe indique que Jev est moins précis en CJK, et l'atlas a cherché à le mesurer plutôt que de le prendre pour argent comptant. Sur la relecture du chinois, il a détecté 67 % des caractères erronés à un seuil de confiance de 0,5, avec un taux de fausses alertes de 12 % sur le jeu SIGHAN. Relever le seuil à 0,7 a fait baisser les fausses alertes à 5 % et le taux de détection à 38 %. Et il y a une réserve commerciale attachée à l'argument du coût dont dépend l'économie de l'agent :
vendor says it can't prove the price isn't subsidized — treat it as today's price.
Une dernière objection vient d'un projet frère plutôt que de celui-ci : un testeur sur jaredpalmer/kev a trouvé un modèle à décision typée qui gérait correctement la comparaison de seuils et le mappage ordinal, mais qui ne savait pas soustraire deux dates, et l'a corrigé en mettant le nombre de jours directement dans l'état plutôt qu'en le demandant. Modèle différent, même leçon. Les décisions typées ne valent que ce qu'on leur donne.
Où cela s'insère dans un pipeline
Le schéma qui mérite d'être repris n'est pas le modèle. C'est la séparation : faire le travail déterministe de façon déterministe, et ne dépenser un appel modèle que sur la seule étape qui a réellement besoin de jugement. C'est pour ça que le nombre d'appels au protocole a chuté d'un ordre de grandeur — l'essentiel de ce que fait une boucle d'agent n'a jamais été un problème de raisonnement.
Vous pouvez construire cette forme dès aujourd'hui dans Latenode sans aucune des pièces ci-dessus. Le navigateur headless cloud vous donne Puppeteer complet, si bien que navigation, attentes, remplissage de formulaires et extraction sont du code qui fait la même chose à chaque exécution, sur des navigateurs que vous n'avez pas à installer, patcher ou maintenir en vie. Le nombre de ces exécutions menées de front est un plafond à dimensionner plutôt qu'une variable libre : cette quantité s'appelle max execution workers, le nombre d'exécutions de workflow qu'un workspace peut traiter simultanément. Un plan payant en inclut cinq, et au-delà la concurrence est un module complémentaire de workers réservés à 10 $ par worker et par mois. Traitez mille pages en lot et elles font la queue derrière ce nombre. Autour de cela, un nœud JavaScript avec le registre NPM gère l'état et la validation, et vous n'appelez un modèle — depuis le catalogue sur /ai-models — qu'à l'embranchement où la page est réellement ambiguë. Le modèle de facturation récompense la même séparation. Latenode mesure les secondes CPU qu'une exécution consomme réellement, sans minimum facturable par exécution, si bien qu'une tâche qui se termine en 7,1 secondes plutôt qu'en 9,5 coûte bel et bien moins cher — proportionnellement, et l'écart se cumule à l'échelle d'un lot. Le mécanisme mérite d'être formulé avec précision, car il est facile de l'inverser : le compteur facture le temps d'exécution, pas les appels. Mille allers-retours de navigateur coûtent mille opérations facturables sur une plateforme facturée à l'opération ; ici, ils coûtent le temps qu'ils prennent, si bien qu'une boucle d'agent bavarde n'est coûteuse qu'à proportion de sa lenteur. Il n'y a pas d'intégration Jev dans Latenode, et cet article n'en revendique aucune ; ce qui vaut la peine d'être importé, c'est l'architecture.
Qui devrait y consacrer du temps
Lisez le document de conception si vous construisez de l'automatisation de navigateur. L'idée que l'espace des actions doit être énuméré par le harnais et simplement indexé par le modèle mérite une heure de votre temps, que vous appeliez un jour TypeSafe ou non.
Ne le mettez pas en production ce trimestre. Sa liste de cas non pris en charge est rédhibitoire pour la plupart des sites réels :
Shadow roots, frames, canvas, uploads, pop-up tabs, nested scrolling, and arbitrary keyboard widgets remain outside this MVP.
— browser-use/jev-ultrafast README
Tout ce qui se trouve derrière une iframe — formulaires de paiement, sélecteurs intégrés, la plupart des parcours de consentement — est exclu. Tout upload aussi. Ajoutez à cela une dépendance à un fournisseur unique pour une API en accès anticipé dont le fournisseur lui-même ne veut pas qualifier le prix de définitif, aucune release taguée, et un historique de succès de trois tâches, et le risque saute aux yeux.
Les personnes qui devraient l'exécuter dès maintenant sont celles capables de le mesurer : une suite de tâches à vous, sur vos propres pages, publiée publiquement. C'est ce qui manque à cet écosystème, et c'est peu coûteux à produire.
Voici l'état des choses au 22 septembre 2026. Les projets évoluent vite : vérifiez la source avant de vous y fier.
Questions fréquentes
- Faut-il un compte TypeSafe pour exécuter jev-ultrafast ?
Oui. L'agent a besoin de TYPESAFE_API_KEY pour le modèle de décision et d'une TEXT_MODEL_API_KEY distincte pour le petit modèle rédacteur. La configuration d'exemple pointe la seconde clé vers OpenRouter et le modèle inception/mercury-2.5, avec le raisonnement désactivé, mais Gemini, GLM ou DeepSeek fonctionnent via le même assistant compatible OpenAI.
- L'agent regarde-t-il des captures d'écran de la page ?
Pas dans la boucle par défaut. Il lit un état structuré - rôles ARIA, HTML, noms, valeurs et texte visible - et construit une table indexée d'éléments candidats. Les captures d'écran apparaissent dans l'inspecteur local pour les humains, pas dans le chemin de décision.
- Combien de temps une seule exécution peut-elle durer ?
Soixante actions du navigateur et 120 requêtes de décision, selon ce qui arrive en premier. Jusqu'à 250 candidats d'action sont conservés par observation, et tout ce qui est tronqué au-delà ne peut plus être sélectionné du tout - ce qui est un véritable mode d'échec sur des pages très longues.
- Comment figer une version de quelque chose qui n'a pas de releases ?
Vous figez un hash de commit, ce qui signifie que vous assumez entièrement la décision de mise à jour. Il n'y a pas de notes de version à lire, pas de signal de version sémantique indiquant qu'un changement casse la compatibilité, et pas de tag vers lequel revenir - prévoyez donc de lire le diff vous-même à chaque mise à jour, et vendorez la dépendance si un changement silencieux en amont risque de faire mal.
- Combien coûte une décision ?
TypeSafe affiche l'entrée à 0,042 $ par million de tokens, la sortie étant gratuite. L'exécution mesurée sur Google Flights a également dépensé environ 0,00006 $ pour deux appels au petit modèle de texte, si bien qu'à cette échelle le temps de navigateur coûte plus cher que l'inférence.