
Laya sur le Neural Engine : 4.98 ms et 0.154 J par décision
Publié le 22 septembre 2026
Une décision au prix des millisecondes et des joules
mizorewww/laya-coreml prend les checkpoints de décision typée de Laya, les convertit en Core ML, et les exécute sur l'Apple Neural Engine. Le résultat de ce travail n'est pas une nouvelle capacité. C'est une liste de prix.
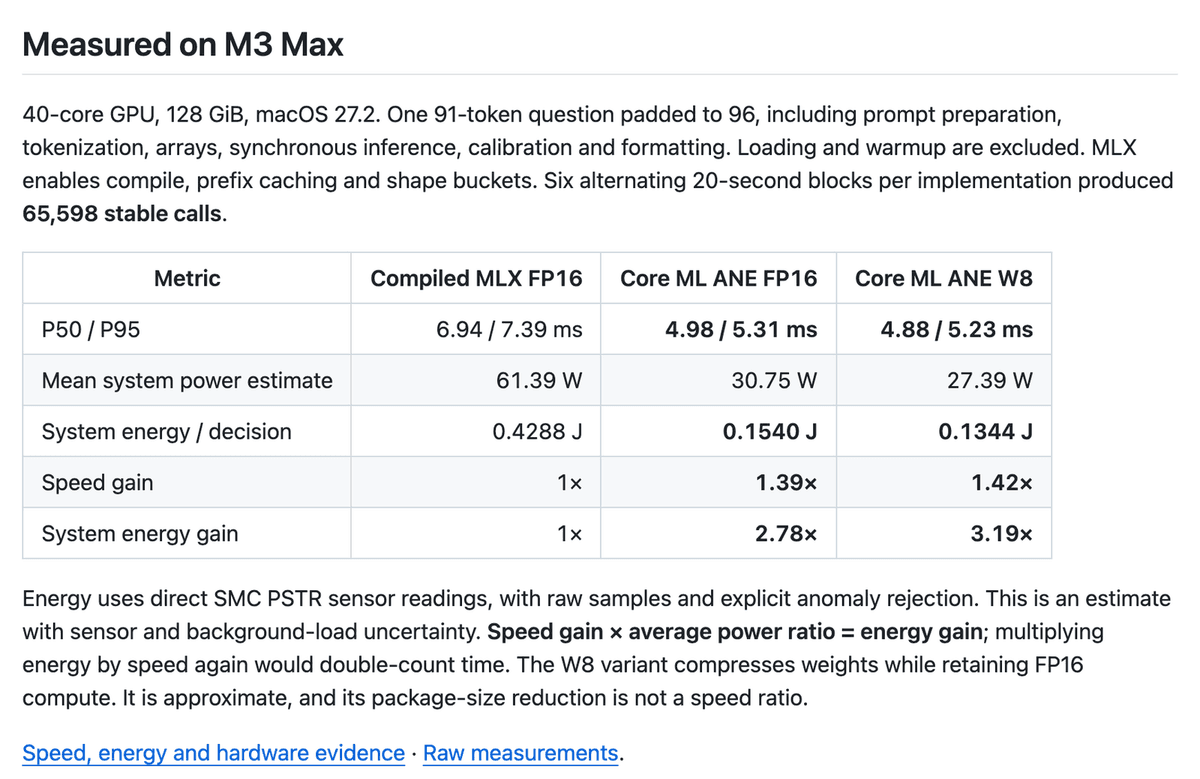
One short multilingual decision: 4.98 ms P50 / 5.31 ms P95 on M3 Max with ANE FP16.
Le même tableau situe le MLX FP16 compilé à 6.94 / 7.39 ms, et l'énergie par décision à 0.1540 J pour l'ANE contre 0.4288 J pour MLX — une amélioration de 2.78× sur 65,598 appels stables, l'énergie étant mesurée par le capteur SMC PSTR plutôt que modélisée. Dix mille décisions sur le Neural Engine, c'est environ 1.5 kJ, soit 0.43 Wh. C'est un chiffre sur lequel on peut budgéter, et c'est la raison d'être de ce portage plutôt qu'un simple wrapper de plus.
Lisez toutefois les conditions du test avant de le dépenser.
One 91-token question padded to 96, including prompt preparation, tokenization, arrays, synchronous inference, calibration and formatting.
La question fait 91 tokens ; le padding porte le tenseur à 96 ; et 96, c'est tout le budget. La limite totale du bundle ANE est de 96 tokens, en comptant la question, les options et tout état porté, et une requête plus longue déclenche une erreur de capacité. Le chiffre phare est donc mesuré avec la boîte pleine — la bonne façon de le mesurer, et aussi un avertissement : il n'y a pas de marge à trouver plus tard.
Ce qu'il y a dans la boîte compte plus que les millisecondes, et c'est le point à vérifier avant de porter quoi que ce soit.
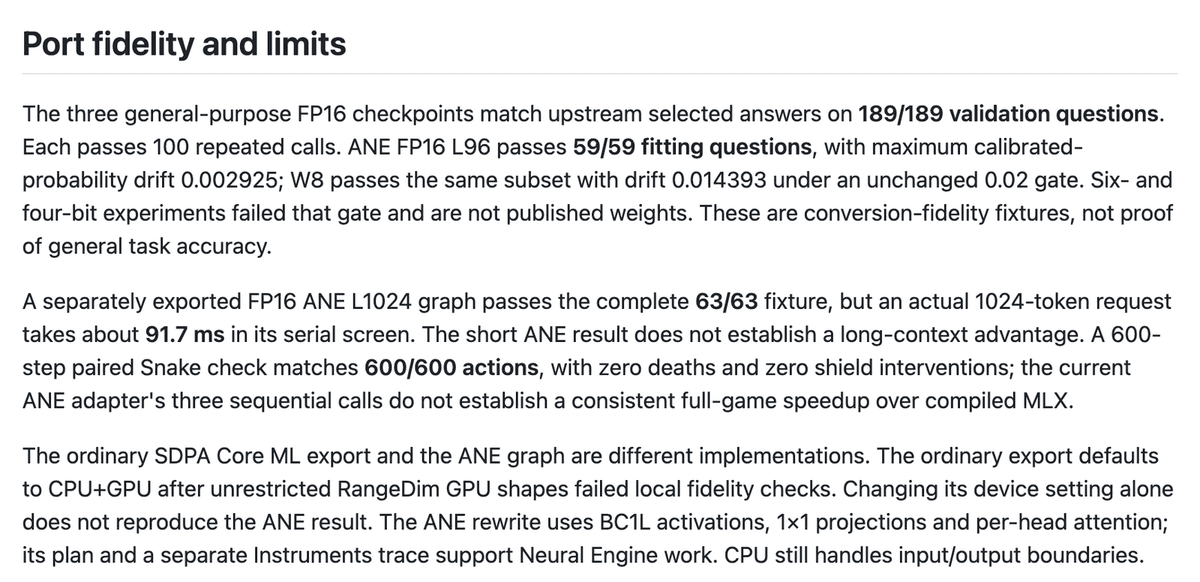
The three general-purpose FP16 checkpoints match upstream selected answers on 189/189 validation questions. Each passes 100 repeated calls.
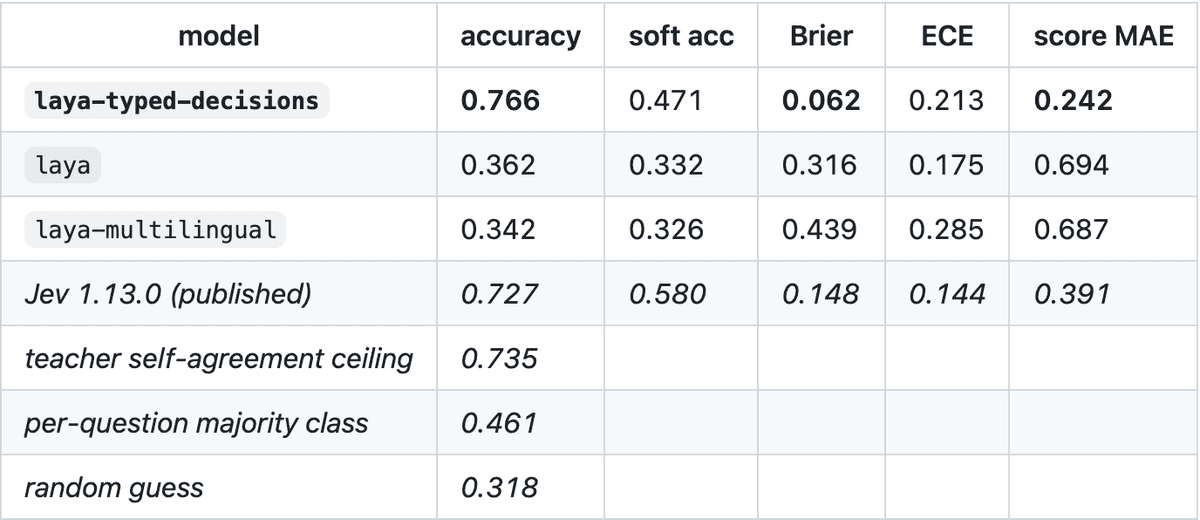
Généraliste est le mot qui compte. Sur le benchmark de décisions typées en amont, les checkpoints généralistes obtiennent 0.362 et 0.342, sous le 0.461 atteint par une estimation de classe majoritaire par question ; le 0.766 qui fait paraître Laya solide appartient à un fine-tune spécifique à la tâche. Ce qu'aucune page, ni d'un côté ni de l'autre, ne rapporte, c'est un chiffre de précision pour le bundle qui a produit les 4.98 ms. La latence est mesurée par bundle ; la précision est mesurée par checkpoint en amont ; personne ne relie les deux colonnes.
C'est la boucle qui doit être bon marché
Huit dépôts portent le nom Laya dans le flux de cette semaine, et les deux avec des mesures attachées sont des portages runtime du même auteur : un runtime MLX, puis celui-ci en Core ML. Aucun des deux n'ajoute de capacité au modèle. Tous deux existent pour rendre une décision assez bon marché pour tenir dans une boucle qui l'exécutera des milliers de fois — le propre test de bout en bout du portage est une partie de Snake à 600 étapes, comparée action par action au build MLX.
C'est la prémisse sur laquelle agit ce groupe de projets : qu'un aller-retour réseau ne tient pas dans une frame. Il vaut la peine de la nommer comme une prémisse, car personne ici n'a publié le chronométrage de l'alternative hébergée à côté du sien. Ce que laya-coreml a publié, c'est l'autre moitié du budget, celle que presque personne ne mesure.
A separately validated W8 palette variant reached 4.88 ms and 3.19× energy improvement.
Le même paragraphe précise qu'il s'agit de résultats sur une seule question et non de temps de frame Snake complets, et que le gain par dix que le travail cherchait à obtenir n'a pas été atteint. Deux développeurs qui ont tenté le même geste sur d'autres runtimes ont ensuite publié des mesures sur un axe entièrement différent : non pas la vitesse à laquelle le modèle converti répond, mais si la réponse et la confiance qui l'accompagne survivent à la conversion.
Les tests de parité prouvent que la réponse n'a pas changé, pas qu'elle était juste
La validation du portage est approfondie et inhabituellement claire sur son propre périmètre. Le build ANE FP16 passe 59 des 59 questions d'ajustement avec une dérive de probabilité calibrée maximale de 0.002925 ; W8 passe le même sous-ensemble à 0.014393 face à un seuil inchangé de 0.02 ; les expériences en six et quatre bits ont échoué à ce seuil et n'ont jamais été publiées comme poids. Et puis, dans le même paragraphe :
These are conversion-fidelity fixtures, not proof of general task accuracy.
C'est exactement là que retombent les critiques. Sur Hugging Face, l'auteur d'un portage web quantifié rapporte ce qui se passe quand on se tourne vers la compression évidente :
Ordinary dynamic INT8 destroys this model. onnxruntime.quantization.quantize_dynamic drops argmax agreement to 69% with a worst-case probability shift of 0.99.
— nvkudva, laya-web-q8 model card
Quantifier uniquement les MatMuls est catastrophique alors que quantifier uniquement les embeddings s'en sort, ce qui pointe vers des valeurs aberrantes d'activation plutôt que vers la précision des poids. Un développeur travaillant le même problème dans un portage navigateur a résumé le compromis en une ligne :
The difference is the quantization scheme, not the checkpoint, and it is also where the twentyfold speed difference comes from.
— a-voronkov, laya-web-poc PR #16
La calibration est la deuxième faille, et c'est un problème de séquencement plutôt qu'un bug de quantification :
The shipped temperatures were fitted by the original author, not refitted after quantization.
— nvkudva, laya-web-q8 model card
L'amont confirme l'ampleur du phénomène, dans son propre README :
Refitting one temperature per (question type, option count) on held-out data moves mean ECE 0.466 -> 0.081 (laya) and 0.314 -> 0.106 (laya-multilingual).
Le portage Core ML a déjà repéré un cas où cela tourne mal : une température livrée de 0.1006 pour le lot à onze options ou plus, assez extrême pour présenter un pile-ou-face comme une quasi-certitude, désormais écrêtée avec un avertissement nommé au chargement. Un test qui compare les probabilités de deux modèles ne peut pas voir une erreur dont ils héritent tous les deux.
La troisième objection ne touche jamais au silicium. Elle vise le routeur qui choisit quel checkpoint le silicium exécute.
128/200 German utterances (64%) went to the English checkpoint.
Une estimation de langue indécise est traitée comme de l'anglais, et passer lang="de" restaure la précision complète : le modèle va donc bien, pas le routage. C'est un écart de 20 points sur du texte court en écriture latine, décidé par une heuristique qui affiche une confiance totale tout en se trompant.
Ce que personne n'a produit, c'est la comparaison que la plupart des lecteurs attendent :
Accuracy and calibration claims for laya-mlx haven't been independently verified against a shared benchmark like JevBench; the published numbers cover latency, throughput, and memory only.
Remarquez ce que cela laisse de côté. Chaque mesure ci-dessus compare du local à du local — le Neural Engine face au MLX compilé sur le même laptop, une question à la fois. Personne n'a publié d'aller-retour hébergé mesuré à côté, si bien que « plus rapide que l'API » reste la prémisse de départ de ces projets plutôt qu'un résultat que l'un d'eux rapporte.
L'intégrer dans quelque chose qu'on livre
Le chiffre de 5 ms tient pour des décisions courtes, de forme fixe, et cesse de tenir dès qu'on sort de la boîte :
A separately exported FP16 ANE L1024 graph passes the complete 63/63 fixture, but an actual 1024-token request takes about 91.7 ms in its serial screen.
Dix-huit fois la latence. Le projet tire lui-même la conclusion :
The short ANE result does not establish a long-context advantage.
La version déployable est donc un petit prompt fixe, une liste d'options courte, une sélection de langue explicite plutôt qu'un routage automatique, et des températures que vous avez vous-même ajustées sur vos propres données étiquetées après conversion. Budgétez l'étiquetage. C'est là le véritable coût d'intégration, pas l'export.
La forme qui sous-tend tout cela est un portail : une décision typée est un classifieur, et un classifieur gagne sa place en amont d'un travail plus lent, si bien que la plupart des entrées n'atteignent jamais l'appel modèle, le scraping ou la personne. Sur un laptop, le portail est le bundle Core ML, et l'économie tient au fait que la chose coûteuse n'est jamais sollicitée. Dans un pipeline hébergé, le portail est plutôt la première étape à l'intérieur de l'exécution, et c'est une forme à laquelle le compteur de Latenode convient : il compte les secondes CPU qu'une exécution consomme réellement — le temps d'exécution, pas le nombre de nœuds ni d'appels API — et il n'y a pas de frais minimum par exécution, si bien qu'une exécution qui s'arrête au portail est facturée pour les secondes qu'elle a passées plutôt que comme une exécution complète. L'étape qui fait office de portail est un nœud ordinaire : l'un des quelque 335 modèles du catalogue, ou un nœud JavaScript, capable d'installer n'importe quelle bibliothèque NPM. Le palier gratuit inclut 10 000 secondes CPU par mois et cinq workflows actifs. Rien de tout cela ne fait tourner le bundle ANE, qui reste sur le laptop ; ce qui se déplace entre les deux, c'est la forme, pas l'artefact.
Qui devrait porter cette semaine
Portez-le si vous avez une décision fixe, à faible cardinalité, dans une boucle sur silicium Apple, si votre prompt et vos options tiennent dans 96 tokens, si vous pouvez indiquer la langue plutôt que de laisser le routeur la deviner, et si vous disposez d'exemples étiquetés pour réajuster la calibration. Vérifiez quel checkpoint amont votre bundle transporte avant de promettre à quiconque un chiffre de précision — le portage indique explicitement que ce qu'il a converti est la famille généraliste, et la famille généraliste n'est pas la ligne qui bat le teacher. Pour ce lecteur, les chiffres de vitesse et d'énergie sont réels et reproductibles, ce qui est plus que ce que la plupart des affirmations on-device réussissent à faire : 4.98 ms, 0.154 J, mesurés par capteur, avec 65,598 appels derrière eux.
Passez votre chemin si vous espériez remplacer un endpoint de décision hébergé par ceci en gardant tout le reste identique. Le travail publié ne soutient pas cet échange — aucune comparaison sur benchmark partagé n'existe, les probabilités livrées sont mal calibrées tant que vous ne les corrigez pas, et le routage automatique coûte silencieusement 20 points sur du texte court en écriture latine non anglais. Il y a aussi un plafond au nombre de labels que vous pouvez demander :
I've found they start to fail the more classifications you have, long before your typical ML classifier.
Si vous évaluez ceci comme une architecture plutôt que comme un package, la lecture honnête est plus étroite que ce que suggère le nombre d'étoiles : les preuves soutiennent le fait de placer une seule décision petite et bien spécifiée sur le Neural Engine à un coût connu par appel, mais elles ne soutiennent pas encore le fait d'y placer votre jugement.
Voici l'état des choses au 22 septembre 2026. Les projets évoluent vite : vérifiez la source avant de vous y fier.
Questions fréquentes
- laya-coreml est-il une release officielle d'Apple ou de Convai ?
Non. Le README le décrit comme un portage indépendant sous licence Apache-2.0 et précise clairement qu'il ne s'agit pas d'une release officielle de Convai Innovations ou d'Apple. Considérez les poids et le harnais de benchmark comme un travail communautaire accompagné d'un fichier NOTICE, pas comme un SDK éditeur avec un canal de support.
- La variante W8 rend-elle le modèle nettement plus rapide ?
À peine. Elle affiche 4.88 ms P50 contre 4.98 ms pour FP16 - 1.42× contre 1.39× face à MLX compilé. Le gain se situe du côté de la consommation, 27.39 W contre 30.75 W de tirage système moyen, et de la taille du paquet. Le README avertit que la réduction de taille du paquet n'est pas un ratio de vitesse, car W8 compresse les poids alors que le calcul reste en FP16.
- L'export longue contexte tourne-t-il lui aussi sur le Neural Engine ?
Pas par défaut. L'export Core ML SDPA ordinaire et le graphe ANE sont deux implémentations distinctes, et l'export ordinaire bascule par défaut sur CPU+GPU après que les formes GPU RangeDim non restreintes ont échoué aux contrôles de fidélité locaux du projet. Changer son paramètre de device ne reproduit pas le résultat ANE - le chemin ANE est une réécriture utilisant des activations BC1L, des projections 1x1 et une attention par tête.
- De quoi ai-je réellement besoin pour réajuster la calibration ?
Des exemples étiquetés issus de votre propre trafic, répartis par type de question et nombre d'options, avec une température ajustée par lot après la conversion plutôt qu'avant. Rien dans le portage ne fait ça à votre place. Deux choses aident pendant le travail : les valeurs non écrêtées restent accessibles via agent.temperature_raw et agent.temperature_by_options_raw, et un RuntimeWarning au chargement nomme chaque lot que le portage a dû écrêter.
- 0.154 J signifie-t-il que la puce consomme 0.154 joule ?
Non. C'est une estimation à l'échelle du système entier, tirée directement des relevés du capteur SMC PSTR, elle inclut donc tout ce que faisait par ailleurs le laptop, et le README signale l'incertitude liée au capteur et à la charge de fond. Le chargement et l'échauffement sont exclus du chiffre par décision, ce qui compte si votre processus est de courte durée.
- Puis-je compresser en dessous de 8 bits pour tenir sur un appareil plus petit ?
Pas avec les poids publiés. Les expériences du portage en six et quatre bits ont échoué au seuil de dérive de probabilité calibrée de 0.02 et n'ont jamais été publiées ; W8, avec une dérive de 0.014393, est le plancher qu'il a accepté de livrer. Notez que W8 compresse les poids alors que le calcul reste en FP16, ce qui n'est pas la même opération que la quantification des activations - le point où les autres runtimes ont dérapé.