
Nimble : 2,676 exemples pour arriver à trois points de Jev
Publié le 22 septembre 2026
Une recette, pas un endpoint de plus
Bespoke Labs a publié nimble le 18 septembre : un adaptateur LoRA qui transforme Qwen3.5-9B en modèle de décision typée — choisir un candidat parmi ceux-ci, appliquer cette politique, noter ceci par rapport à ce référentiel — et, plus utile encore, l'ensemble du pipeline qui l'a produit. Code de curation, configuration d'entraînement, harnais d'évaluation, le tout en Apache 2.0. L'adaptateur lui-même pèse environ 165 MiB et nécessite le modèle de base de 18 GB à ses côtés.
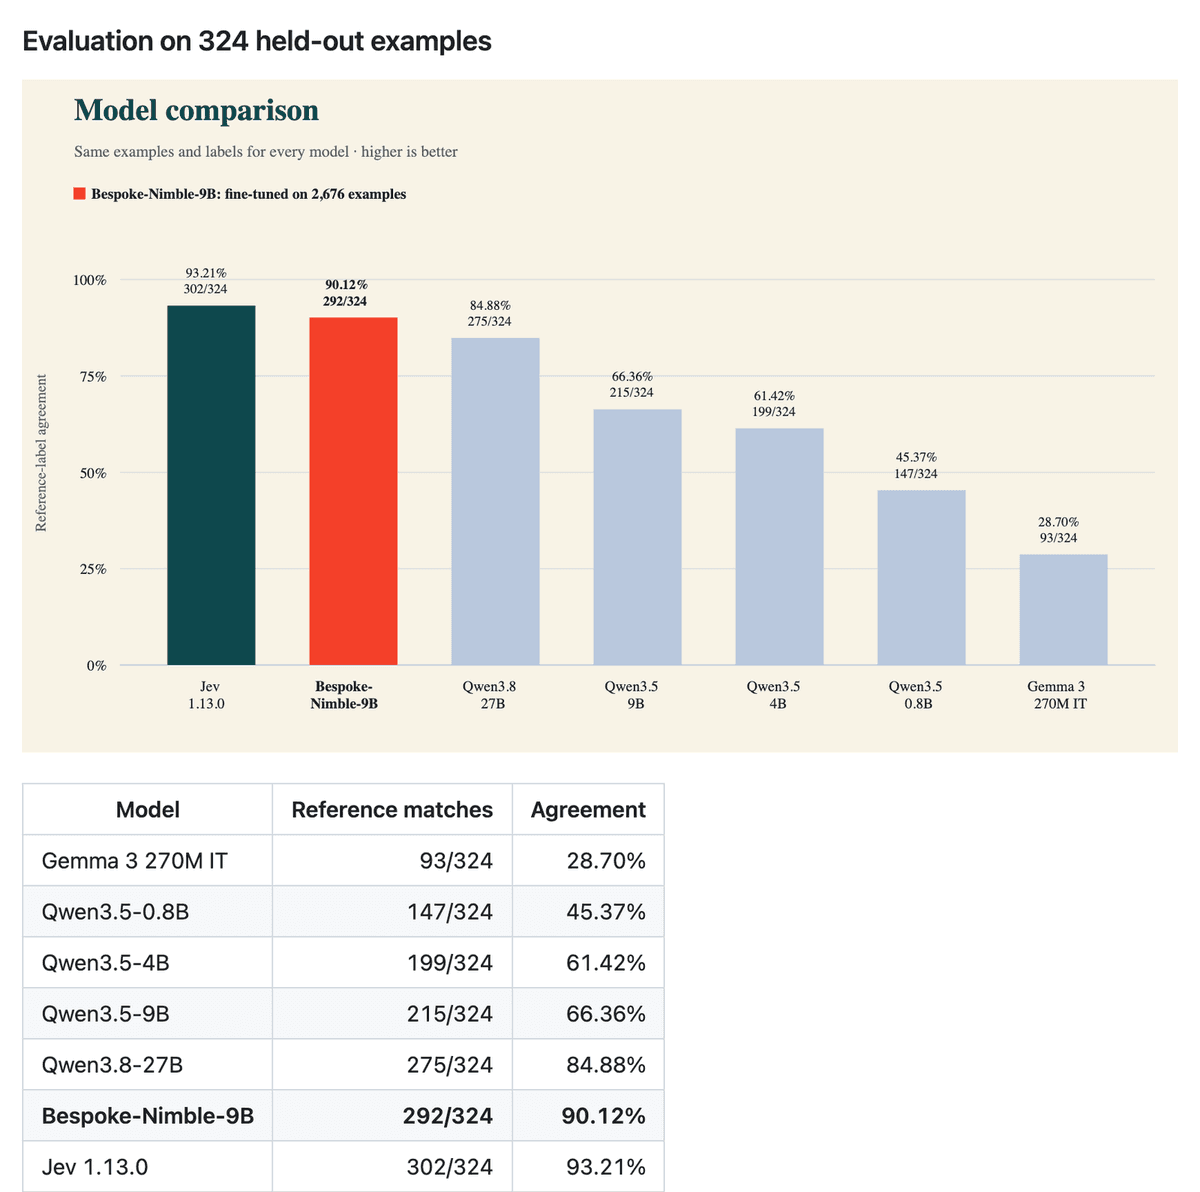
Ce que cela change pour un lecteur, c'est l'arithmétique d'une question sur laquelle on débattait sans chiffres : ce que coûte le fait d'arrêter d'appeler le modèle de décision de quelqu'un d'autre. Sur l'ensemble réservé et figé de 324 exemples du projet, le fine-tune concorde avec le label de référence 90.12% du temps. Le Jev 1.13.0 de TypeSafe obtient 93.21% sur les mêmes exemples. Le modèle de base non affiné obtient 66.36%. Le LoRA comble donc l'essentiel d'un écart de 26.85 points et en laisse trois sur la table.
Note that we did not distill from Jev.
Cette phrase travaille pour de vrai. Elle signifie que la recette est une recette et non une copie, et que les trois points sont le coût de la construction de vos propres données d'entraînement plutôt que le coût d'une imitation à perte.
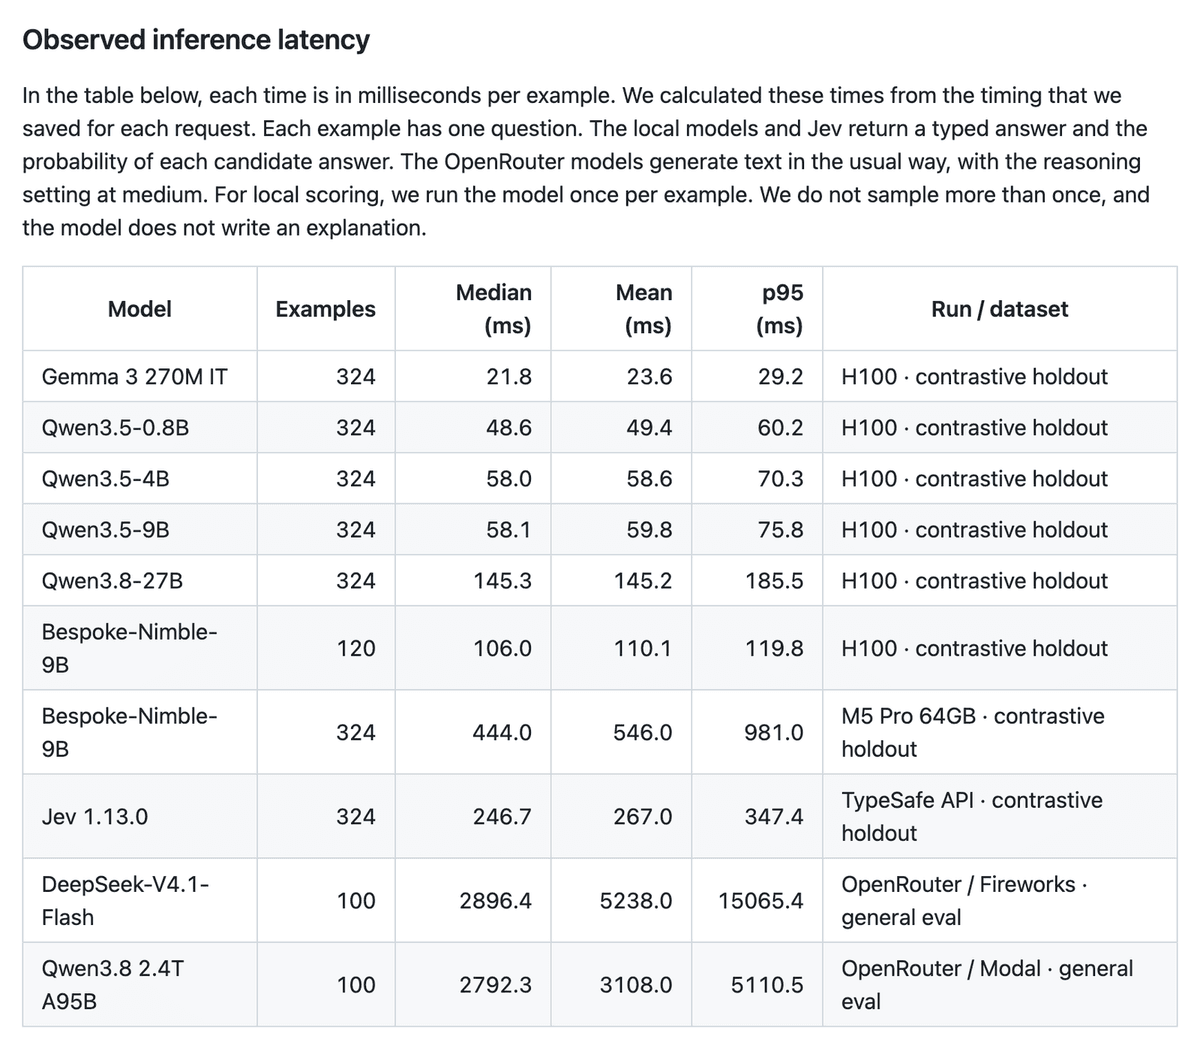
En local, il est aussi plus rapide que l'appel qu'il remplace, avec la réserve imprimée dans le même tableau. Médiane de 106.0 ms par exemple sur un H100 contre 246.7 ms via l'API TypeSafe. Sur un M5 Pro 64GB, le même adaptateur prend 444.0 ms médian, 546.0 moyen, 981.0 au p95 — ce qui marque la fin de la version « ordinateur portable » de l'argumentaire. Plus haut dans le même tableau, le Qwen3.5-9B de base non affiné tourne à 58.1 ms sur les 324 exemples, et le dépôt n'explique pas ce que l'adaptateur y ajoute. Le chiffre rapide ne repose pas non plus sur le même échantillon que tout ce à quoi on le compare.
Their recorded times are also not from a controlled serving test.
La partie de la vague qui a montré son travail
Jev est sorti fermé, et septembre s'est rempli d'imitations — une revue d'AINews cette semaine en a recensé six et a deviné leurs architectures, parce que deviner était tout ce que quiconque pouvait faire. Presque toutes ont publié un chiffre de vitesse et un endpoint.
a lot of demos emphasized speed more than quality, and there is still no standard benchmark for this category.
Nimble est l'entrée qui a livré, à la place, l'étape coûteuse : la manière dont les données d'entraînement ont été fabriquées. Bespoke appelle cette méthode la curation de données contrastive. Vous écrivez deux exemples presque identiques.
They differ in one relevant fact, and this difference changes the correct answer.
L'exemple documenté est une politique de remboursement où seule Mira peut autoriser les remboursements sur un compte ; la version appariée remplace le nom figurant sur l'autorisation signée par Noah, et la bonne réponse bascule de vrai à faux. Tout le reste — la question, la politique, la formulation — reste inchangé. Le pipeline impose cela via un contrôle mécanique de localité : chaque paire proposée peut modifier une seule phrase et huit mots séparés par des espaces au maximum, mesurés par un diff de tokens. Des appels de modèle distincts vérifient ensuite les faits dans chaque exemple, et un test de suppression confirme que retirer l'une ou l'autre phrase de preuve laisse le fait central véritablement inconnu.
Cela a produit 2,676 exemples répartis sur dix catégories thématiques, générés avec GPT-5.6 Terra et vérifiés avec GPT-5.6 Sol, puis une seule époque d'entraînement LoRA — 335 mises à jour de l'optimiseur à une taille de batch effective de 8. Le tuning a tourné sur L40S ; l'ajustement final a tourné sur un H100. Le tout s'est assemblé à la vitesse à laquelle la semaine avançait.
We built Nimble in one day, so expect some rough edges.
Là où il perd est plus utile que de combien
Le README vous renvoie vers une comparaison externe : treize sous-ensembles publics, étiquetés par des humains, hors des catégories d'entraînement, les deux modèles notés sur les mêmes enregistrements.
That is a gap of 1.2 macro points in Jev's favour across tasks that are all outside Nimble's training categories.
— Nimble public benchmarks guide
74.8% macro contre 76.0%. Cet écart est le chiffre que tout le monde citera, et c'est la ligne la moins informative de la page.
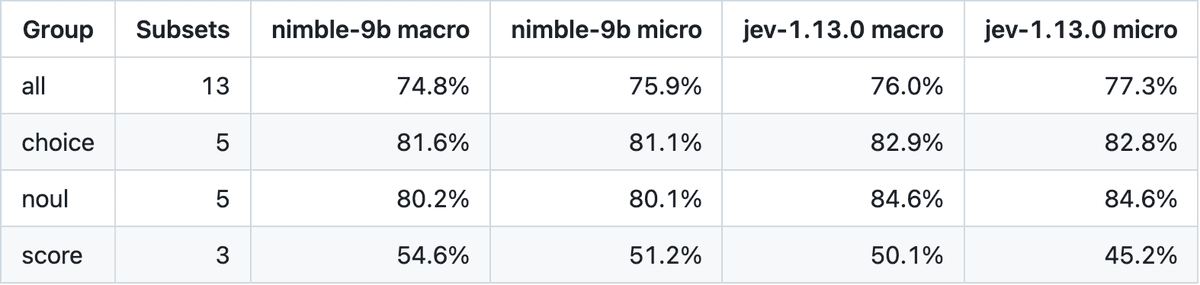
Réparti par groupe, le fine-tune perd choice 81.6 à 82.9 et perd noul 80.2 à 84.6, et gagne score 54.6 à 50.1, avec des chiffres micro encore plus écartés à 51.2 contre 45.2. Lu comme trois résultats, cela dit qu'un modèle entraîné sur 2,676 exemples faits maison bat le fournisseur sur la notation par référentiel et le suit sur la classification. Le tableau de précision par sous-ensemble, imprimé au-dessus de ces moyennes, dit quelque chose de plus étroit et de plus utile, parce qu'il porte une valeur p de McNemar sur chaque ligne. La victoire du groupe score ne tient qu'à un seul jeu de données : summeval-relevance à 49.2 contre 35.0, p=0.0004, tandis que helpsteer2 n'est écarté que de 4.9 points à p=0.3232, ce qui n'est pas significatif, et le fine-tune perd le troisième sous-ensemble du groupe score, summeval-consistency, 75.7 à 81.2. Le déficit de 1.3 point du groupe choice, quant à lui, fait la moyenne de deux pertes significatives — massive-de-DE à p=0.0169, vitaminc-dev à p=0.0125 — contre une victoire qui n'est pas significative. La version honnête de cette répartition n'est donc pas « gagne sur la notation par référentiel » : c'est qu'un seul jeu de données de résumé porte l'unique victoire sans ambiguïté, et que les pertes qui survivent à un test de significativité sont réparties sur les sous-ensembles de classification.
La répartition du même ensemble d'entraînement par type de tâche dans le README suggère une cause plutôt qu'une coïncidence. Score est le bloc le plus important avec 932 exemples, contre 888 pour Noul et 856 pour Choice. Le modèle est le plus fort, par rapport au fournisseur, sur le type de tâche qu'il a le plus vu.
Une ligne mérite d'être sortie entièrement des moyennes. paws est le huitième des treize sous-ensembles : un brouillage adversarial de mots, où deux phrases partagent la plupart de leurs mots mais signifient des choses différentes. Type noul, 250 enregistrements. Le fine-tune obtient 82.8%, Jev 89.2%, et la page marque la différence comme significative à p=0.0025. Cet écart de 6.4 points est plus large que n'importe laquelle des moyennes de groupe, et il tombe sur une tâche construite exactement comme les données d'entraînement : des paires de phrases minimalement différentes qui signifient des choses différentes. PAWS est l'idée même de la curation contrastive, écrite comme un test adversarial par d'autres personnes. L'affirmation la plus distinctive de la méthode est la plus faible sur la tâche pour laquelle la méthode existe.
Les auteurs sont sans détour sur les limites de tout cela.
We trained Bespoke-Nimble-9B on 2,676 examples that we curated. So it's performance will depend on this data and the domains it comes from.
(Les fautes de frappe sont les leurs, et trahissent la construction en une journée.) La portée par domaine est encore plus étroite que ne le suggère cette phrase, et le README en imprime la raison sous forme de tableau : un compte d'entraînement et un compte réservé pour chacune des dix catégories.
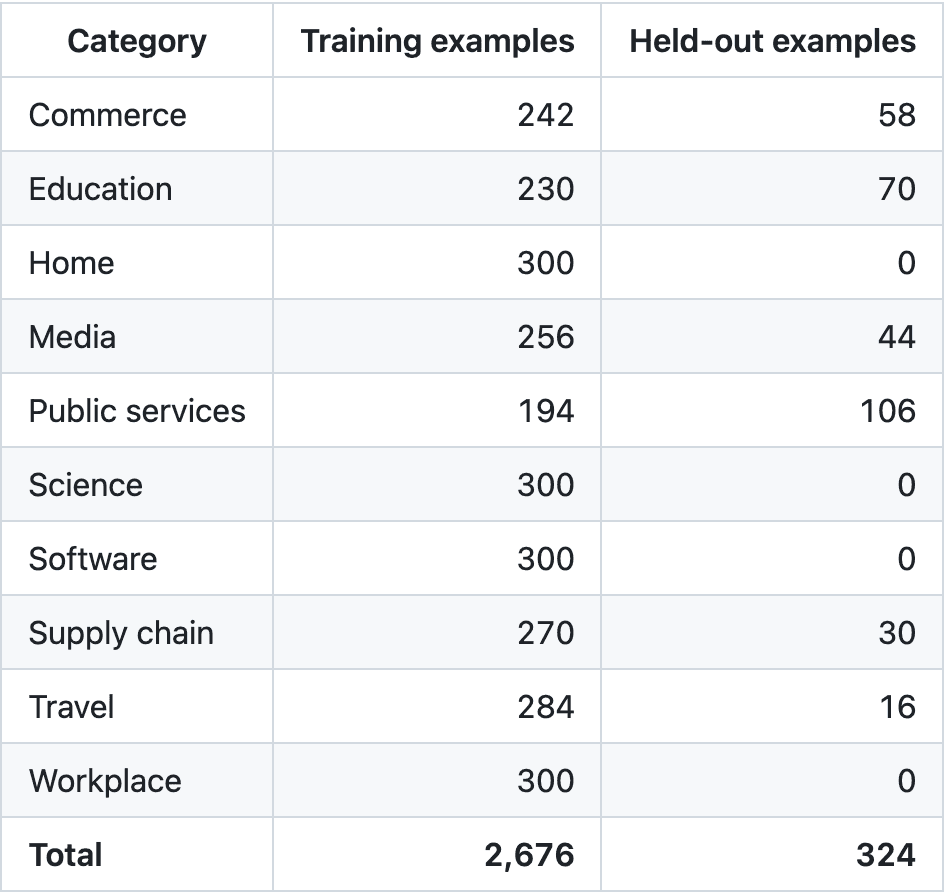
Quatre des dix comptes réservés sont à zéro : Home, Science, Software et Workplace, à 300 exemples d'entraînement chacun. L'évaluation entière sur 324 exemples provient des six autres — Public services 106, Education 70, Commerce 58, Media 44, Supply chain 30, Travel 16. Le 90.12% est donc mesuré sur six dixièmes de la surface sur laquelle le modèle a été entraîné, et les quatre dixièmes non mesurés sont les quatre plus gros blocs d'entraînement de l'ensemble. Pas faible : non rapporté.
En dehors du projet, la critique porte sur l'origine même des labels.
Of course, not enough people are talking about the data side, which is acknowledged to be 100% synthetic.
« Reconnu » est le mot juste, et cette reconnaissance est d'une lucidité inhabituelle :
All of the labels are synthetic: a model checked them, and no person has reviewed them.
Le README ajoute la raison pour laquelle cela mord : des appels distincts au même modèle peuvent commettre la même erreur, si bien que la vérification peut manquer ce que le générateur a mal fait. Les données d'entraînement et les données d'évaluation ont été produites par la même famille de générateurs, ce qui signifie qu'un angle mort partagé ferait monter le score et baisser la précision en même temps, sans que rien dans le dépôt ne le montre.
L'ensemble réservé est petit d'une seconde manière, qui n'a rien à voir avec les catégories. Ses 324 exemples sont 162 paires étroitement liées, et le README compte d'où elles proviennent :
All of them come from only six source families, so this is a narrow test.
Le README ne dit pas si ces six familles correspondent aux six catégories couvertes par le holdout, et le guide des benchmarks utilise « families » dans un sens différent ailleurs — un décompte de documents sources derrière un sous-ensemble, comme les 31 derrière les 299 enregistrements de squad2. Dans tous les cas, le mot que l'auteur emploie est le bon : étroit.
Deux critiques indépendantes affinent cela en quelque chose de testable. Un ingénieur qui benchmarkait Jev dans un harnais d'agent a trouvé le mode de défaillance qu'une garantie de schéma ne peut pas détecter :
High confidence means the model is sure it applied your definition — including your mistakes
— Benchmarking Jev in an agent harness, DEV Community
Ils rapportent des routages erronés arrivant avec une confiance de 1.0. La fidélité à votre schéma n'est pas la justesse, et un fine-tune hérite de vos définitions de manière plus littérale qu'un modèle fournisseur ne le ferait. Séparément, un groupe de Johns Hopkins a mesuré ce qu'une comparaison fondée uniquement sur les labels dissimule : sur 588 résultats, chaque label final était correct tandis que 581 résultats en aval étaient exacts.
the workflow can return the expected verdict while passing an incorrect quantity to subsequent analysis.
La concordance avec un label de référence est exactement un score fondé uniquement sur le label. Les deux chiffres phares de Nimble sont de cette nature.
La dernière objection revient sur paws, de la part de quelqu'un qui a un intérêt dans la course. Sur le tracker d'issues du projet, un commentateur publiant sous le nom m0at oppose ses propres discriminateurs de bord à poids nul à Nimble-9B et Jev sur une suite reconstruite de 324 échantillons de BoolQ, MultiNLI et PAWS, et rapporte que son implémentation atteint 100% à une latence sous la milliseconde. Traitez une comparaison auto-exécutée sur une suite auto-reconstruite avec le scepticisme qu'elle appelle. La partie mécanique de l'argument survit à qui la formule :
Base small models struggle significantly on PAWS (Gemma 3 at 41.2%, Qwen 3.5 at 45.4%)
— m0at, bespokelabsai/nimble issue #3
La raison avancée est que le chevauchement d'unigrammes entre les deux phrases dépasse 85%, si bien qu'un modèle qui pèse les mots plutôt que leur ordre n'a presque rien à saisir. C'est une affirmation sur la forme de la tâche plutôt que sur le produit de qui que ce soit, et elle pointe vers le même sous-ensemble où la propre suite de Bespoke enregistre la perte significative du fine-tune.
Using n-gram order sensitivity (specifically trigram Jaccard divergence) reliably discriminates semantic flips without requiring generative rollouts.
— m0at, bespokelabsai/nimble issue #3
Si une statistique de trigrammes sans poids peut séparer les cas où un modèle 9B affiné se trompe, la question intéressante n'est pas de savoir s'il faut posséder le modèle. C'est de savoir laquelle de vos décisions avait besoin d'un modèle, tout court.
Où un modèle de ce genre trouve sa place
Un modèle de décision typée est un classifieur, et les classifieurs sont surtout utiles comme étape de routage devant un travail plus lent : décider d'abord, dépenser ensuite. La question du remboursement ci-dessus en est l'archétype — régler « est-ce autorisé » en un seul appel typé, et ne laisser tourner la branche qui lit des documents, écrit dans un registre ou alerte un humain que lorsque la réponse le dit.
Les chiffres de Nimble changent la forme de la décision construire-ou-acheter plutôt que de la trancher. Si votre trafic ressemble à l'une des six catégories couvertes par le holdout, vous disposez d'un chiffre publié pour argumenter. S'il ressemble à Home, Science, Software ou Workplace, personne n'a publié de chiffre — y compris ceux qui ont entraîné sur ces catégories — et votre premier travail est de construire votre propre ensemble réservé, étiqueté par quelqu'un qui en portera la responsabilité si c'est faux. La méthode de curation se transfère proprement. Les labels ne se transfèrent pas du tout.
Quel que soit le modèle qui finit par trancher, le workflow qui l'entoure reste le même, et cela vaut la peine de le construire pour que le chemin bon marché reste bon marché. Sur Latenode, c'est simple à chiffrer, parce que le compteur mesure les secondes CPU qu'une exécution consomme réellement plutôt que des nœuds ou des appels API, et il n'y a pas de minimum par exécution — si bien qu'une exécution qui classe, prend la branche courte et se termine coûte proportionnellement moins qu'une exécution qui fait le tour complet. Un nœud JavaScript peut installer n'importe quelle bibliothèque NPM, ce qui garde le travail autour d'une décision — parsing, validation, la branche elle-même — comme du code ordinaire plutôt que de la configuration. Le palier gratuit est de 10,000 secondes CPU par mois sur 5 workflows actifs. Jusqu'où cela mène est une question de trafic, pas de compteur.
Qui devrait cloner ceci, et qui ne devrait pas
Clonez-le si vous avez une surface de décision étroite et stable, et le courage d'étiqueter des données : l'actif transférable ici est le pipeline de curation, pas les poids, et l'échelle à laquelle il a fonctionné était de 2,676 exemples sur dix catégories et une seule époque de 335 mises à jour de l'optimiseur. Ce que cela a coûté en heures, le dépôt ne le dit pas. Clonez-le si votre tâche ressemble précisément à la notation de la pertinence de résumés, parce que c'est là que se trouve l'unique victoire sans ambiguïté — summeval-relevance, 49.2 contre 35.0 à p=0.0004 — et c'est un seul jeu de données plutôt qu'une catégorie : les deux autres sous-ensembles du groupe score sont une égalité statistique et une perte. Clonez-le si vous voulez voir à quoi ressemble un modèle de décision avec l'étape des données rendue visible, parce que presque rien d'autre dans cette vague ne la montre.
Passez votre chemin si vous cherchez un remplacement direct de Jev. Il est à trois points derrière sur les domaines pour lesquels il a été construit, à 6.4 points derrière à p=0.0025 sur paws, le sous-ensemble de paraphrase adversariale construit de la même façon que ses propres données d'entraînement, et les auteurs vous disent clairement de ne pas attendre de généralisation. Passez votre chemin si la cible de déploiement est un ordinateur portable : 444 ms médian et 981 ms au p95, c'est un produit différent de 106 ms sur un H100, et le chiffre du H100 a été mesuré sur 120 exemples alors que tout ce à quoi on le compare a été mesuré sur 324. Et passez votre chemin si vous n'avez pas de données étiquetées à vous, parce que ce qui a produit 90.12% était 2,676 exemples curés, pas un rang de LoRA.
Le chiffre qui mérite d'être surveillé n'est pas l'écart de trois points. C'est de savoir si quelqu'un exécutera cette recette sur des données qu'un humain a réellement lues, et rapportera ce qui change.
Voici l'état des choses au 22 septembre 2026. Les projets évoluent vite : vérifiez la source avant de vous y fier.
Questions fréquentes
- Sous quelle licence Nimble est-il publié, et que téléchargez-vous concrètement ?
Apache 2.0. La publication est un adaptateur LoRA d'environ 165 MiB, plus le tokenizer, le générateur de prompts et un code d'inférence de référence. Ce n'est pas un modèle autonome : vous fournissez vous-même Qwen3.5-9B, soit 18 GB ou plus, et vous fusionnez l'adaptateur ou le chargez à côté du modèle de base.
- Quel matériel et quels réglages l'exécution publiée utilise-t-elle ?
Un GPU NVIDIA prenant en charge le BF16 ; le dépôt indique des tests sous PyTorch 2.8.0 avec CUDA 12.8. Bespoke a effectué le tuning sur L40S et exécuté l'ajustement final ainsi que l'évaluation sur un H100. La configuration publiée est un LoRA de rang 16, un taux d'apprentissage de 5e-5, une taille de batch de 2 avec une accumulation de gradient de 4, une limite de prompt de 2,048 tokens et une graine aléatoire de 17 ; le guide d'entraînement fixe le nombre maximal d'étapes à 1,005 avec 101 étapes de warmup.
- Peut-on exécuter l'inférence sur Apple Silicon ?
Oui. Le dépôt mentionne Apple Silicon via MLX en plus de la voie CUDA, et l'évaluation publiée inclut une exécution complète sur 324 exemples sur un M5 Pro 64GB. La contrainte pratique est la mémoire pour le modèle de base, pas pour l'adaptateur, qui est assez petit pour être négligeable.
- Peut-on pointer le pipeline de curation vers un autre modèle générateur ?
Oui. Les valeurs par défaut se trouvent dans le module des profils de curation, et elles sont définies par étape plutôt que globalement : les contrastes d'entraînement et la génération d'évaluation utilisent par défaut des modèles différents, avec un raisonnement respectivement faible et moyen. Modifier l'un ou l'autre implique d'éditer ce module, et rien dans le dépôt n'indique ce qu'il advient des chiffres publiés dans ce cas — un changement vous oblige donc à remesurer les résultats vous-même.
- Un modèle plus gros mais non affiné ferait-il le même travail ?
Pas sur ce test. Sur les mêmes 324 exemples, le Qwen3.8-27B non affiné — trois fois plus de paramètres — atteint 84.88%, soit 5.25 points de moins que le fine-tune 9B, et l'échelle s'effondre rapidement en dessous : Qwen3.5-4B à 61.42%, Qwen3.5-0.8B à 45.37%, Gemma 3 270M IT à 28.70%. Sur les domaines pour lesquels il a été entraîné, 2,676 exemples curés valent plus que trois fois les poids — ce qui plaide en faveur de la recette, et seulement pour ces domaines-là.
- Le modèle explique-t-il ses réponses ?
Non, et c'est voulu. Le scoring local exécute le modèle une seule fois par exemple, sans échantillonnage répété ni justification écrite. Ce qui revient est une réponse typée accompagnée d'une probabilité pour chaque candidat, ce qui la rend assez économique pour tenir dans un chemin critique — et ce qui ne laisse rien à lire quand elle se trompe.