
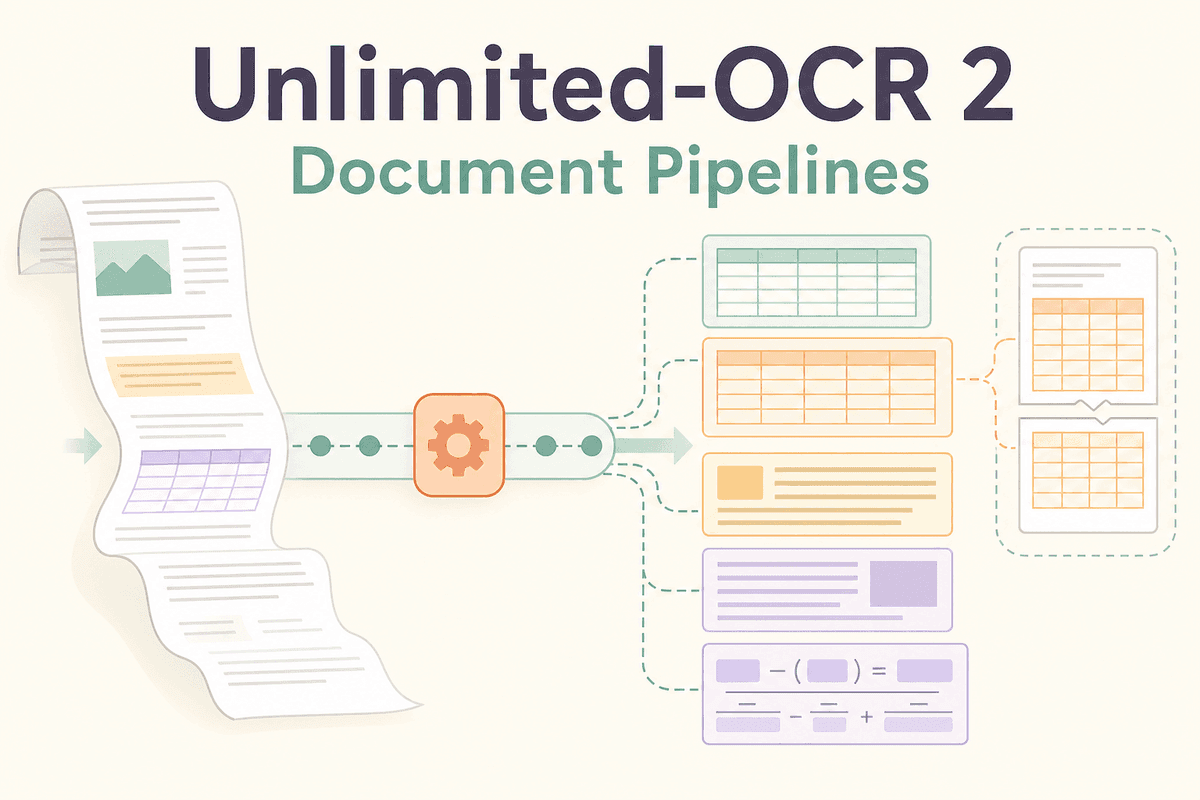
Le 27 octobre 2026, Baidu a mis à jour son parseur de documents cloud pour utiliser Unlimited-OCR 2, rendant ce modèle pour documents longs disponible via une API OCR hébergée, sans que les équipes aient à le déployer elles-mêmes.
Selon la documentation OCR de Baidu Cloud, le service prend en charge les PDF jusqu’à 500 pages et peut renvoyer les résultats analysés au format JSON structuré ou Markdown. Baidu indique qu’il est conçu pour les fichiers riches en structure, notamment la fusion de tableaux sur plusieurs pages, la continuité des paragraphes entre les pages, l’analyse de la hiérarchie des titres et le balisage de mise en page pour des éléments tels que les tableaux et les équations.
L’API utilise un flux asynchrone plutôt qu’une requête bloquante unique. Un client envoie un fichier ou une URL, reçoit un ID de tâche, puis interroge son état avant de récupérer les liens vers les résultats. Cela facilite son intégration dans des workflows d’automatisation qui séparent déjà l’ingestion de l’extraction ou de la vérification en aval.
Côté modèle, Baidu affirme que Unlimited-OCR 2 utilise SR-SWA pour maintenir une latence de décodage et une empreinte mémoire presque constantes à mesure que la longueur des documents augmente ; davantage de détails sont disponibles sur la page du modèle. Pour les builders, le changement concret est l’accès : l’analyse de PDF longs est désormais proposée via l’API gérée de Baidu Cloud.