
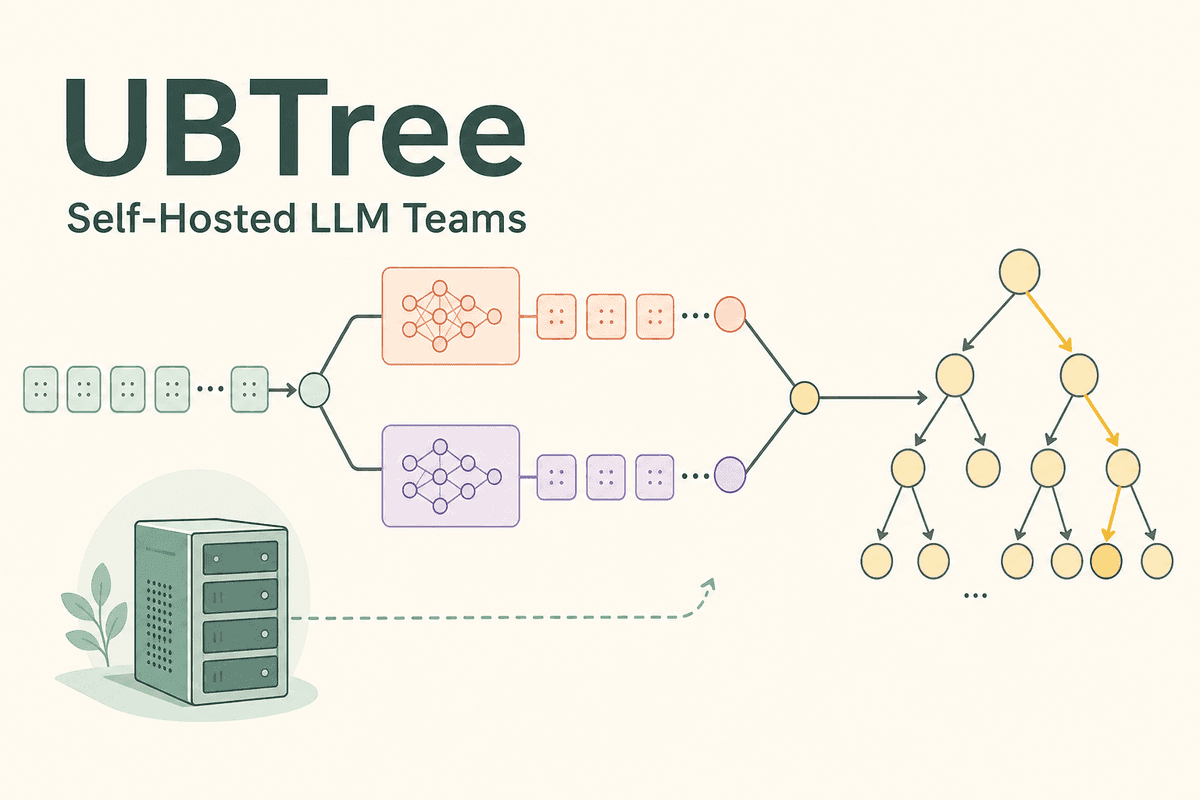
Le 28 octobre 2026, Inclusion AI a présenté UBTree, une méthode de décodage spéculatif pour l’inférence LLM qui construit un arbre de vérification au lieu de s’appuyer sur un seul chemin de draft. Inclusion AI indique qu’UBTree associe un proposeur unigramme à un sélecteur bigramme.
La configuration conserve le travail neuronal dans deux passes avant parallèles, la recherche dans l’arbre étant ensuite effectuée à partir de scores précalculés plutôt que via une passe neuronale supplémentaire. Selon Inclusion AI, cette approche vise deux problèmes des précédents générateurs d’arbres parallèles : le compromis entre les dépendances de tokens et le parallélisme, ainsi que l’écart entre l’entraînement et l’inférence.
Inclusion AI rapporte des accélérations moyennes de 5,84× à 6,94× sur Qwen3-4B et Qwen3-8B, ainsi que de 5,36× sur Ling3-Flash 124B dans SGLang. L’entreprise a également publié des checkpoints de draft UBTree pour Ling-3.0-flash et Ling-3.0-tiny.
La disponibilité reste encore précoce : la prise en charge de SGLang se trouve actuellement sur une branche distincte, tandis que l’intégration en amont est toujours en cours. Pour les équipes qui servent des modèles auto-hébergés, UBTree semble être une piste de décodage concrète à évaluer, notamment pour les charges de travail à contexte long ou à faible concurrence.